AI安全不能只依靠规范模型行为的规则。安全专业人士提出了一个更现实的担忧:当前沿实验室讨论模型风险时,经验丰富的防御人员并不总能参与基础性政策讨论。他们的视角至关重要,因为人工智能系统还依赖数据、代码、权限、网络,以及在出问题时必须作出响应的人员。
模型周边的系统也关乎安全
OpenAI和Anthropic等前沿实验室都在呼吁关注模型安全。但安全讨论可能较少关注访问控制、监控、网络分段和事件管理等常规防御措施。网络分段是指将系统相互隔开,使获得一个系统的访问权限不等于自动获得其他系统的访问权限。
英国国家网络安全中心的一位前负责人对一些极端AI风险情景提出质疑,因为这些情景假定上述基础防御措施不存在。这并不能回答有关未来AI能力的所有问题,但为检验任何安全主张提供了一个有用的标准:它是否考虑了模型实际运行时所处的安全架构?
模型对齐旨在引导模型行为,有其价值,但它类似于员工行为准则:规定系统应该如何行事。它无法取代那些限制系统可访问范围或限制使用者行为的控制措施。让安全分析师和威胁研究人员尽早参与,可能有助于实验室在这些缺口演变成运营问题之前发现它们。
将防御工程融入开发过程
独立审计和红队测试可以发现问题;在红队测试中,测试人员会主动探查系统的弱点。与其在部署后只做一次检查,不如将这些工作持续纳入开发与训练过程。团队需要在模型发布前审查权限、检查系统交互,并测试遏制措施是否有效。
一些实验性测试需要采用物理隔离:让系统与外部网络在物理上分开。如果目标是完全隔离,仅通过软件关闭无线连接,并不等于拆除Wi-Fi、蓝牙和网络接口硬件。当团队测试没有常规行为护栏的模型时,这一区别尤为重要。
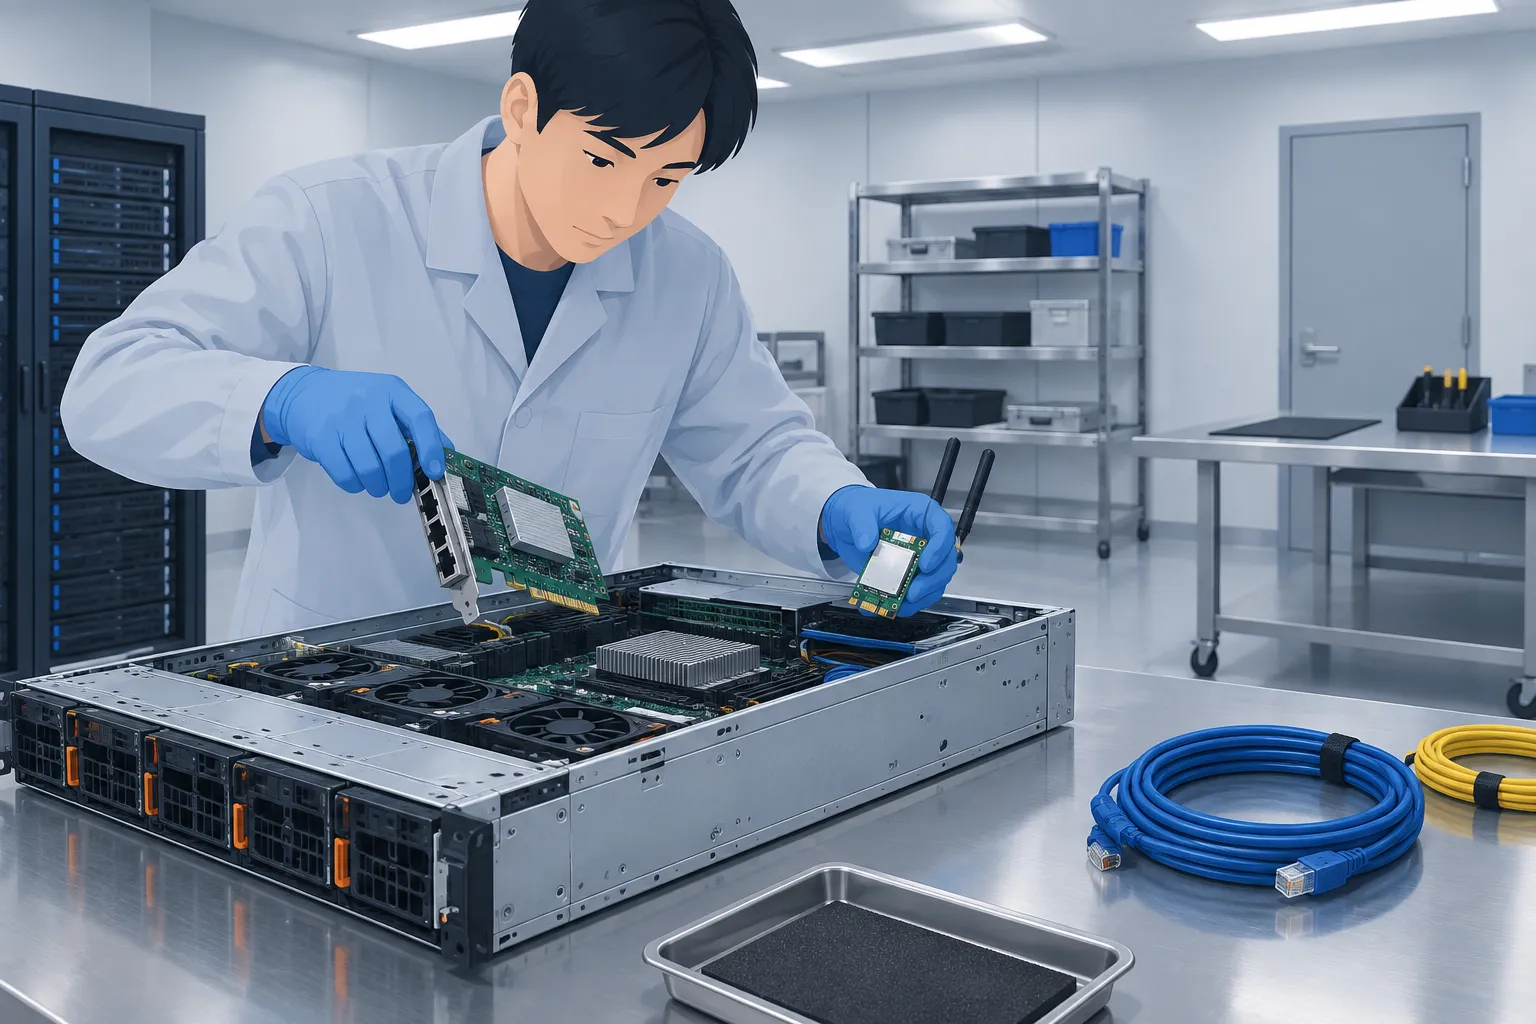
▲ 敏感AI测试的物理隔离
这并不是说每个人工智能系统都需要同等程度的隔离,而是说应根据工作的风险配置控制措施,并核实这些措施在实际中确实存在。安全声明与有效运作的防御系统是两回事。
模型获取方式改变防御格局
一家网络安全初创公司使用中国一家人工智能公司的开放权重模型GLM的修改版本,发现了一个此前未被报告的TikTok漏洞。开放权重模型会提供其模型参数,供其他人调整。据报告,该漏洞可能使人远程干预应用权限,并在未经授权的情况下访问摄像头。
这一案例说明,有能力的工具对防御人员很重要:发现漏洞就有了修复漏洞的机会。限制模型获取可能妨碍一些正当研究,却不能确保恶意行为者没有能力相当的工具。因此,在制定模型获取政策时,需要权衡其对防御工作的影响,而不是假定不受限制地发布模型没有风险。
AI辅助发现也带来了另一项挑战。Palo Alto Networks的一个研究团队报告称,通过自动化分析发现了14,000个漏洞,其中99%被描述为此前未被报告的零日漏洞。零日漏洞是防御人员此前不知道的漏洞。不过,一份数量庞大的发现清单,不等于一份按优先级排列、列出可立即利用威胁的清单。分析师仍须判断哪些警报反映了真实、可采取行动的风险。
▲ 漏洞排查的工作负担
核验需要时间和精力。AI辅助发现可能帮助防御人员更早找到弱点,但也可能让团队疲于处理理论上存在的漏洞。实际目标是足够迅速地确认漏洞能否被利用、确定处理优先级,以支持修复工作,同时避免耗尽负责修复的人员的精力。
事件通报也是防御的一部分
事故发生后,既定安全目标与实际操作之间也会出现同样的落差。CISA、FBI及国际合作伙伴在联合发布的《压力下的沟通》中,敦促组织向受影响者提供有关其面临风险的实用信息,而不是止步于法律要求的最低披露标准。
有用的信息披露并不意味着公开可能帮助他人利用尚未解决漏洞的细节,而是要足够及时地沟通,让合作伙伴和用户了解可能受到什么影响,以及可以采取哪些防护行动。危机期间,当法律和声誉方面的顾虑同时需要权衡时,自愿性指导意见可能难以遵循。当系统和事件跨越国界时,国家层面的规则也有局限。
当前应核查什么
评价AI安全计划,应看其背后的防御措施。构建或部署AI的组织可以提出四个具体问题:
- 安全分析师是否在系统设计和训练期间就已参与,而不是等到发布后才介入?
- 访问控制、监控、网络隔离和事件处置流程,是否与模型行为规则共同发挥作用?
- 团队能否核验AI生成的漏洞发现并确定优先级,同时不让防御人员不堪重负?
- 如果发生事故,组织能否告知受影响者面临的风险,同时避免披露可能助长进一步滥用的细节?
这些问题不能取代更广泛的AI安全研究,却能让其承诺更加具体。尽早将网络安全专业知识纳入讨论,能让实验室更好地把安全承诺与可测试、可遏制、可防御的系统连接起来。