对生产环境中的AI智能体来说,最危险的时刻也许不是推理出错,而是直接按自己的推理去执行。如果智能体判断某个集群不健康,接着又即兴编排出一套重启流程,那么没有任何机制能保证这套流程是正确的。最早在Netflix打造Conductor编排引擎的工程师主张明确分工:由模型决定下一步该做什么,再由一个确定性的执行层,也就是“驾驭层”(harness),决定具体怎么做,而且只能使用事先注册并经过测试的操作。模型是大脑,驾驭层是双手。
生产环境中的大多数智能体并不是聊天机器人
人们熟悉的智能体形象是一个请求与响应的循环:用户发送提示词,机器人调用工具,然后返回结果。客服聊天机器人就是典型例子。但对真实的企业软件来说,这幅图景实在太小了,因为生产环境中的大多数智能体都在无人值守、无人下达指令的状态下运行。只把智能体看作聊天机器人的团队,可能会错过最有价值的后台自动化和事件驱动自动化。
| 智能体类型 | 作用 |
|---|---|
| 后台工作者 | 持续运行,在主线程之外承担处理任务 |
| 定时智能体 | 按固定间隔唤醒,例如每小时检查日程是否出现新冲突,完成后再次休眠 |
| 事件驱动智能体 | 监听告警、日志或Webhook,作出响应后停止 |
| 监控与审核智能体 | 持续评估系统行为和合规情况,并上报异常 |
| 长时运行的协调者 | 在数小时乃至数天内协调多步骤工作 |
| 多智能体系统 | 多个专门化的智能体围绕同一业务成果协同工作 |
越是无人在场,由什么来控制执行这个问题,似乎就越会变成一个安全问题。
智能体是组件,驾驭层才是应用
这种设计与微服务如出一辙。企业不会只交付一个试图包揽全部应用逻辑的服务,而是运行许多职责单一的服务,再由上层的编排层管理状态、路由、策略和故障恢复。智能体正在走同样的路。单个智能体循环只是一个组件,而不是一个应用。真正的应用是驾驭层,它把智能体与人、数据库、API和MCP服务器连接在一起。MCP即Model Context Protocol,是把AI模型接入外部工具的一种标准方式。
拆分工作还能抑制幻觉,也就是模型生成看似合理但实际错误内容的倾向。让一个智能体承担所有运维步骤,会大幅提高这种风险。
两类工作
智能体系统内部的工作可以分为两类。
- 非确定性工作,由智能体负责: 规划、推理、分类、摘要、选择下一步以及重新规划
- 确定性工作,由驾驭层负责: 支付、云基础设施的资源配置、法务审批、合规审计、回滚,以及跟踪服务水平承诺的SLA计时器
后一类工作绝不能由概率性的模型凭幻觉或即兴处理。重启Kubernetes集群就是一个好例子:每次重启都必须按同样的顺序执行同样的验证和部署步骤。智能体完全可以合理地判断需要重启,但重启如何进行,必须由驾驭层严格控制。在生产环境中,驾驭层还应加入人工审批关口,例如在执行任何破坏性操作之前,先通过Slack消息请工程师批准。相信模型会不出差错地遵守安全策略是不安全的,执行约束应当写进代码。
| 由智能体决定 | 由驾驭层决定 |
|---|---|
| 做什么 | 允许做什么 |
| 为什么做 | 已经发生了什么 |
| 计划如何随变化调整 | 重试、审批和执行顺序 |
| 幂等性,即重复执行某个操作与只执行一次效果相同 | |
| 补偿,即为撤销另一个操作而注册的操作 |
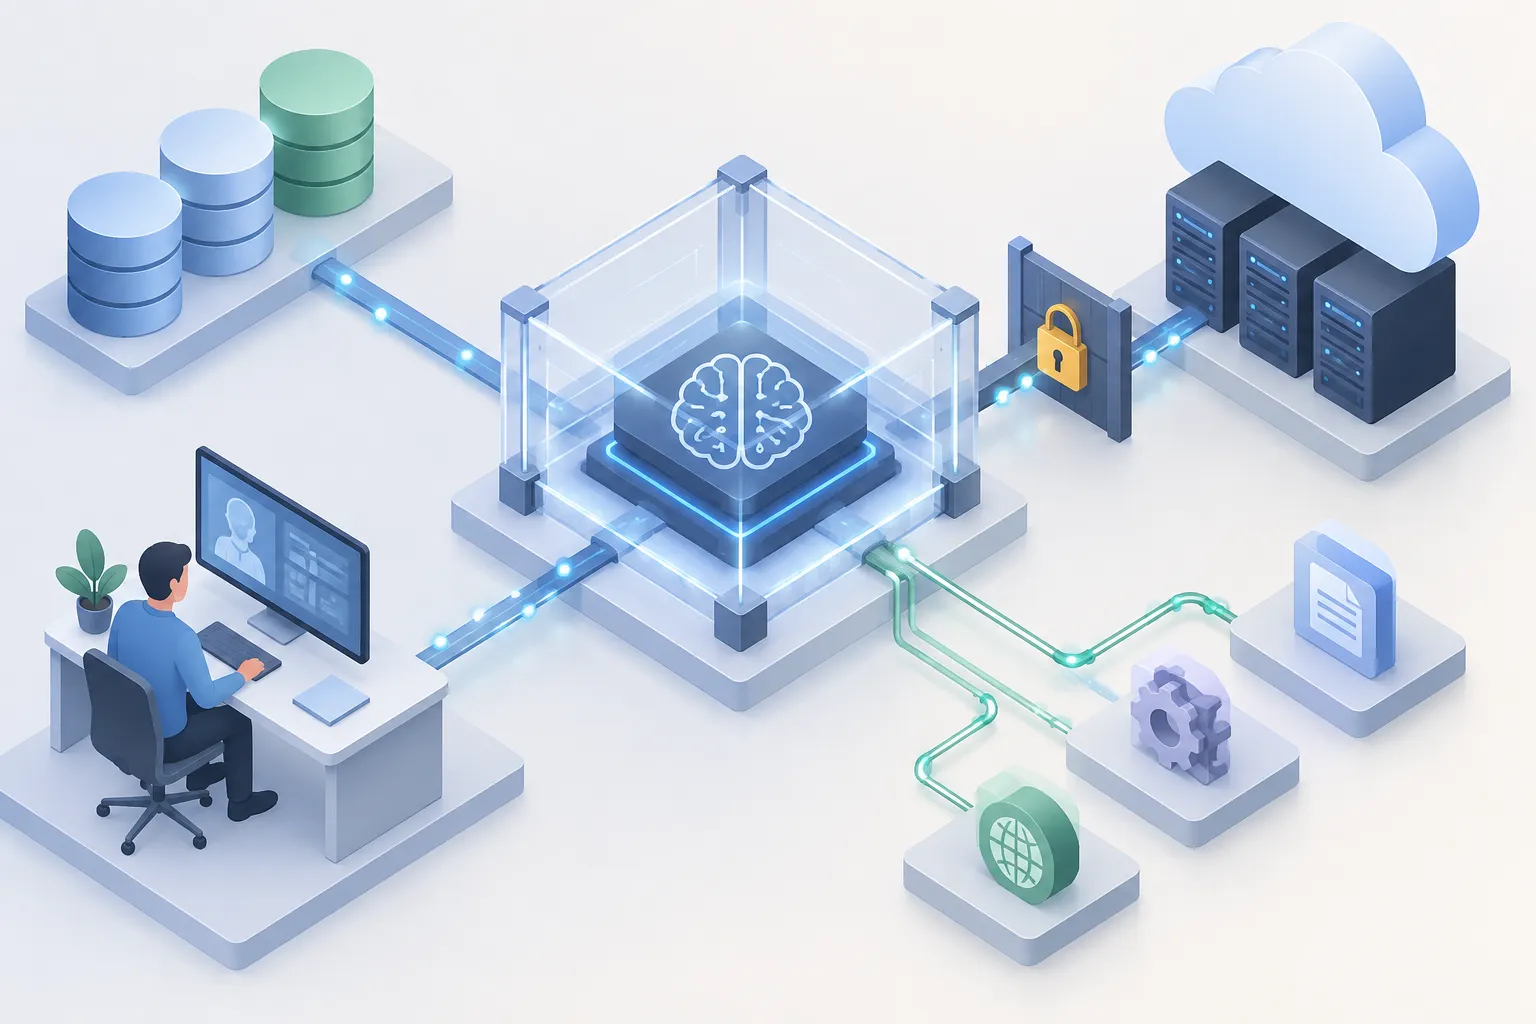
▲ 包裹智能体的驾驭层
持久性是入场门槛
生产环境中的智能体工作流无法在一次HTTP请求内完成,它们会运行数小时、数天、数周甚至数月。例如,一个订单管理工作流可能要花数天到数周等待承运商和仓库的审批。在此期间,驾驭层必须等待人工审核、响应异步事件、按计划触发任务,并从崩溃中恢复。在分布式云基础设施上,网络分区、容器崩溃和硬件故障都在所难免。
因此,持久化执行是基本要求,而不是锦上添花的功能。运行时必须能够从中断处精确恢复,既不重复工作,也不丢失状态。
由此引出第二条规则:重新规划只能改变未来,永远不能改变过去。已完成的工作、副作用、审批记录和已暴露的失败,都会锁定在持久化存储中。一旦出现意外,驾驭层会把当前状态反馈给智能体,智能体再从这一状态出发规划新的步骤。真正有用的控制循环不在智能体的提示词链内部,而在外部边界上,在那里,现实世界的结果成为智能体的反馈。
规划自由,词汇固定
如果智能体在运行时编写新计划,驾驭层又如何保证一个从未见过的计划会怎样运行?答案是有限的“字母表”:规划保持开放,但可执行操作的集合在部署时就已注册。这种模式被称为late-bound saga。saga传统上是人工编写的确定性工作流,而在这里,智能体在运行时从预先注册的目录中串联任务。
每个会改变状态的操作,都要注册一个能将其撤销的补偿任务。
| 操作 | 注册的补偿操作 |
|---|---|
| 触发断路器 | 重置断路器 |
| 配置容量 | 释放这部分容量 |
这与分支式工作流不同。在封闭世界的分支流程中,每条路径都必须在部署时画好,规划器只能从现有分支中选择。late-bound saga则是开放世界的:智能体可以把可用工具组合成新的搭配,工程师也不必把未来所有路径都硬编码。考虑到事先确定运行时的所有排列组合几乎不可能,这看起来是在灵活性与可靠保证之间的一种务实折中。
故障响应智能体如何一步步工作
一个SRE修复智能体的演示,展示了各个部分如何组合在一起。所谓SRE修复智能体,就是响应站点可靠性事件的智能体。演示场景为了保证一致性而事先准备,但流程本身很有参考价值。
- 把现有智能体接入驾驭层。将智能体的行为映射到已注册任务,大约需要12行代码。
- 在第一轮循环中,智能体检查日志证据并查询指标。
- 模型接收这些上下文,返回一份结构化的JSON计划,列出要执行的任务。
- 编译工具把计划转换成可检查的DAG,即标明步骤及其顺序的有向无环图,再由Conductor执行。
- 计划回滚失败的服务部署,并持续查询指标以确认恢复。每个步骤都从进行中变为已完成,并留下完整的执行记录。
- 在下一轮循环中,智能体看到已恢复的状态,确认回滚成功,于是不再重复回滚并结束。
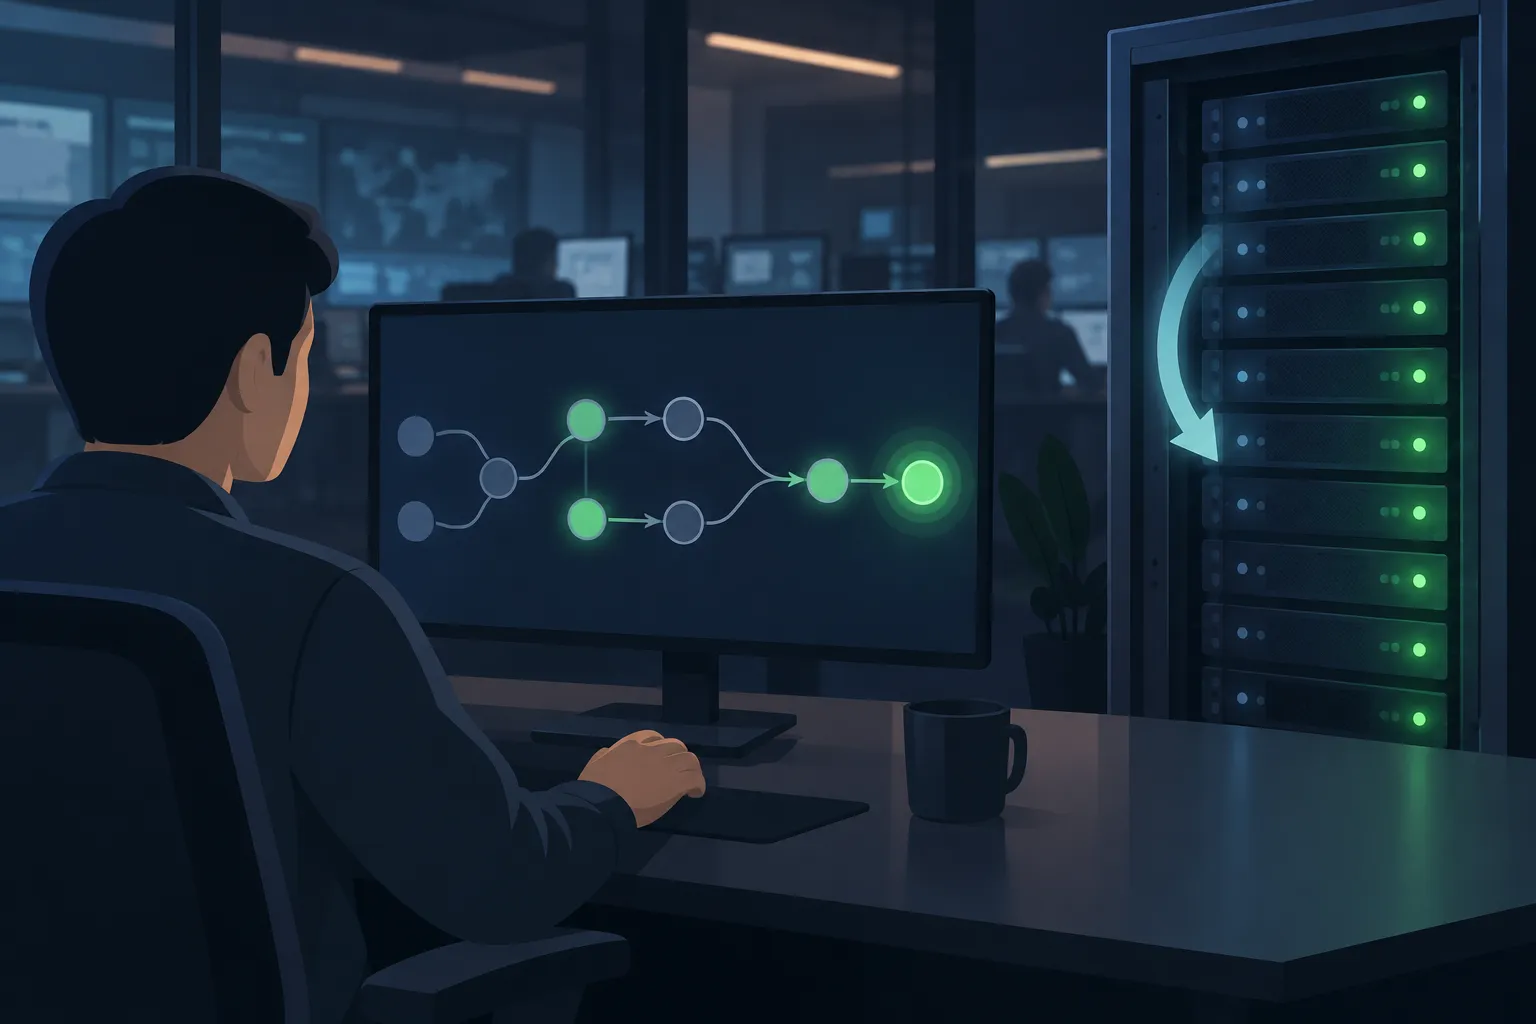
▲ 回滚与恢复确认流程
Conductor是一款最早在Netflix构建、以Apache 2.0许可证发布的开源编排引擎。它在持久保存状态的同时运行智能体工作流、长时循环和微服务编排,并可与基于LangChain、OpenAI Agents SDK或自定义SDK构建的智能体协同工作。
生产环境智能体安全检查清单
核心思路很简单:把判断交给模型,把执行交给确定性的代码。如果你正在运行或计划部署定时、事件驱动或长时运行的智能体,请检查以下几点。
- 业务逻辑已拆分为模型推理步骤和确定性任务,没有混在同一个提示词循环里
- 模型无法直接执行支付、集群重启或合规执行
- 智能体只能从预先注册的操作中选择,无法生成任意命令
- 每个改变状态的操作都定义了补偿任务
- 生产环境中的高风险操作需经过人工审批步骤,例如通过Slack审批
- 已完成的工作和副作用保存在不可更改的记录中,重新规划只会改变后续步骤
- 模型计划在执行前被编译成可检查的DAG,因而可以追踪并安全重放
- 执行层能够承受网络中断、机器重启和长时间等待