苹果宣称 M5 Ultra 的速度最高可达 M3 Ultra 的四倍,本地 AI 测试中也有相应表现:部分大语言模型开始响应的等待时间缩短至旧款芯片的约四分之一。但这并不意味着每次回答都能以四倍速度完成。一旦模型开始输出文字,实测速度提升通常更接近 1.5 至 1.7 倍。对于考虑升级 Mac Studio 的用户,这两个阶段的差别比单一的性能数字更重要。
两台 Mac Studio 的测试配置
测试将两台 Mac Studio 用作无头本地 AI 服务器,即运行时不直接连接显示器或键盘。模型均离线运行,不接入互联网,也不调用云端 API。M3 Ultra 配备 512GB 统一内存,M5 Ultra 则配备 256GB,因此两台机器的内存配置并不相同。
两台机器均有 80 个 GPU 核心。M5 Ultra 在每个 GPU 核心中加入了 Neural Accelerator,并将内存带宽——即数据在内存与处理器之间传输的速率——从 819 GB/s 提升至 1.2 TB/s。它还配备 36 个 CPU 核心,而 M3 Ultra 为 32 个。这些硬件变化有助于理解测试结果,但测试也表明,AI 任务不同环节获得的性能提升并不一样。
首个 token 更快出现,不代表后续文字同样快
首 token 时间(TTFT)衡量模型收到提示词后,多久开始回复。token 生成速度则衡量它随后输出文本片段的快慢。主要的大语言模型对比使用了 32,000 个 token 的提示词;token 是模型处理的文本片段。Qwen 模型采用 4-bit 版本,以更紧凑的形式存储模型权重。
| 本地模型 | 首个 token:M5 Ultra 对比 M3 Ultra | 生成速度:M5 Ultra 对比 M3 Ultra |
|---|---|---|
| Qwen3.8 27B,4-bit | 21.66 秒对 82.85 秒 | 43.3 token/秒对 28.1 token/秒 |
| Qwen3 14B,4-bit | 14.43 秒对 57.25 秒 | 55.8 token/秒对 32.6 token/秒 |
| Qwen3.6 35B-A3B,4-bit | 7.25 秒对 17.5 秒 | 110.2 token/秒对 73.5 token/秒 |
| Qwen3.5 122B-A10B,4-bit | 14.58 秒对 46.9 秒 | 65.8 token/秒对 43.1 token/秒 |
| Gemma 4 31B,16-bit | 26.7 秒对 110.4 秒 | 13.6 token/秒对 9.0 token/秒 |
Qwen3 14B 的测试结果最接近苹果所说的四倍:首个 token 的等待时间从 57.25 秒降至 14.43 秒。Qwen3.8 27B 在概述约翰·斯图尔特·密尔的*《论自由》*时,这一阶段的速度提高了约 3.8 倍。Gemma 4 31B 的首 token 表现提升超过四倍,但输出回答其余部分的速度只提高了约 1.5 倍。
较长的提示词会让模型在输出首个 token 之前完成大量处理工作。生成回答则更具顺序性:每生成一个新 token,系统都必须反复从统一内存读取模型权重。在这项测试中,Qwen3.8 27B 的权重约占 15GB。这有助于解释为什么它的生成速度只提高了约 1.5 倍,更接近内存带宽的增幅,而不是首 token 阶段的提升幅度。
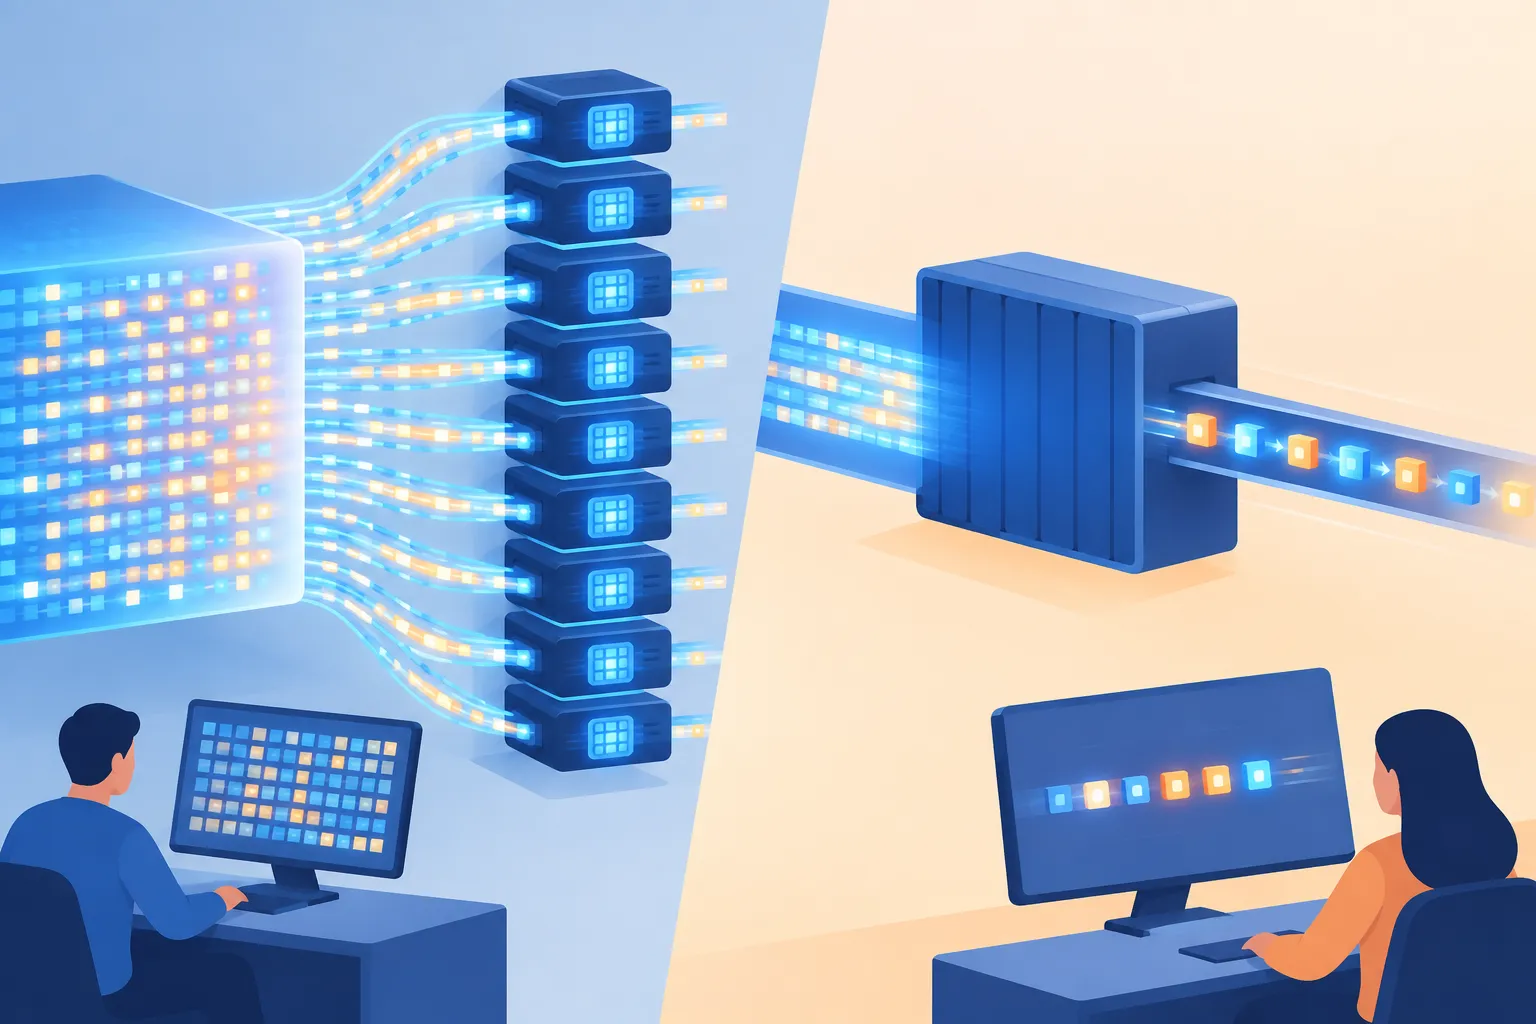
▲ 提示词处理与 token 生成
实际体验还取决于输出长度。如果任务是提供一份长文档并要求简短回答,缩短最初的等待时间可能对体验影响最大。如果要求模型给出长篇回答,持续生成速度较小的提升就更重要。在 Qwen3 14B 测试中,总耗时从 67.9 秒降至 21.6 秒;这一整体结果综合了两个阶段,并不意味着任务的每个环节都提速四倍。
音频与媒体任务的提速幅度各不相同
大语言模型只是离线工作负载的一部分。本地转录、视频素材分析、图像生成和视频生成在 M5 Ultra 上都运行得更快,但提升幅度不同。与单一的大语言模型基准测试相比,这些测试更有助于具体评估制作流程。
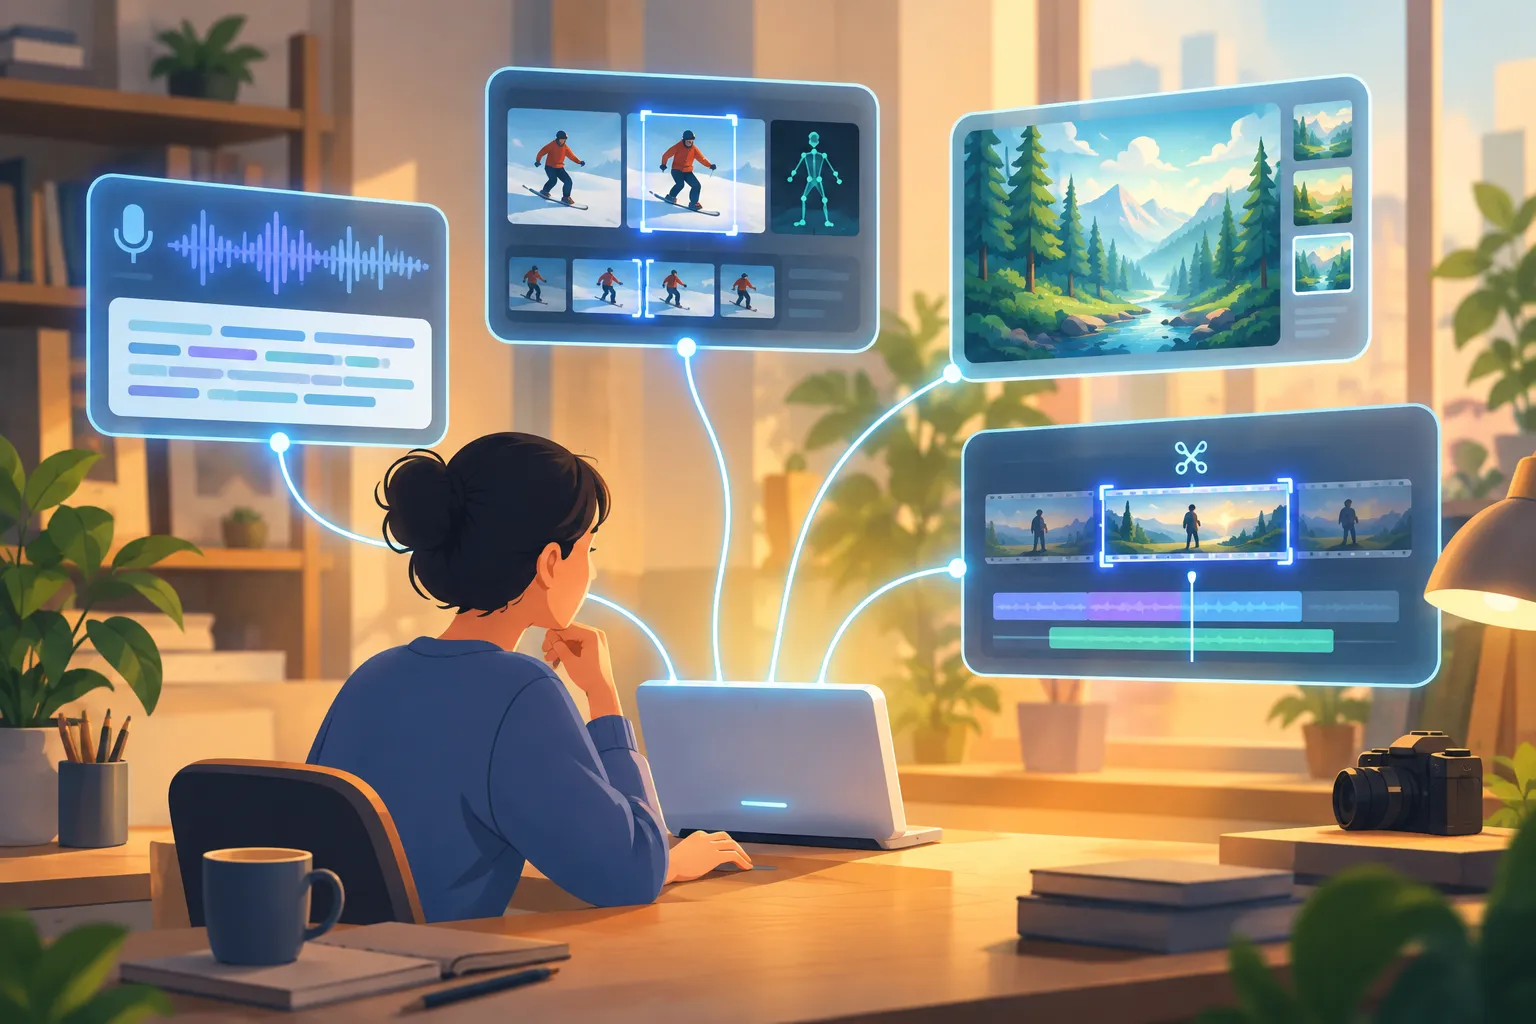
▲ 本地媒体制作流程
语音转文字测试通过 MLX 运行 Whisper;这里使用的 MLX 是在 Apple Silicon 上运行模型的框架。对于一段 13.8 分钟的音频,Whisper Large-v3 在 M5 Ultra 上用时 11.4 秒,在 M3 Ultra 上用时 20.2 秒。Whisper Turbo 分别用时 3.1 秒和 7.1 秒。一段更长、时长 2 小时 5 分钟的录音也呈现相同趋势:
| 转录模型 | M5 Ultra | M3 Ultra |
|---|---|---|
| Whisper Large-v3 | 89.4 秒 | 152.6 秒 |
| Whisper Turbo | 24.4 秒 | 56.2 秒 |
Turbo 的速度可能使其适合为长录音制作转录初稿。不过,这些耗时测试并不能证明它对每段录音的转录质量都与 Large-v3 相当,因此速度和输出质量仍需分别考量。
在视频素材分析测试中,Qwen3-VL 32B 处理了一段 60 秒的无声视频,按每秒一帧采样。它识别出人物和桌面物品等可见细节,在 M5 Ultra 上用时 22.9 秒,在 M3 Ultra 上用时 60.3 秒。对于这项本地视频编目任务,前者的速度是后者的 2.6 倍。
在图像生成测试中,FLUX.2 klein 4B 生成一幅 1024×1024 的森林插画,在 M5 Ultra 上用时 2.6 秒,在 M3 Ultra 上用时 10.2 秒。生成经过修改的写实版本分别用时 2.2 秒和 7.0 秒。以图像作为输入,LTX-2.5 22B 生成一段动画短片分别用时 17.5 秒和 30.2 秒;生成一段更大的短片分别用时 19.9 秒和 50.5 秒。这些差异再次说明:一项任务提速四倍,并不代表所有本地 AI 操作都有同样的提升。
自动化任务与价格考量
M5 Ultra 还运行了涉及多次模型响应的工作流程。一款本地智能体使用 Qwen3.8 27B,配置了 131,131 个 token 的上下文窗口(即模型一次可处理的材料量),并迅速回答了需要参考此前会话中超过 24,000 个 token 个性化上下文的问题。在另一项涵盖 300 道文本问题的分类测试中,M5 Ultra 用时 23.5 秒,M3 Ultra 用时 33.4 秒。两台机器报告的准确率相同:垃圾信息检测为 91.5%,银行业务意图识别为 66%。
一款剪辑智能体通过模型上下文协议(Model Context Protocol,MCP)将本地模型连接到 DaVinci Resolve Studio。MCP 是 AI 系统使用外部工具的一种方式。该智能体读取转录文本,并在时间线上剪切,去除开头说错的片段和犹豫停顿。自动化流程生成了剪辑版本,但规划并执行整个项目中的剪切操作耗时约 13 分钟。模型推理更快,并没有让整个剪辑流程瞬间完成。
受测的 M5 Ultra 配置包括 80 核 GPU、256GB 统一内存和 8TB SSD,售价为 $14,299。对于它能够处理的任务,离线运行可以避免调用云端 API,但这一价格只是该特定配置的成本,并不能证明每位用户都能省钱。内存差异同样重要:需要运行特别大模型的买家,应将自身的内存容量需求与这台 256GB 内存的测试机对照,而不应只凭速度做出选择。
如何判断是否值得升级
对于经常在本地处理长提示词或反复执行媒体处理任务的用户,M5 Ultra 的优势最为明显。首 token 阶段的提升能显著缩短大语言模型开始响应前的等待时间,转录和视频素材分析的测试结果也可能在大批量任务中节省时间。主要希望长篇回答输出得更快的用户,则应预期测试中所见的相对有限的生成速度提升。升级前,应先确定哪些模型符合自身的内存需求,衡量工作负载中提示词处理与 token 生成各占多少,再将节省的时间与实际打算购买的配置成本进行比较。