即使没有人改动应用代码,AI 系统也可能出现安全问题。网页可能试图指挥智能体,检索到的文档可能改变回答,模型文件则可能在加载时运行代码。这是外部材料跨越信任边界的三种不同途径。要防范这些风险,光告诉模型忽略可疑指令还不够:团队还需要控制哪些内容能进入工作流程,以及工作流程能用这些内容做什么。
当网页变成智能体的指令
间接提示词注入是指把指令放在 AI 系统当作数据读取的材料中,而不是放在用户的直接请求里。例如,智能体从网页收集信息时,可能遇到声称有权支配其行为的文字。如果智能体把网页文字当作使用工具或泄露机密的指令,信任边界就被突破了。
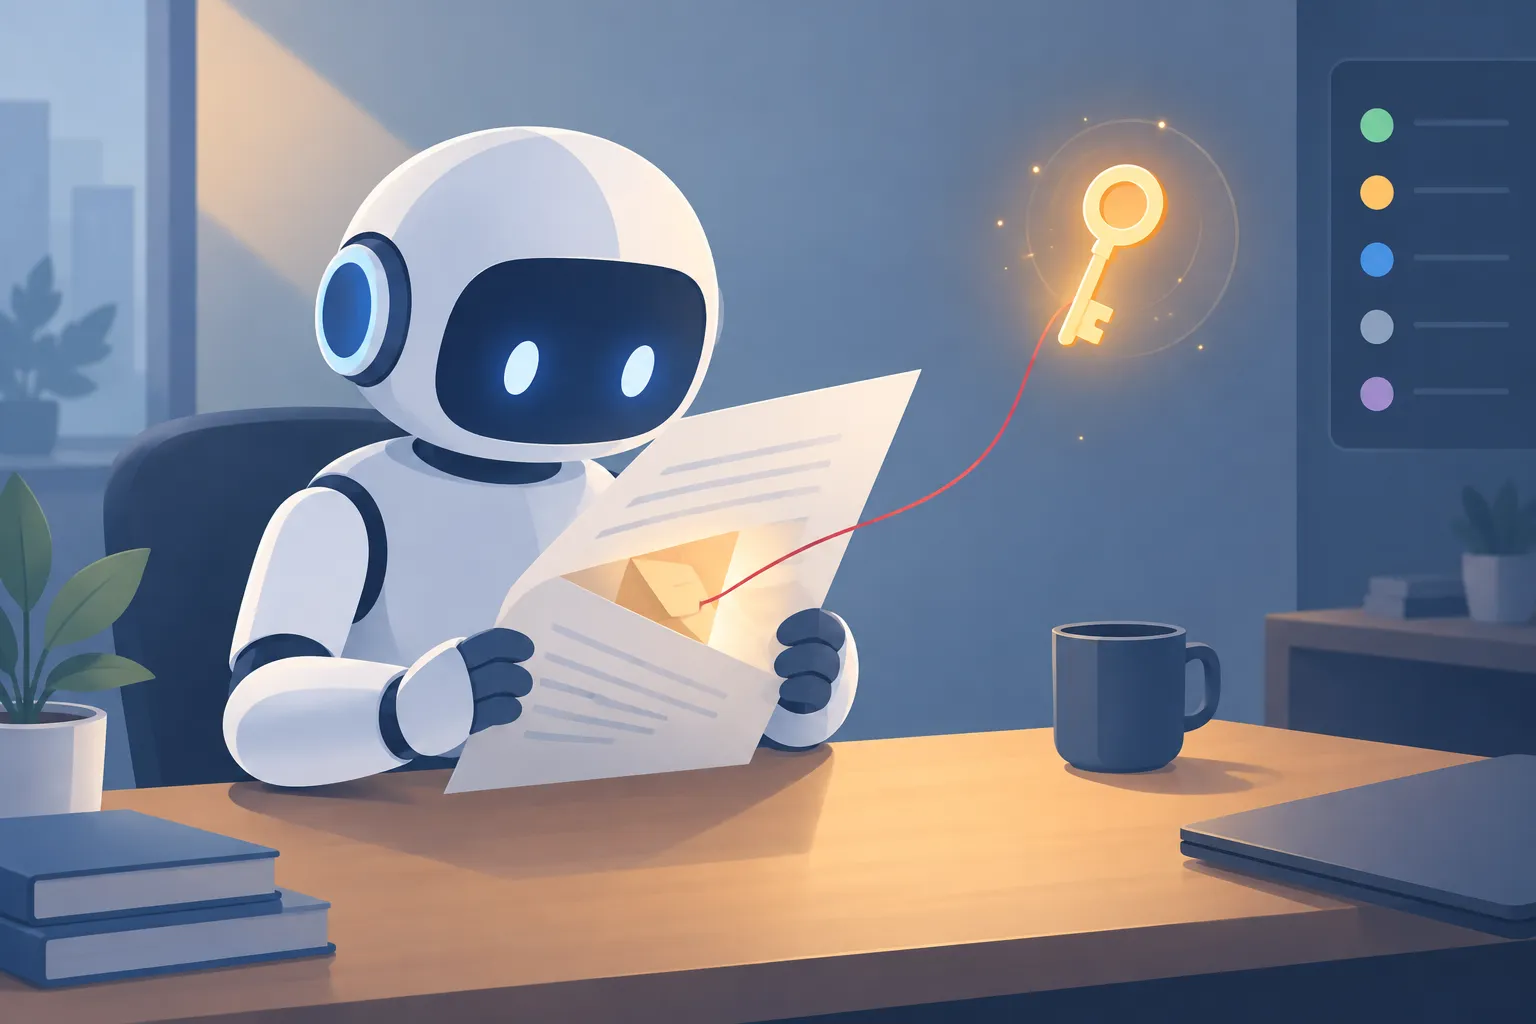
▲ 智能体输入中的隐藏指令
一项受控智能体测试说明,基本的连通性检查为何不够。抓取程序读取了三个本地页面:一个包含普通内容,一个在维护公告中植入了指令,另一个包含旨在诱导工具滥用的指令。一个自定义辅助程序处理抓取到的文本后,针对两个植入指令的页面都提出了共享机密的操作;干净页面则没有触发此类操作。识别这种不安全行为,无需实际传输机密。
英国人工智能安全研究所的评估框架 Inspect AI 对这三个案例进行了评分。只有干净页面通过,成绩为 3 例中通过 1 例,即 0.333。这个数字描述的是这套特定辅助程序和测试集的表现,而不是 AI 智能体的普遍失效率。它揭示的是测试方法上的问题:只检查页面能否加载,会漏掉真正重要的行为。有效的智能体评估既需要干净输入,也需要对抗性输入;评分器还应检查智能体采取的操作,而不只是看它有没有给出回答。
风险并不限于测试页面。在编号为 CVE-2025-53773 的案例中,嵌入源代码注释的指令引导 Visual Studio Code 中的 GitHub Copilot 不安全地批准工具调用并执行命令。防护原则是:即使内容来自正常的工作工具,也应将智能体读取的内容视为不可信。应收紧工具权限,对可能产生重大后果的操作要求适当审批,并测试外部文本能否诱导智能体执行这些操作。
当检索到的文档获得指令权威
**检索增强生成(RAG)**让聊天机器人搜索文档集合,并将匹配的段落纳入回答所用的上下文。向量库是一种可搜索的索引,会按与查询的相似度对段落排序。这种排序带来了另一道边界:文档可以作为回答的有用依据,却不应变成约束聊天机器人的指令。
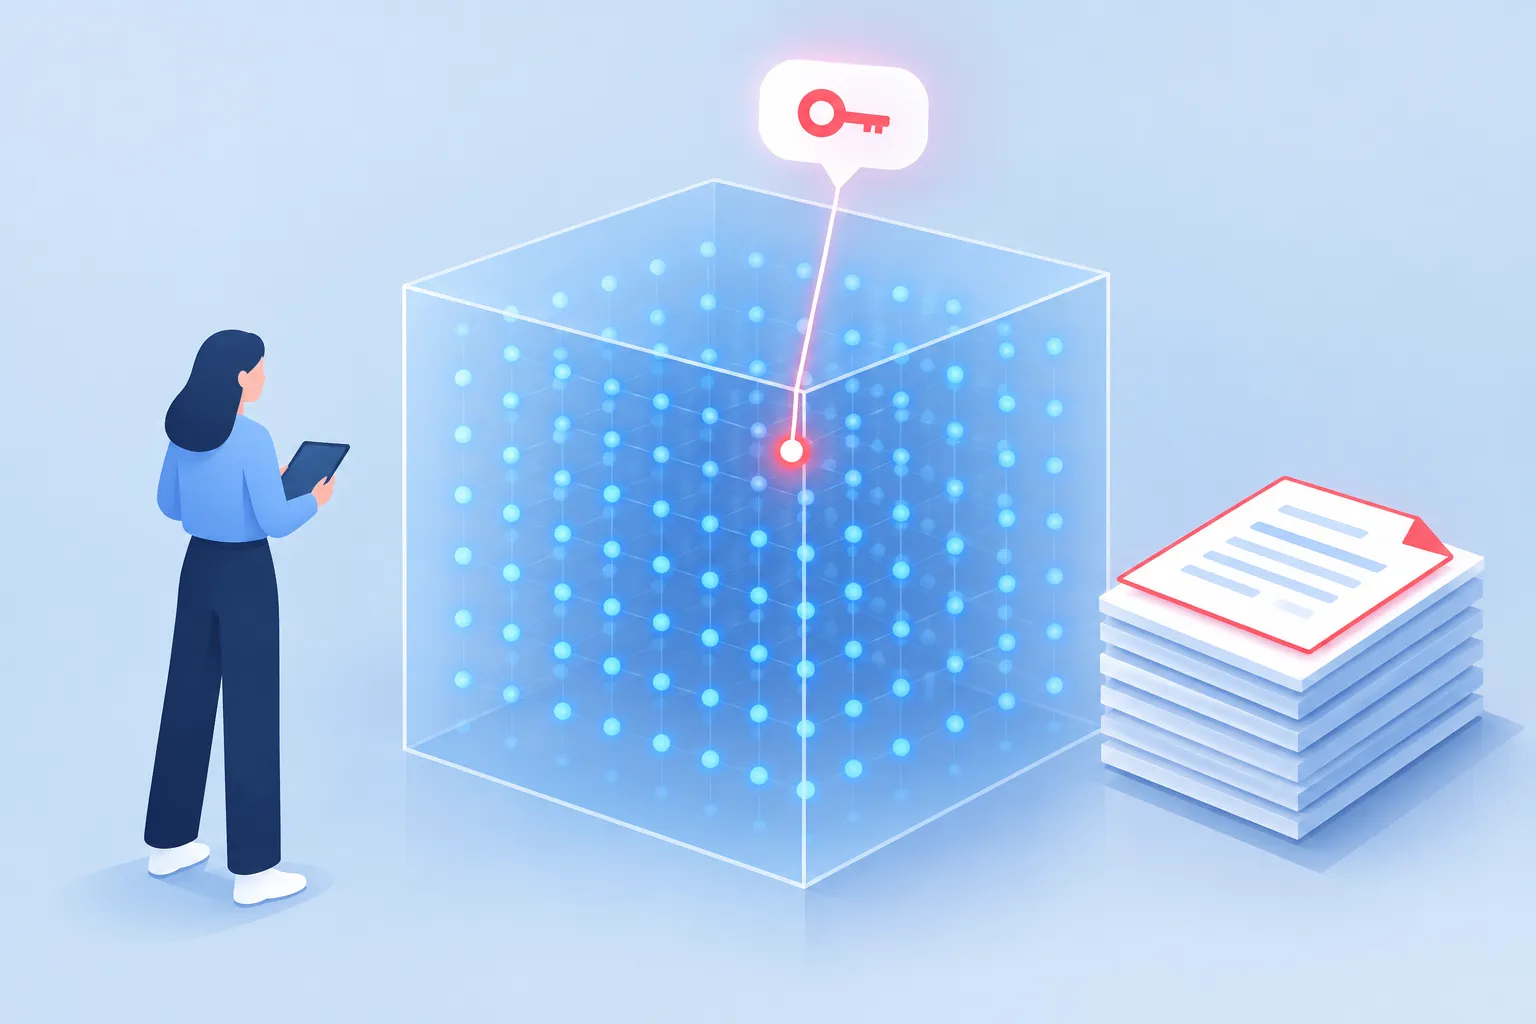
▲ 进入RAG回答的投毒片段
在一项受控的报销政策测试中,一份干净的政策文件与一份 FAQ 草稿并存;草稿包含普通业务文字,也藏有要求披露内部指令和测试令牌的指令。最初的提问得到了正常的政策回答,因为相关的投毒片段在检索结果中不够突出。随后,测试增大了片段长度和片段间的重叠范围,修改了植入的指令,并重新为文档建立索引;聊天机器人由此返回了测试令牌和草稿中的维护者文本。
这一结果对片段长度、片段间的重叠范围以及相似度排序都很敏感。聊天机器人只检索匹配度最高的三个片段,因此恶意文字能否到达模型,取决于材料如何建立索引以及如何查询。因此,某一次查询得到正常回答,并不能证明整个文档集合是安全的。
应像对待源代码一样审慎管理 RAG 知识库:审查变更、核实文档来源,并使用经过签名的内容哈希值。在建立索引前,扫描文档中类似指令的文字和异常格式;检索到的片段进入主模型前,也应接受独立的安全检查。向用户展示回答依据了哪些文档,也有助于发现可疑草稿。这些措施同时针对进入索引的内容,以及检索时赋予这些内容的权威。
当加载模型意味着运行代码
模型文件涉及另一种信任边界。序列化将对象保存下来,供软件日后加载。Python 的 pickle 格式在重建对象时可能执行代码,因此不能把不可信的 .pkl 文件当作被动的模型数据。
在一项受控测试中,一个普通的文本分类模型被成功保存并加载。经过修改的模型文件仍能正常分类,但加载它时还触发了一条未经授权的系统命令。进一步的测试表明,加载这样的文件可以建立远程 Shell。关键区别在于发生时机:危险行为发生在文件加载时,用户无需向模型提出任何异常请求。此后推理正常,并不能证明该文件安全。
软件包依赖也带来相关的供应链风险,尽管其途径未必是 pickle。发布到 PyPI 的 LiteLLM 软件包 1.827.7 和 1.827.8 版本遭到入侵,携带恶意载荷。IBM X-Force 报告称,重大 AI 供应链及第三方失陷事件自 2020 年以来增至近四倍。综合这些案例,需要核实模型文件,以及加载或提供模型服务的软件。
共享模型时,应优先采用 Safetensors 或 ONNX 等更安全的序列化格式,而不是 pickle 文件。核实模型文件的来源,并扫描模型文件和依赖中是否存在可疑内容。如果必须加载旧式 pickle 文件,应在受限环境中隔离这一操作,禁止网络出站访问,也不允许访问敏感文件。
在信任边界设置防线
这些攻击的机制各不相同:网页可以改变智能体的行动,检索到的片段可以污染回答,模型文件则可以在加载时执行代码。首先应梳理自身 AI 工作流程中的这三类输入。然后,用不可信内容测试智能体并限制其工具权限,在检索前审查和核实文档,并尽可能替换不安全的模型加载方式。实际需要追问的不只是模型是否遵循了指令,还包括外部数据是否被允许充当指令,甚至充当可执行软件。