Google이 오랜만에 주 버전 번호를 올린 Gemini 4를 내놓은 가운데, Gemini 4 Argon High를 다른 최상위 모델과 같은 과제로 비교한 첫 결과가 나왔습니다. 작업당 비용은 경쟁 모델보다 낮았지만 생성 품질은 과제에 따라 크게 달랐습니다. 금문교 3D 장면은 구조와 조작 기능을 잘 갖췄지만, 공중 섬과 비행 게임, 건축물 장면에서는 형태와 움직임이 흔들렸습니다.
순위와 비용을 함께 봐야 하는 이유
여러 도구를 다뤄 일을 처리하는 agent(도구를 사용해 스스로 작업을 수행하는 AI) 작업 순위에서 Gemini 4 Argon High는 46개 모델 가운데 8위입니다. 이 순위는 도구 사용의 신뢰성, 작업 완료, 지시에 따른 조정 가능성을 반영합니다. 최상위권에는 미치지 못하지만 비용 대비 성능을 나타낸 Pareto frontier(같은 비용으로 더 나은 성능을 내는 대안이 없는 모델들의 경계)에는 들었습니다. Gemini 모델은 성능에 비해 효율이 높고 가격이 매력적이라는 평가를 받아 왔고, 이번에도 비용과 성능 곡선의 중간쯤에 자리했습니다.
최근 14일 동안 집계한 작업당 비용 중간값은 다음과 같습니다. 요금표가 아니라 이 순위에서 측정한 작업당 비용입니다.
| 모델 | 작업당 비용 중간값 |
|---|---|
| Gemini 4 Argon High | 약 $0.80~0.90 |
| GPT-6 Sol Max | 약 $1.30 |
| Claude Opus 5.5 High | 약 $3~4 이상 |
Gemini 4 Argon High의 작업당 비용은 GPT-6 Sol Max보다 약 3분의 1, Claude Opus 5.5 High보다 약 70% 낮습니다. GPT-6 Luna처럼 더 싼 모델도 있지만, Gemini 4 Argon High는 중간 가격대에서 눈여겨볼 만한 자리에 있습니다. 비용 비교의 GPT-6 Sol Max와 달리 아래 생성 결과 비교에는 GPT-6.1 Sol Max가 쓰였습니다.
금문교는 잘 만들었지만 공중 섬에서는 달랐습니다
prompt(모델에 입력하는 작업 지시)만으로 만든 WebGL(웹 브라우저에서 3D 장면을 그리는 기술) 금문교 장면에서 Gemini 4 Argon High는 다리 케이블과 수면, 움직이는 배를 갖춘 구조를 만들었습니다. 안개와 교통량, 물결, 시간대를 바꾸는 조작 막대도 작동했습니다. 다만 안개를 가장 짙게 하면 장면이 지나치게 가려졌고, 조작 화면은 빽빽하고 투박한 편이었습니다. 다리의 세부와 분위기는 Claude Sonnet 5.5 High의 결과와 견줄 만하거나 조금 나았지만, 물 표현과 조명, 조작 화면은 GPT-6.1 Sol Max 쪽이 더 정돈됐습니다.
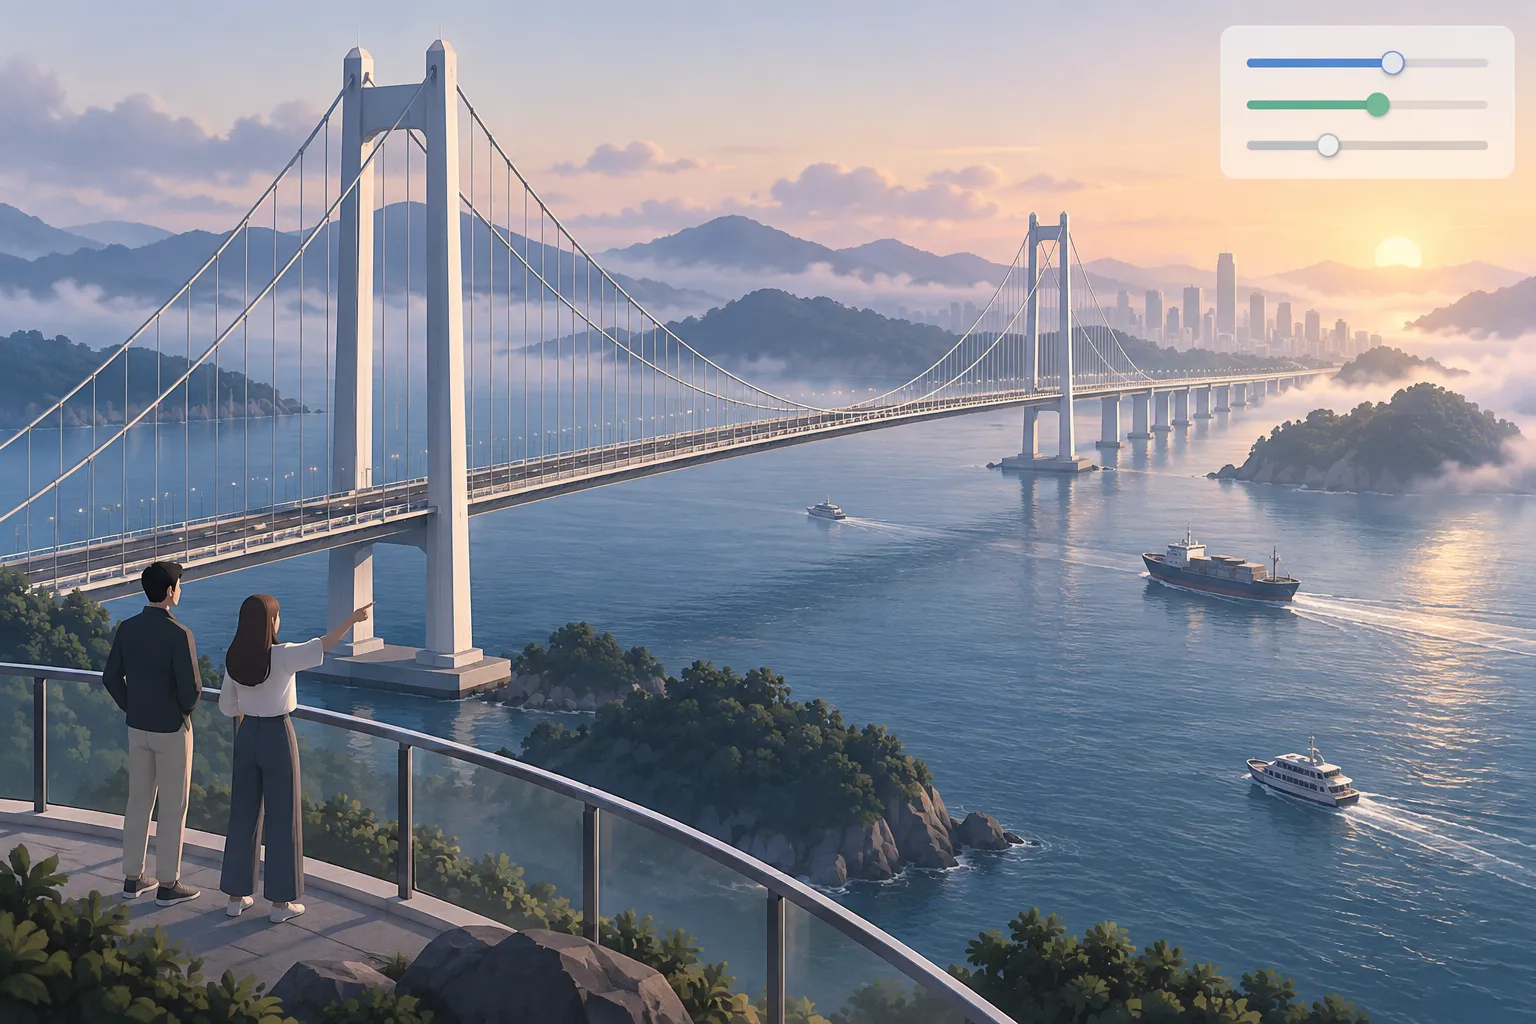
▲ 금문교 3D 생성 결과
공중에 뜬 섬을 만드는 과제에서는 차이가 커졌습니다. Gemini 4 Argon High의 결과에는 각진 산 덩어리와 어지럽게 놓인 나무, 갈라진 섬 조각이 나타났습니다. 섬 아래쪽과 틈에는 표면이 입혀지지 않은 검은 공간과 어색한 이음매가 남았습니다. 반면 Claude Sonnet 5.5 High는 계단식 논밭과 일하는 사람, 다리, 여러 층의 폭포를 갖춘 장면을 일관되게 구성했고, GPT-6.1 Sol Max도 맑은 산정 호수와 안개, 흐르는 물을 갖춘 장면을 만들었습니다. 정해진 구조물에서는 버텼지만 복잡하고 창의적인 장면에서는 크게 뒤처진 셈입니다.
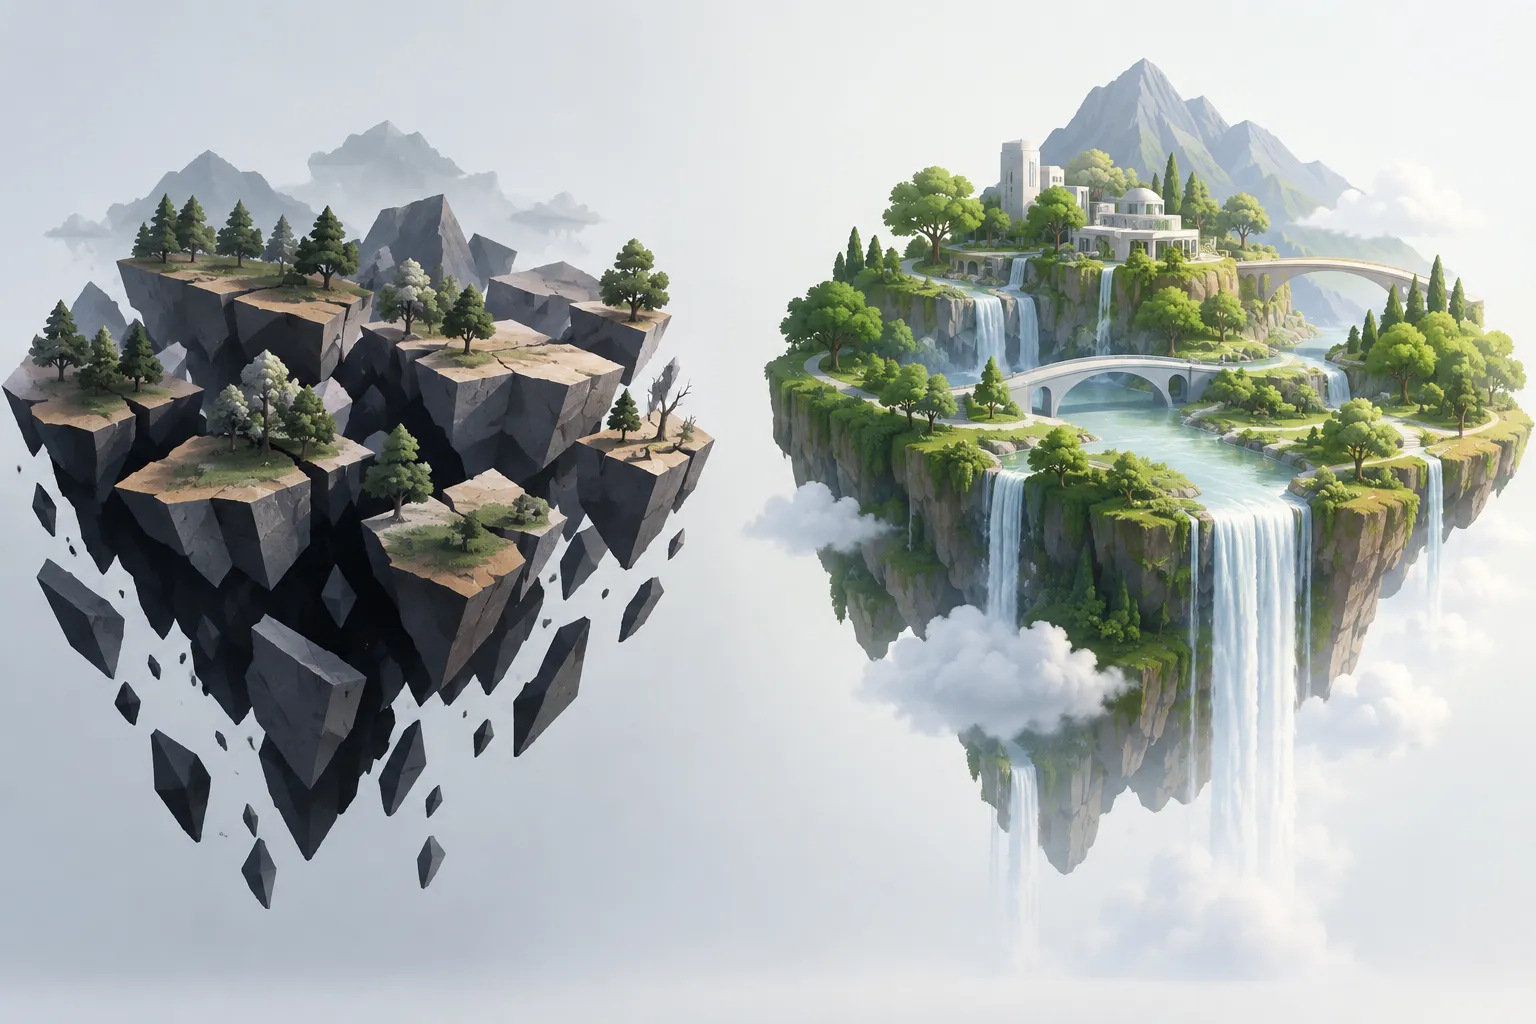
▲ 복잡한 장면의 구조 차이
움직임과 연결에서 드러난 약점
이전 Gemini 모델은 게임 생성에서 가능성을 보였지만, 에펠탑과 센강 주변을 날며 고리를 모으는 비행 게임에서 Gemini 4 Argon High의 조작은 둔하고 불규칙했습니다. 비행기는 건물에 자주 부딪혔고, 구조물을 뚫고 지나가거나 그 안에 끼었습니다. 충돌 판정과 게임 상태 처리가 제대로 되지 않았다는 뜻입니다. GPT-6.1 Sol Max가 만든 게임은 비행이 매끄럽고 선회 동작과 고도 표시를 갖췄으며 조작에 바로 반응했습니다. 게임 생성이 언어 모델의 주된 상업적 지표는 아니지만, 복잡한 물리와 게임 로직을 다루는 능력의 약점이 드러났습니다.
건축 장면에서도 비슷한 문제가 반복됐습니다. 바벨탑 장면에서 Gemini 4 Argon High는 거대한 층층 구조와 배, 비계를 그렸지만, 작업자는 각진 형상으로 멈춰 있거나 공중에 떠 있었고 해안선과 물의 경계도 정리되지 않았습니다. 같은 과제에서 GPT-6.1 Sol Max는 수레를 밀고 목재를 나르는 작업자를 구현했고, Claude Sonnet 5.5 High도 정교한 석조 구조와 작은 움직임이 살아 있는 장면을 만들었습니다. 백악관 장면에는 잔디와 분수, 나무가 들어갔지만 지붕 위의 정체 모를 검은 덩어리와 끊긴 도로가 남았고, 사그라다 파밀리아 성당은 첨탑 꼭대기가 어긋나고 주변 거리 구획이 끊겼습니다. 6개월 전이라면 인상적이었을 결과이지만, 지금의 최상위 모델과 견주면 뒤처져 보입니다.
도입 전에는 실제 작업으로 확인해야 합니다
이 3D 과제들은 정식 benchmark(성능을 재는 표준 시험)가 아니라 결과물을 직접 살펴보는 정성 점검입니다. 그래도 명령 이행, 구조 안정성, 공간 인식, 일관성처럼 모델의 바탕 능력을 가늠하게 해 줍니다. Gemini 4 Argon High는 기본 지시는 잘 따랐지만 prompt가 복잡해질수록 결과의 편차가 컸습니다. 게임 조작이나 3D 좌표에서 이런 불안정이 보이는 모델이라면 데이터베이스 스키마나 코드 구조, 여러 단계에 걸친 도구 호출 같은 업무에서도 비슷한 편차가 나타날 수 있습니다.
비용이 중요한 작업이라면 약 70%의 비용 절감이 품질 차이를 감수할 만한지 따져 보고 Gemini 4 Argon High를 후보에 넣을 수 있습니다. 모델을 고를 때는 능력 순위만 보지 말고 Pareto frontier처럼 비용을 함께 반영한 지표를 보는 편이 좋습니다. 맡길 때는 열린 지시보다 필요한 구조와 스키마를 명확히 정해 주고, 생성된 결과에서 구성 요소의 연결, 조작 반응, 여러 단계에 걸친 상태 유지를 직접 확인해야 합니다. 실제로 맡길 과제로 먼저 시험한 뒤 결정하는 것이 안전합니다.