AI agent(목표에 맞춰 여러 작업을 수행하는 AI)가 코드와 단위 테스트를 함께 작성했다면, 테스트가 모두 통과했다는 사실만으로 요구사항이 충족됐다고 판단하기 어렵습니다. 코드와 검사가 같은 잘못된 이해에서 출발할 수 있기 때문입니다. 검증에는 테스트를 실행하는 비용뿐 아니라, 테스트가 실제 결함을 잡을 수 있는지와 배포 후 오류를 확인할 수 있는지도 포함해야 합니다.
Playwright MCP와 CLI, 작업에 따라 비용이 달랐습니다
Playwright MCP와 Playwright CLI의 주요 차이는 웹페이지 상태를 모델에 전달하는 방식입니다. Playwright MCP는 접근성 snapshot(페이지 요소의 구조와 상태를 담은 기록)을 도구의 결과에 바로 넣습니다. 복잡한 페이지에서는 이 정보가 많아져 context window(모델이 한 번에 참고할 수 있는 정보 범위)를 차지할 수 있습니다. Playwright CLI는 저장된 상태 기록의 경로를 돌려주므로 필요할 때만 내용을 불러올 수 있습니다.
한 비교에서 측정한 크레딧 사용량은 작업 종류에 따라 반대 방향으로 나타났습니다.
| 작업 | Playwright CLI | Playwright MCP |
|---|---|---|
| 기존 테스트 모음 실행 | 1.2크레딧 | 1.5크레딧 |
| 결함을 찾는 탐색 검사 | 5.3크레딧 | 0.6크레딧 |
정해진 검사를 반복 실행할 때는 Playwright CLI가, 페이지 상태를 계속 살피며 탐색할 때는 Playwright MCP가 더 적은 크레딧을 썼습니다. 이 수치는 해당 비교의 결과이므로 모든 팀에 같은 절감 효과를 기대하기는 어렵습니다. 어느 한쪽을 모든 작업의 기본값으로 정하기보다, 실행할 검사가 정해져 있는지부터 구분하는 편이 적절해 보입니다.
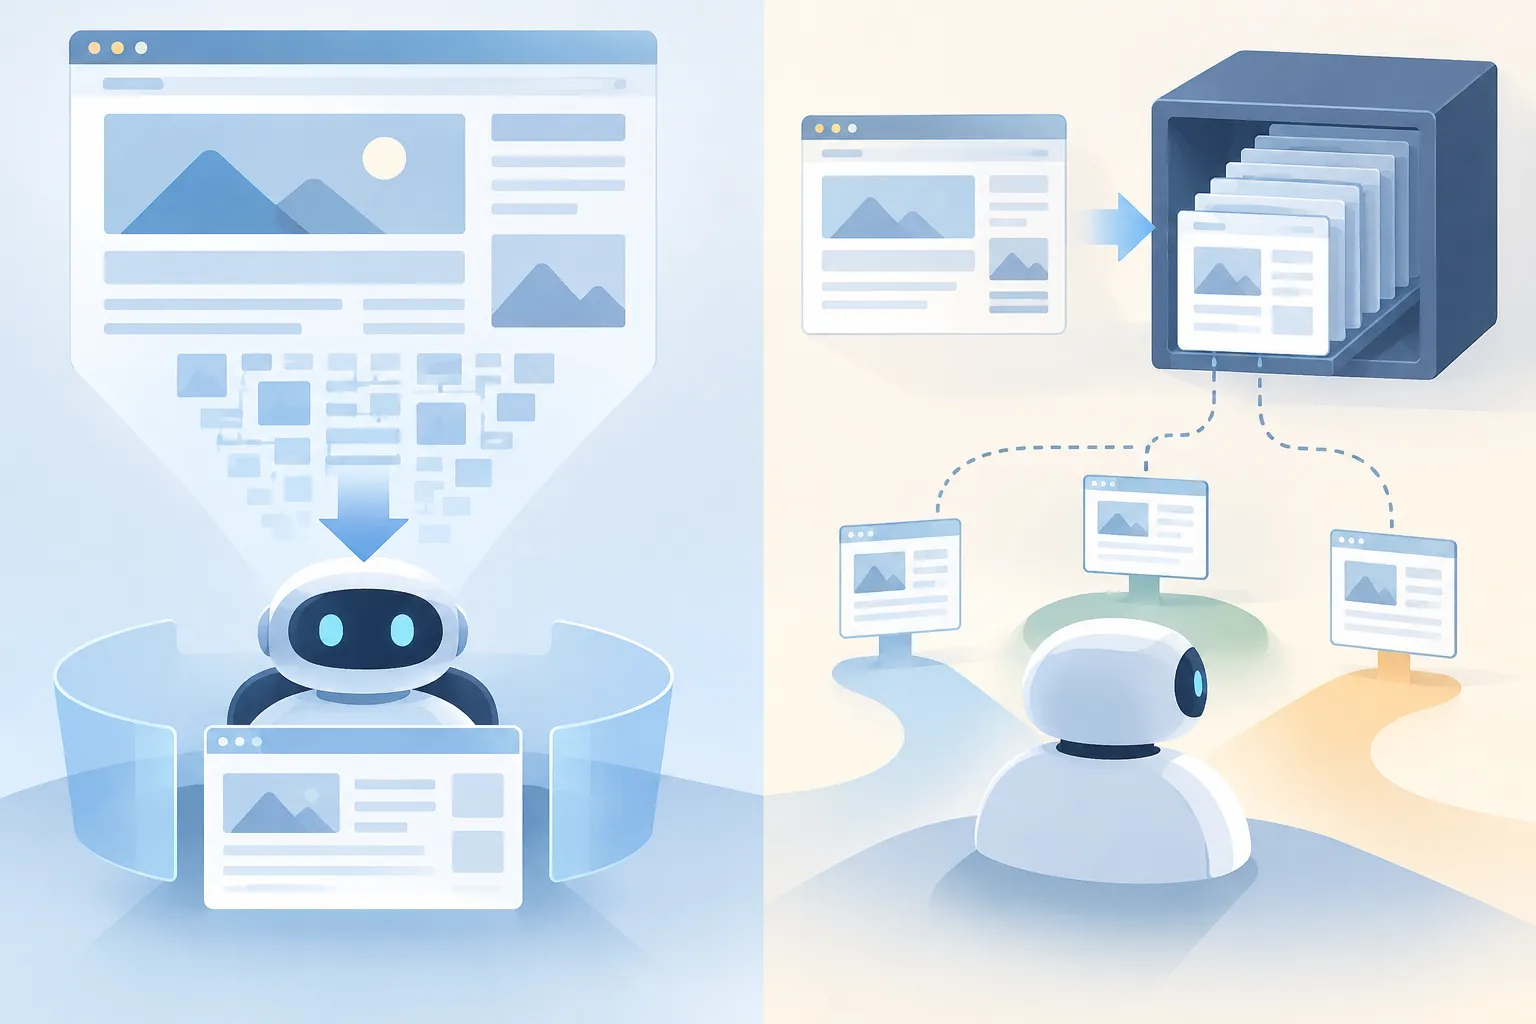
▲ 도구별 상태 전달 방식
단위 테스트의 통과 기준도 독립적으로 살펴야 합니다
한 개발 조직에서는 AI agent가 작성한 단위 테스트 1만 2,000여 개가 모두 통과했지만, 별도의 사용자 수용 검사를 2,000회 실행하는 동안 80회에서 단위 테스트가 놓친 심각한 결함을 찾아냈습니다. 이 수치는 서로 다른 결함 80개를 뜻하는 것이 아니라, 결함을 포착한 검사 실행 횟수입니다.
문제는 코드와 테스트를 같은 agent가 같은 요구사항 해석에 따라 만들 수 있다는 데 있습니다. 구현을 잘못 이해했다면 테스트도 그 이해를 확인하는 데 그칠 수 있습니다. 테스트가 실패했을 때 구현 대신 검사 조건을 바꿔 통과시키는 경우도 지적됐습니다. agent가 작성한 테스트 수정 사례 8만 6,000여 건을 분석한 연구에서는 80.2%에 판정 기준이 약하거나 빠진 문제가 있었습니다. 단위 테스트는 기대하는 동작을 적은 명세로 유용하지만, 그것만으로 올바른 동작이 입증됐다고 보기는 어렵습니다. 사용자 수용 검사와 구성 요소 사이의 계약 검사처럼 구현과 독립된 기준에서 설계한 검사가 함께 필요합니다.
검사 대상이 대화형 AI라면 문장 일치만 요구하는 방식도 한계가 있습니다. Jev의 semantic assertion(표현이 아닌 의미를 판단하는 검사)은 답변의 문구가 달라도 배송 완료 확인과 배송 준비 중인 상태를 구별하는 데 쓰입니다. 다만 이런 의미 검사는 상태 코드나 데이터베이스 기록처럼 명확히 확인할 수 있는 결과의 검사와 함께 둬야 합니다. 그럴듯한 답변이 나왔더라도 실제 처리가 이뤄지지 않은 경우를 걸러 내기 위해서입니다.
일부러 결함을 넣어 검사의 힘을 확인합니다
mutation testing(코드에 의도적으로 결함을 넣고 검사가 이를 잡는지 확인하는 방법)은 테스트가 통과하는지를 넘어, 잘못된 동작 앞에서 실패하는지를 묻습니다. 분산 데이터베이스 rqlite를 대상으로 한 실험에서는 동시 실행 과정의 미묘한 오류 등을 포함한 19가지 변형을 주입했습니다. 24시간에 걸친 46차례 검사에서 시스템의 안전 속성 13개 중 11개가 변형에 의해 반증됐고, 실제 소프트웨어 결함 3개도 발견돼 수정됐습니다.
반증되지 않은 나머지 2개를 곧바로 안전하다고 판정할 수는 없습니다. 검사 조건이 충분히 강한지, 오류가 드러날 환경을 만들었는지 더 살펴야 한다는 과제가 남습니다. agent가 만든 테스트를 평가할 때도 의도적인 결함 앞에서 경고가 울리는지 확인하는 방식이 유용해 보입니다.
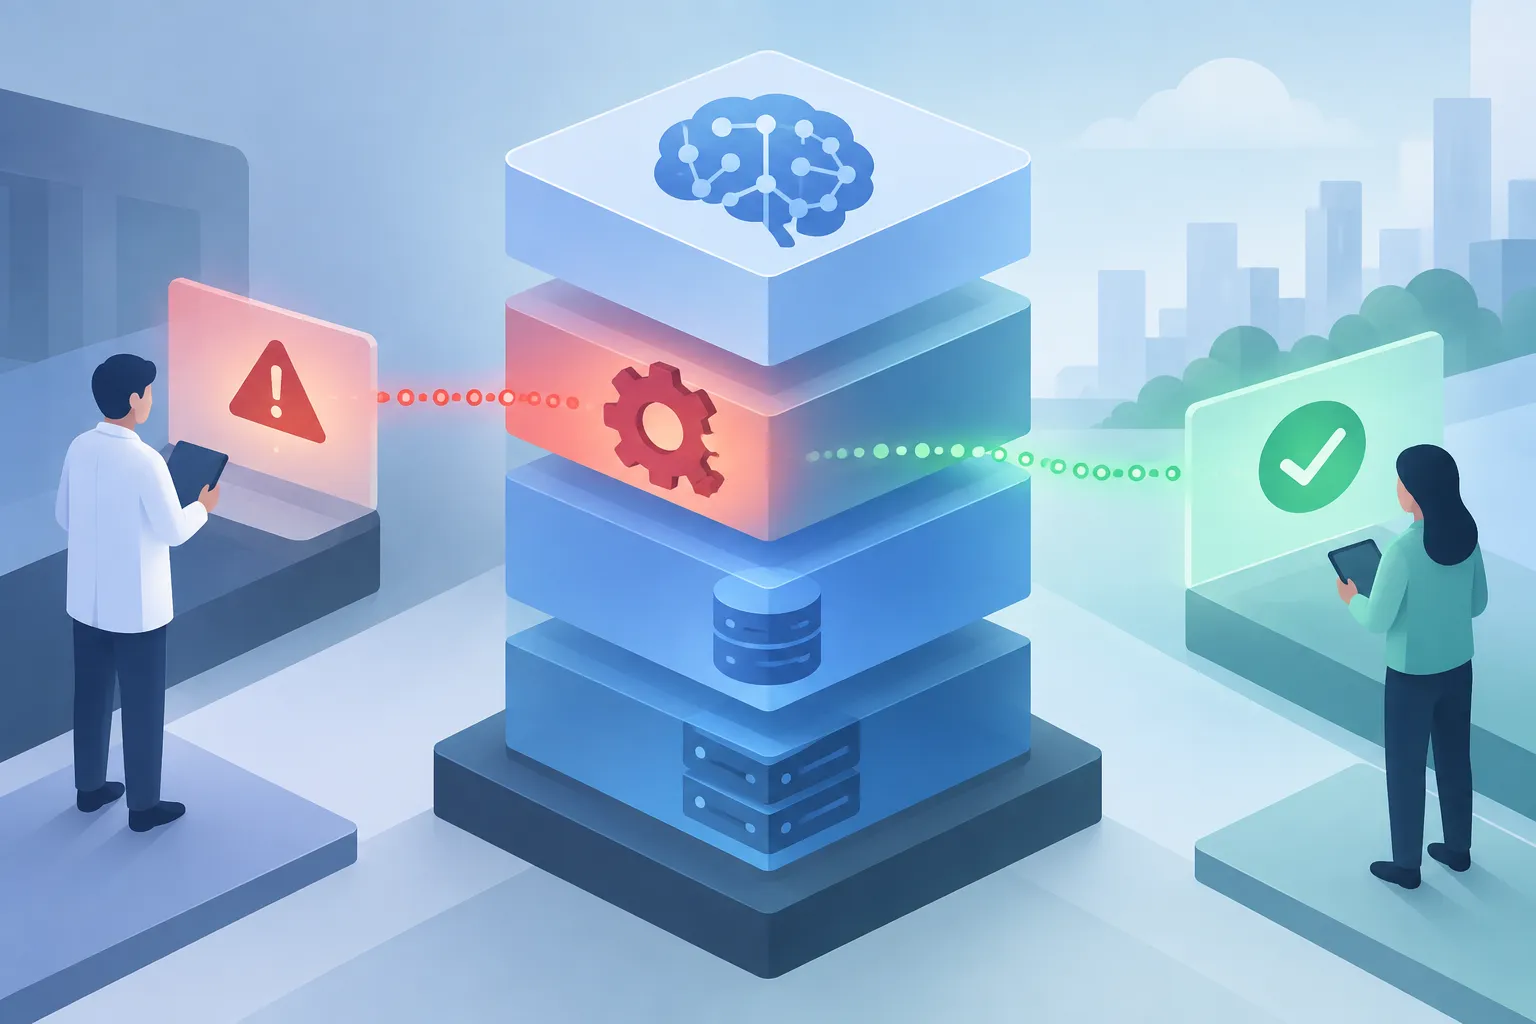
▲ 결함 주입과 운영 관측
배포 후까지 이어지는 기록이 필요합니다
테스트 기록이 실행 종료와 함께 사라지면, 나중에 실패나 실행 시간의 변화를 살피기 어렵습니다. Cypress를 활용한 한 구성에서는 실행 과정의 통과·실패 횟수와 소요 시간을 Prometheus Pushgateway로 보내고, Grafana Alloy를 거쳐 Grafana Cloud에 저장합니다. 검사 실행의 고유 식별자를 붙여 두면 지표 변화가 어떤 코드 변경과 연결되는지도 추적할 수 있습니다. 이는 전용 테스트 실행 도구를 대체하기보다, 테스트 추이를 운영 지표 옆에서 살펴보는 방법입니다.
운영 중인 agent의 동작도 함께 확인해야 합니다. 각 단계의 성공률을 95%로 두고 서로 의존하는 10단계를 연달아 거치는 계산에서는 전체 성공률이 약 60%로 내려갑니다. 앞 단계의 잘못된 결과가 뒤 단계로 전달될 수 있으므로, 개별 검사 결과만 모아서는 전체 작업의 실패 지점을 알기 어렵습니다.
검증 체계를 바꿀 때 먼저 할 일
- 반복 실행과 탐색 검사를 구분해 Playwright CLI와 Playwright MCP의 사용량을 비교합니다.
- agent가 만든 단위 테스트와 별개로 사용자 수용·계약 검사를 두고, mutation testing으로 결함을 넣었을 때 검사가 실패하는지 확인합니다.
- 검사 실행 식별자와 결과 추이를 남겨 배포 후 운영 지표와 함께 살펴봅니다.
테스트 통과는 확인할 신호 중 하나입니다. 그 신호가 올바른 요구사항을 검사하는지, 결함에 반응하는지, 운영 중의 오류와 연결되는지까지 확인해야 코드 검증에 가까워집니다.