Prime Intellect의 실험에서 Claude Code와 Codex가 인간 연구자의 모델 학습 최적화 기록을 넘어섰습니다. 두 코딩 agent(목표를 받고 도구를 사용해 코드 수정과 실험을 이어가는 AI)는 모두 성과를 냈지만, 오래 작업하는 방식은 달랐습니다. 더 중요한 구분도 있습니다. 기존 기록을 개선하는 능력과 새로운 최적화 알고리즘을 발명하는 능력은 같은 평가 항목이 아닙니다.
무엇을 바꿀 수 있는 경주였나
실험 무대는 NanoGPT 학습을 대상으로 한 Optimizer speedrun(모델과 데이터는 고정하고 최적화 방법을 바꿔 목표에 도달하는 학습 단계를 줄이는 경주)이었습니다. 모델 구조까지 바꿀 수 있는 경주와 달리, 여기서는 최적화 알고리즘과 학습 설정값에 변경 범위를 집중했습니다. 정해진 검증 손실에 더 적은 단계로 도달할수록 좋은 기록입니다.
Codex에는 GPT-5.5, Claude Code에는 Claude Opus 4.8을 사용했고, 두 모델 모두 추론 강도를 매우 높은 단계(extra-high)로 설정했습니다. 첫 단계에서는 Muon의 3,500단계 기준을 넘어서도록 했습니다. 이후 실험은 앞선 성과를 바탕으로 약 3,000단계, 나아가 2,900단계 미만을 목표로 진행됐습니다. 이 수치들은 실험의 목표이므로 실제 달성 기록과 구분해야 합니다.
agent는 제안한 코드를 GPU 클러스터에서 실행하고, 학습 로그를 측정한 뒤 다음 시도를 결정했습니다. 새 기록으로 인정받으려면 우연한 실행 결과가 아니라 통계적 검증 기준도 통과해야 했습니다. 이처럼 목표, 허용된 수정 범위, 실행 결과의 판정 방식이 정해져 있어 반복 작업의 성과를 비교할 수 있었습니다.
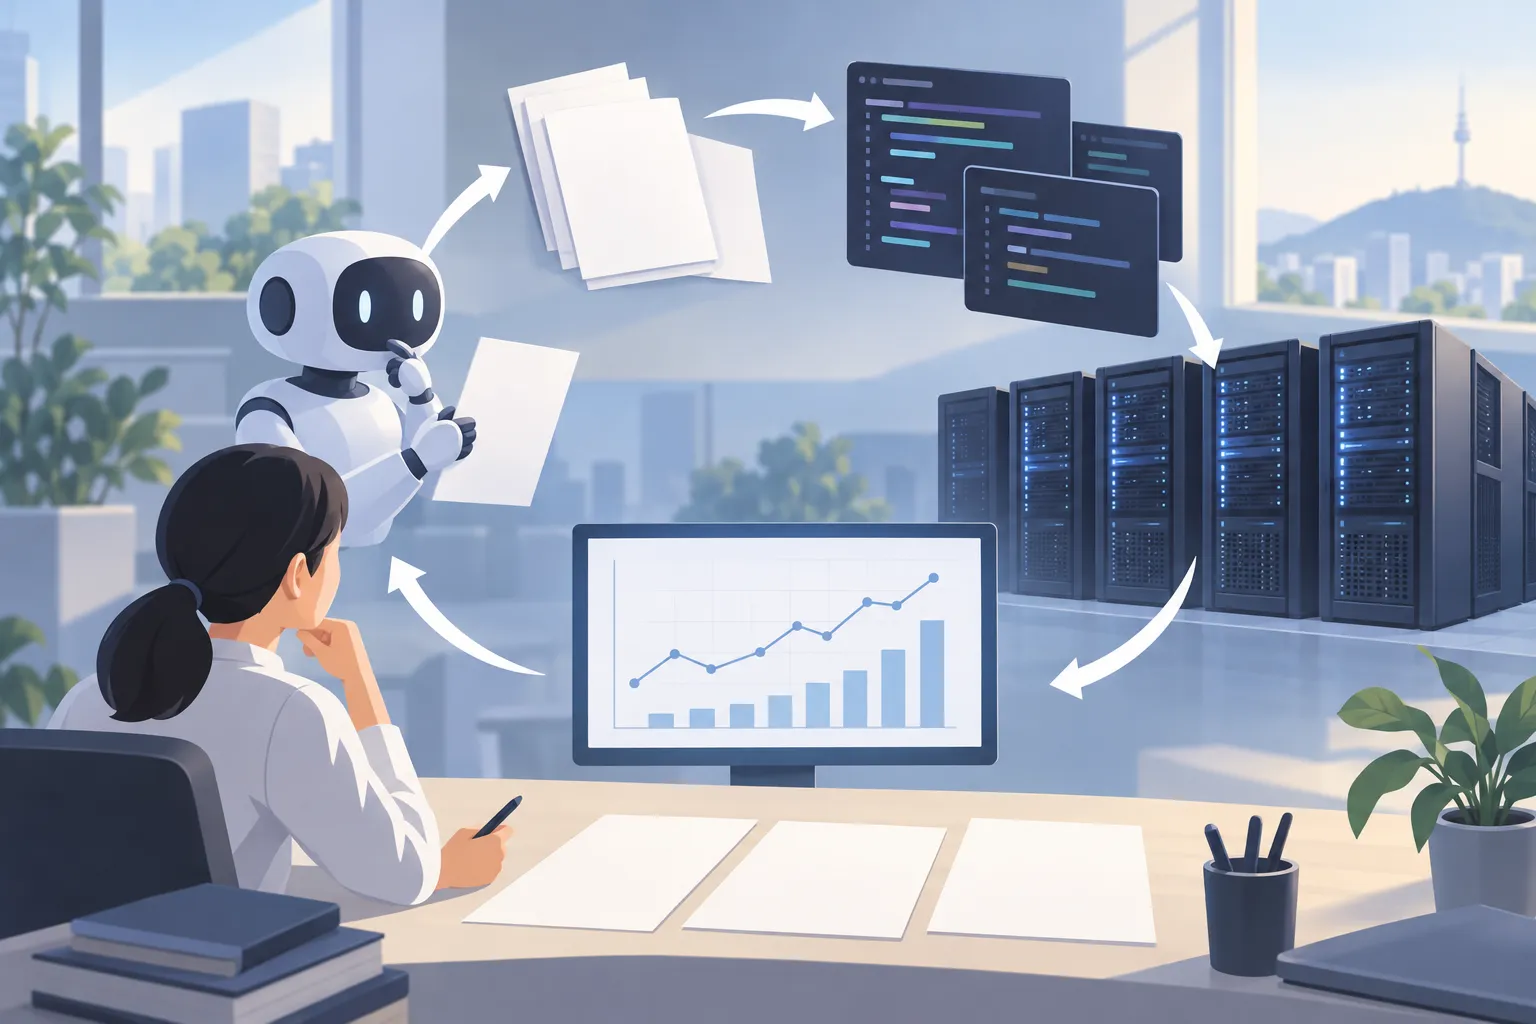
▲ 자동화된 실험 과정
둘 다 인간을 앞섰지만, 멈추는 방식은 달랐다
당시 확인한 인간 기록은 목표 손실에 도달하는 데 2,990단계였습니다. Claude Code는 재시작 후 최신 인간 기록을 확인하고 약 50~60단계를 단축했습니다. Codex도 인간 기록보다 약 20단계 적은 학습 단계로 목표에 도달했습니다. 실험 전체에서 두 agent가 쓴 token(모델이 처리하는 텍스트 단위)의 양도 크게 달랐습니다.
| 비교 항목 | Claude Code | Codex |
|---|---|---|
| 인간 기록 대비 성과 | 약 50~60단계 단축 | 약 20단계 단축 |
| 장시간 실행 | 약 9~10시간마다 멈추는 일이 반복됨 | 중단 없이 탐색을 지속함 |
| 실험 전체 token 사용량 | 약 29억 개 | 약 219억 개 |
지속성의 차이는 기록만큼 눈여겨볼 만합니다. Claude Code는 더 개선하기 어렵다는 판단을 내리고 작업을 멈춰, 사람이 다시 탐색을 지시해야 했습니다. 그 결과 전체 경과 시간의 약 3분의 1이 대기하거나 막힌 상태였습니다. 반면 Codex는 작업을 계속 이어갔습니다.
Codex는 scratchpad(작업 계획과 판단을 파일에 남기는 메모 공간)를 적극적으로 쓰고 여러 하위 agent에 일을 나눴습니다. Claude Code는 메모와 하위 agent 활용이 상대적으로 적었습니다. Codex가 사용한 token은 약 7.5배 많았지만, 이 총량에는 입력과 캐시 처리도 포함됩니다. 따라서 많이 사용한 token을 곧바로 더 많은 아이디어나 더 높은 연구 효율로 해석할 수는 없습니다.
기록 개선과 새로운 발명은 다르다
이번 성과에는 기존 연구 결과에 접근할 수 있었다는 조건도 포함됩니다. Claude Code는 최신 인간 기록을 조회해 구체적인 목표로 삼았고, 5~6일 동안 이어진 장기 실험에서 Claude는 논문과 연구 자료를 778차례 조회했고, 다른 모델이 찾지 못한 논문의 기법이 가장 좋은 기록으로 이어졌습니다. 인간 기록을 넘었다는 결과는 분명하지만, 이를 인간의 선행 성과와 무관하게 처음부터 연구했다는 뜻으로 읽어서는 안 됩니다.
아이디어 자체를 따로 평가하자 다른 그림이 나왔습니다. 생성된 최적화 아이디어 212개 가운데 146개는 알려진 방법의 재구현이나 뚜렷한 조합으로 분류됐습니다. 18개는 실제 성능 개선을 낸 비자명한 구성으로 평가됐지만, 평가 기준상 처음부터 만들어낸 새로운 수학적 최적화 알고리즘은 0개였습니다. 이는 이 실험에서 확인된 한계이지, 모든 연구 과제에 대한 결론은 아닙니다.
작은 규모의 학습에서 좋은 결과를 낸 변경이 더 큰 모델에서도 통할지는 별도 검증이 필요합니다. Prime Intellect가 제안한 다음 단계에도 후보를 자동으로 평가한 뒤 더 큰 규모에서 다시 시험하고, 사람이 새 아이디어를 검토하는 과정이 포함돼 있습니다.
▲ 기록 개선과 발명의 차이
자율 연구 성과를 볼 때 확인할 것
이 실험은 정해진 목표와 검증 절차가 있는 최적화 작업에서 코딩 agent가 인간 기록을 개선할 수 있음을 보여줍니다. 동시에 작업을 끝까지 지속하는 능력, 사용한 자원, 아이디어의 독창성은 기록과 별도로 평가해야 함을 드러냅니다.
비슷한 성과를 접한다면 세 가지를 확인하면 됩니다. 무엇을 바꿀 수 있었고 기존 기록·논문에는 얼마나 접근할 수 있었는지, 개선이 통계적으로 검증됐는지, 실행 시간과 token 사용량까지 고려해도 의미 있는 성과인지입니다. Prime Intellect가 개발 중인 SpeedrunBench 역시 자료 접근 조건과 실험 환경을 나눠 비교하려는 계획입니다. 기록 한 줄보다 그 기록이 만들어진 조건을 함께 보는 것이 자율 연구 능력을 판단하는 출발점입니다.