AI agent(목표에 따라 여러 작업을 수행하는 AI 프로그램) 약 36개를 쓰는 회사라도, 운영의 중심은 도구의 개수가 아닙니다. 개발 과제를 배분하는 곳, 콘텐츠를 만드는 곳, 고객 데이터를 보관하는 곳을 구분하고 사람이 통제할 경계를 정해야 합니다. 한 AI 자동화 회사의 구성에서 특히 눈여겨볼 부분은 외부 서비스를 활용하면서도 교육 플랫폼과 핵심 데이터는 직접 운영한다는 선택입니다.
개발팀은 과제 관리와 모델 선택을 분리합니다
이 회사는 Linear를 개발 업무의 중심에 둡니다. 약 36개의 AI agent가 서로 다른 과제를 맡으며, 작업 목록에서 과제를 받아 기능을 만들고 품질 검사와 배포까지 이어갑니다. CMUX는 여러 코딩 agent의 작업 환경을 관리하는 데 씁니다. 사람이 모든 agent에게 개별적으로 지시하기보다 과제의 상태를 한곳에서 살피도록 구성한 셈입니다.
코딩 도구로는 Claude Code, Codex, Kimi, DeepSeek, Gemini를 사용합니다. 모델 요청은 OpenRouter를 거쳐 작업 성격에 따라 나눕니다. 반복량이 많은 비교적 단순한 업무에는 Gemini 2.5 Flash를, 복잡한 논리와 시스템 설계에는 Claude Sonnet 4를 배정합니다. 여러 모델을 같은 용도로 무작정 병렬 사용하기보다 난도와 비용을 기준으로 역할을 나눈 구성입니다.
일상적인 컴퓨터 작업에는 Mac과 Alfred를 씁니다. 다만 이 사례에서 더 중요한 관리 지점은 컴퓨터 종류보다 개발 흐름입니다. 어떤 과제를 agent에게 넘길지, 결과를 어떤 기준으로 검사할지, 배포를 언제 허용할지는 도구 목록만으로 해결되지 않습니다.
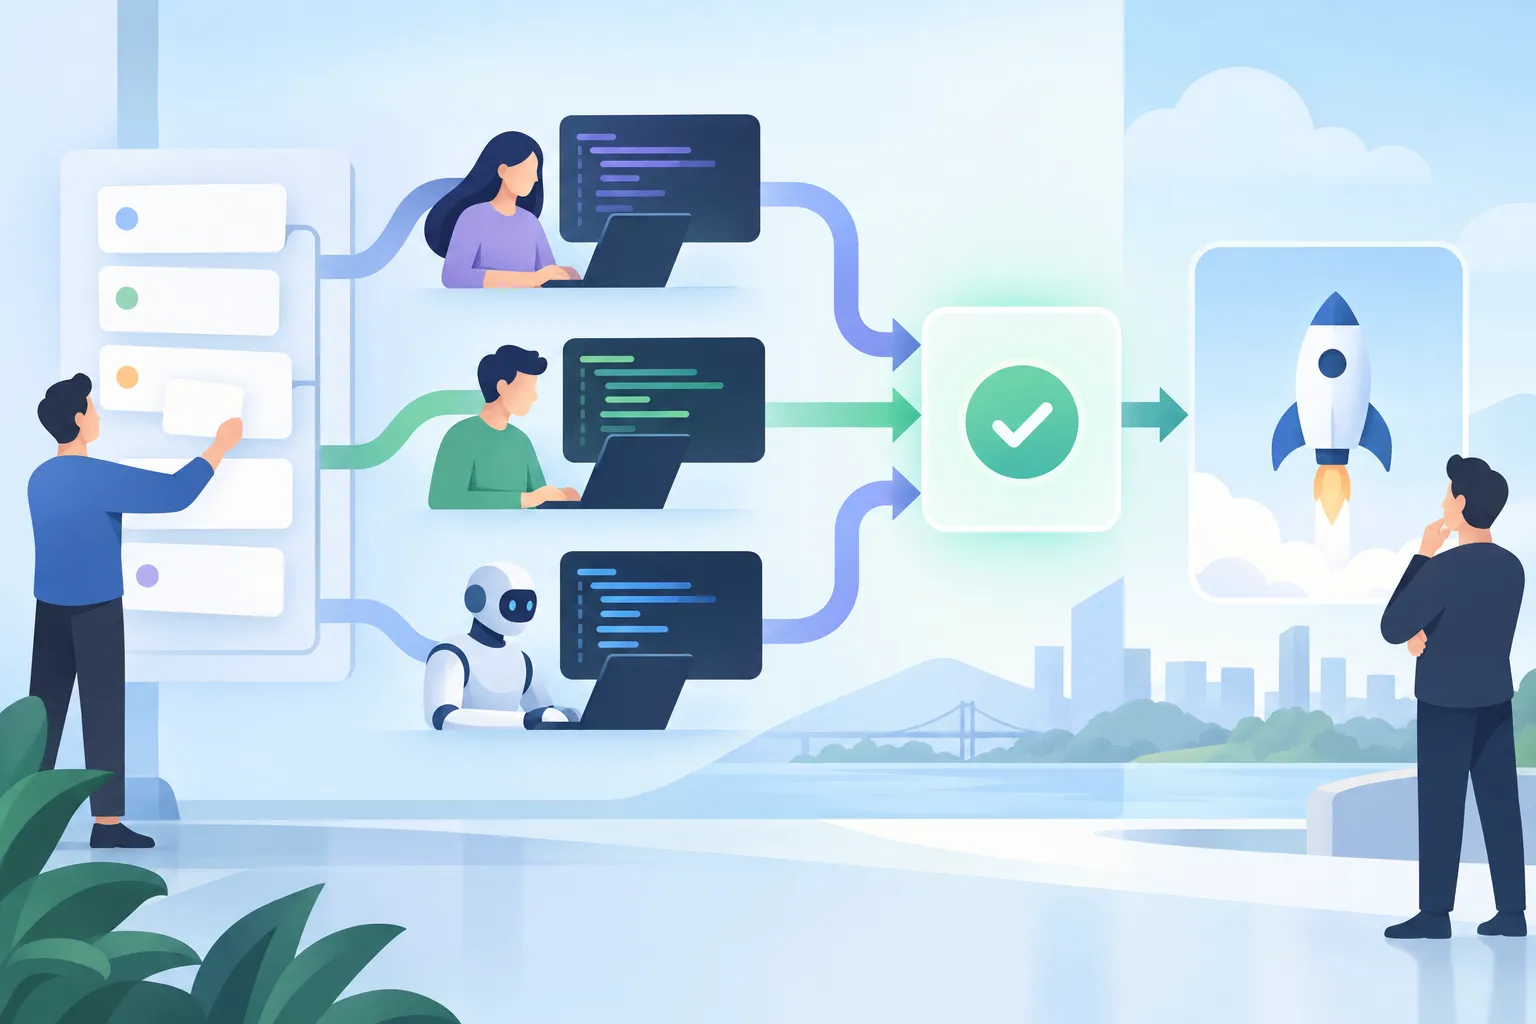
▲ 개발 과제 관리
자체 호스팅은 모든 외부 서비스를 끊는다는 뜻이 아닙니다
교육 과정과 커뮤니티 자료, 수업 운영을 담는 학습 관리 플랫폼은 직접 구축해 호스팅합니다. 서버는 Railway에 두고, 구조화된 사업 데이터는 PostgreSQL에 저장합니다. 이 회사는 Railway에서 PostgreSQL을 별도 데이터베이스 요금 없이 사용하는 방식이라고 설명합니다. Cloudflare는 도메인 관련 설정과 보호 기능뿐 아니라 이미지·영상 파일을 보관하는 데도 활용합니다.
이 선택의 이유는 구독형 플랫폼에 사업의 핵심 기능을 전부 맡기지 않기 위해서입니다. Circle이나 GoHighLevel 같은 서비스에 교육 공간, 고객 유입 경로, 업무 흐름을 구축하면 구독을 중단했을 때 그 운영 환경과 기존 데이터에 접근하기 어려워질 수 있다고 봅니다. 반면 자체 코드와 데이터베이스를 관리하면 필요한 고객 관리 기능을 직접 연결하거나 고칠 여지가 생깁니다.
그렇다고 외부 서비스를 쓰지 않는 것은 아닙니다. 서버와 파일 보관에도 Railway와 Cloudflare를 이용합니다. 여기서 자체 호스팅은 모든 장비를 소유한다는 의미보다, 사업의 핵심 프로그램과 데이터를 특정 구독형 업무 플랫폼에만 묶어 두지 않겠다는 운영 선택에 가깝습니다. 대신 배포 상태와 데이터 보관 구조를 직접 살펴야 하는 책임도 남습니다.
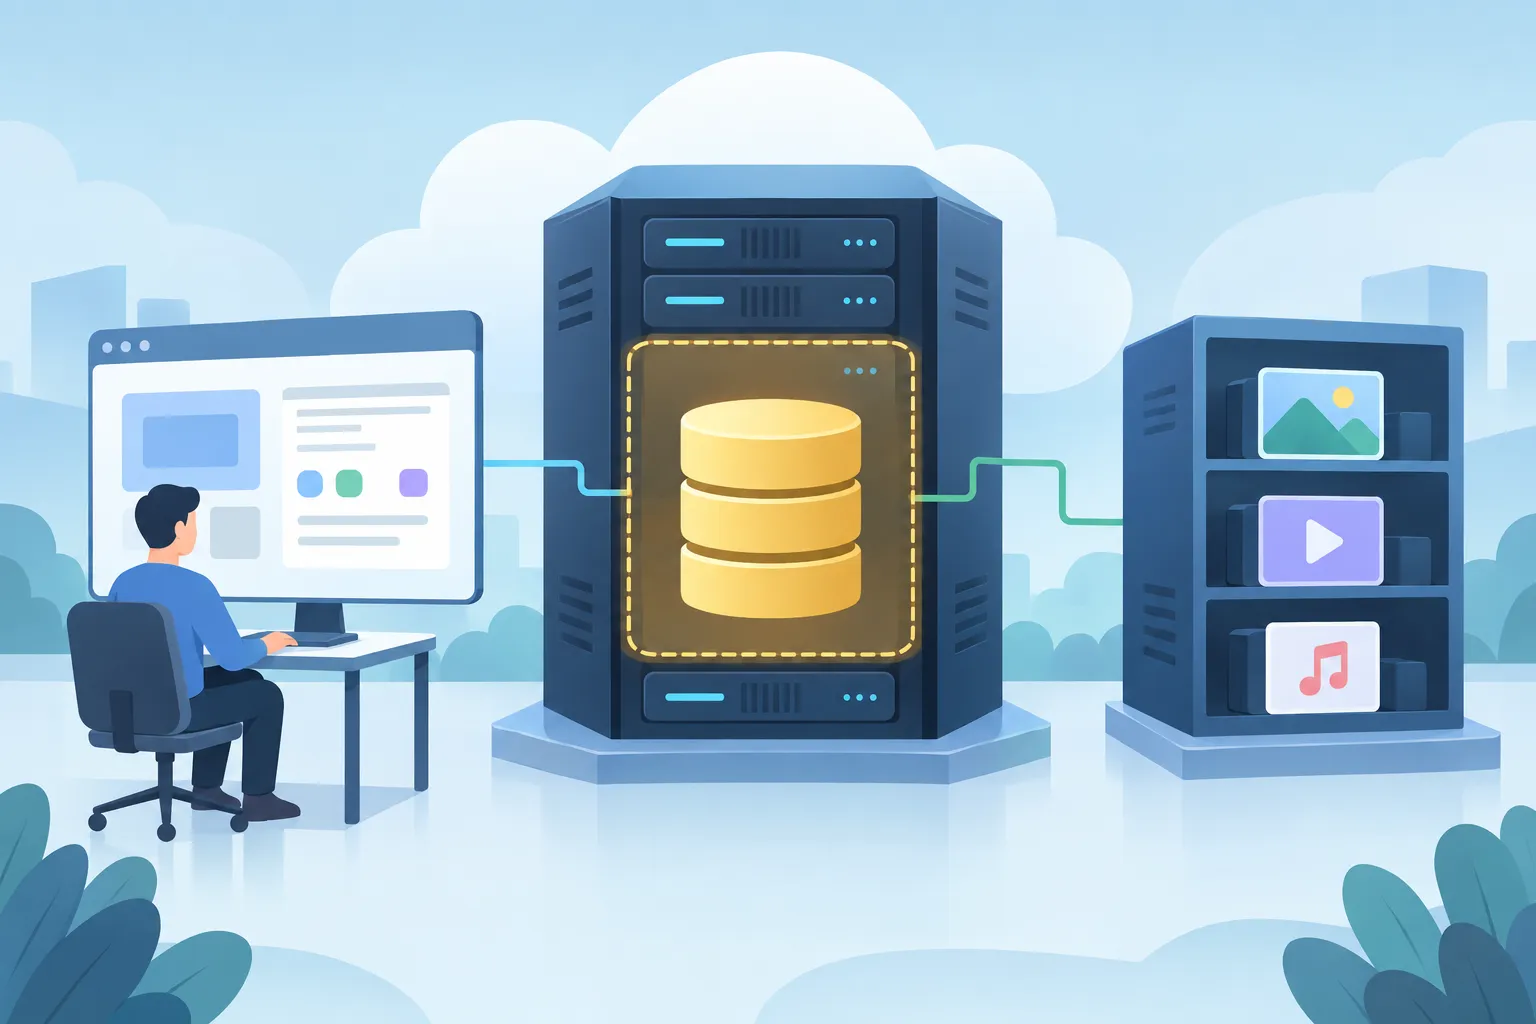
▲ 자체 호스팅 구조
콘텐츠와 고객 접점에는 목적별 도구를 씁니다
콘텐츠 제작에도 한 도구가 전 과정을 맡지는 않습니다. CAM은 짧은 형식과 긴 형식의 콘텐츠 제작 자동화에, Gling은 촬영한 영상에서 긴 침묵·다시 찍은 부분·군더더기 표현을 덜어내는 편집에 씁니다. 이 회사는 매주 새 교육 과정을 제작하던 시기에 Gling을 도입했습니다. 완성한 게시물은 Zernio로 여러 소셜 채널에 배포하고, 실시간 콘텐츠 송출에는 Streamlabs를 사용합니다. 이미지·영상 자산 생성에는 Kie.ai를 활용합니다.
업무 보조도 기능별로 나뉩니다. Resend는 발송용 이메일에, Himalaya는 여러 계정의 이메일을 읽고 정리하는 명령줄 도구로 사용합니다. 자체 제작한 업무 보조 agent는 회사 데이터에 연결해 연락 내용을 정리하고 일정과 콘텐츠 작업을 돕습니다. 1Password는 계정 정보를 모아 관리하고, Wispr Flow는 말로 입력한 내용을 글로 바꿔 prompt(모델에 전달하는 작업 지시)를 작성할 때 씁니다.
회의 도구의 구분도 분명합니다. Fathom AI는 고객의 첫 상담과 업무 범위 논의를 기록하고 요약과 후속 조치를 정리합니다. Granola AI는 영업 통화 중 대화 내용을 기록하며 질문이나 가격에 관한 이의에 대응할 때 참고할 제안을 제공합니다. 기록이 필요한 회의와 즉석 판단이 필요한 회의를 같은 일로 보지 않는 구성입니다.
도입 전에는 사람이 맡을 경계부터 정해야 합니다
이 회사는 자체 데이터베이스와 맞춤형 개발 환경을 바탕으로 고객 한 곳에 한 주 최대 60개의 기능을 낸 사례를 제시합니다. 이는 해당 회사의 운영 사례이지, 도구를 똑같이 도입하면 얻을 수 있는 일반적인 성과는 아닙니다. 오히려 여러 agent와 서비스를 연결할수록 사람이 확인할 지점이 선명해야 한다는 점에 주목할 만합니다.
- 먼저 반복되는 개발·콘텐츠·회의 업무를 나누고, 각각의 결과를 어디에서 확인할지 정합니다.
- 다음으로 고객 데이터와 핵심 업무 흐름이 어느 서비스에 저장되는지, 구독을 중단하면 무엇에 접근할 수 없게 되는지 살핍니다.
- 마지막으로 이메일 발송·삭제, 고객에게 전달할 내용, 코드 배포처럼 되돌리기 어렵거나 대외적인 작업은 사람이 승인할 범위를 정합니다.
AI agent의 수를 늘리기 전에 과제 관리 체계와 데이터 보관 방식을 먼저 그려보는 것이 이 사례에서 얻을 수 있는 실용적인 출발점입니다.