Google DeepMindのGemma 4は、サーバーを一切呼び出さずに、普通のWebブラウザの中で詳しい依頼に答えられるようになりました。モデルがユーザー自身のデバイスで動くため、データが端末の外に出ることはなく、API料金もネットワークの往復待ちもありません。Gemma 4は寛容なApache 2.0ライセンスで提供され、スマートフォンで動く2Bモデルから1枚のGPUに収まる31Bモデルまで5つのサイズがあります。開発者にとって、ローカル推論は実験ではなく現実的な設計上の選択肢になったといえます。
毎週新機能を出す研究組織
Google DeepMindは、人類に役立つAIを責任を持って構築することを使命に掲げています。この使命には、タンパク質の構造を予測するAlphaFoldや、医療・生物学向けのオープンモデルMed-Gemmaといった科学分野の取り組みに加え、数学やロボティクスの研究も含まれます。こうした研究と並行して、Googleはフロンティアモデル、オープンモデル、プラットフォームAPIのすべてで毎週アップデートを出すほどの速いペースで製品を投入しています。
最近の開発者向けリリースは次のとおりです。
- Computer Use API:AIモデルがコンピューターを直接操作する「コンピューター操作」のためのAPI
- Managed Agents:自然言語で大まかな指示を与えると、サンドボックス化されたLinuxワークステーション上で動く自律型エージェント(タスクを自ら計画して実行するAIシステム)の一団に作業を任せる機能
- Speech-to-Speech translation API:ある言語の音声を別の言語の音声に変換するAPI
このラインアップのフロンティア側に位置するのが、クラウドで提供されるGeminiモデルです。Gemma 4はその反対側、つまり開発者が自分でダウンロードして動かすモデルを担います。
5つのサイズと寛容なライセンス
Gemma 4はオープンウェイトのモデルファミリーです。Googleが学習済みのパラメーターを公開しており、誰でもダウンロードできます。Apache 2.0ライセンスにより、商用利用、改変、そしてファインチューニング(特定のタスク向けにモデルを追加学習させる工程)をライセンス料なしで行えます。
| モデル | アーキテクチャ | 適した環境 |
|---|---|---|
| 2B (E2B) | 小型 | スマートフォンとブラウザ |
| 4B (E4B) | 小型 | スマートフォンとノートPC |
| 12B | 中型 | 一般的な開発者向けノートPC |
| 26B (26B-A4B) | Mixture-of-experts | GPU 1枚 |
| 31B | Dense | GPU 1枚 |
Mixture-of-expertsモデルは、リクエストごとに専門化された一部のサブネットワークだけを通して処理します。一方、Denseモデルは毎回すべてのパラメーターを使います。12B以下のモデルは一般的な開発者向けノートPCで動き、2Bモデルは専用のAIハードウェアを備えたスマートフォンで動きます。さらに軽量なモデルは、Jetson Nanoのような小型のエッジボードでも動かせます。
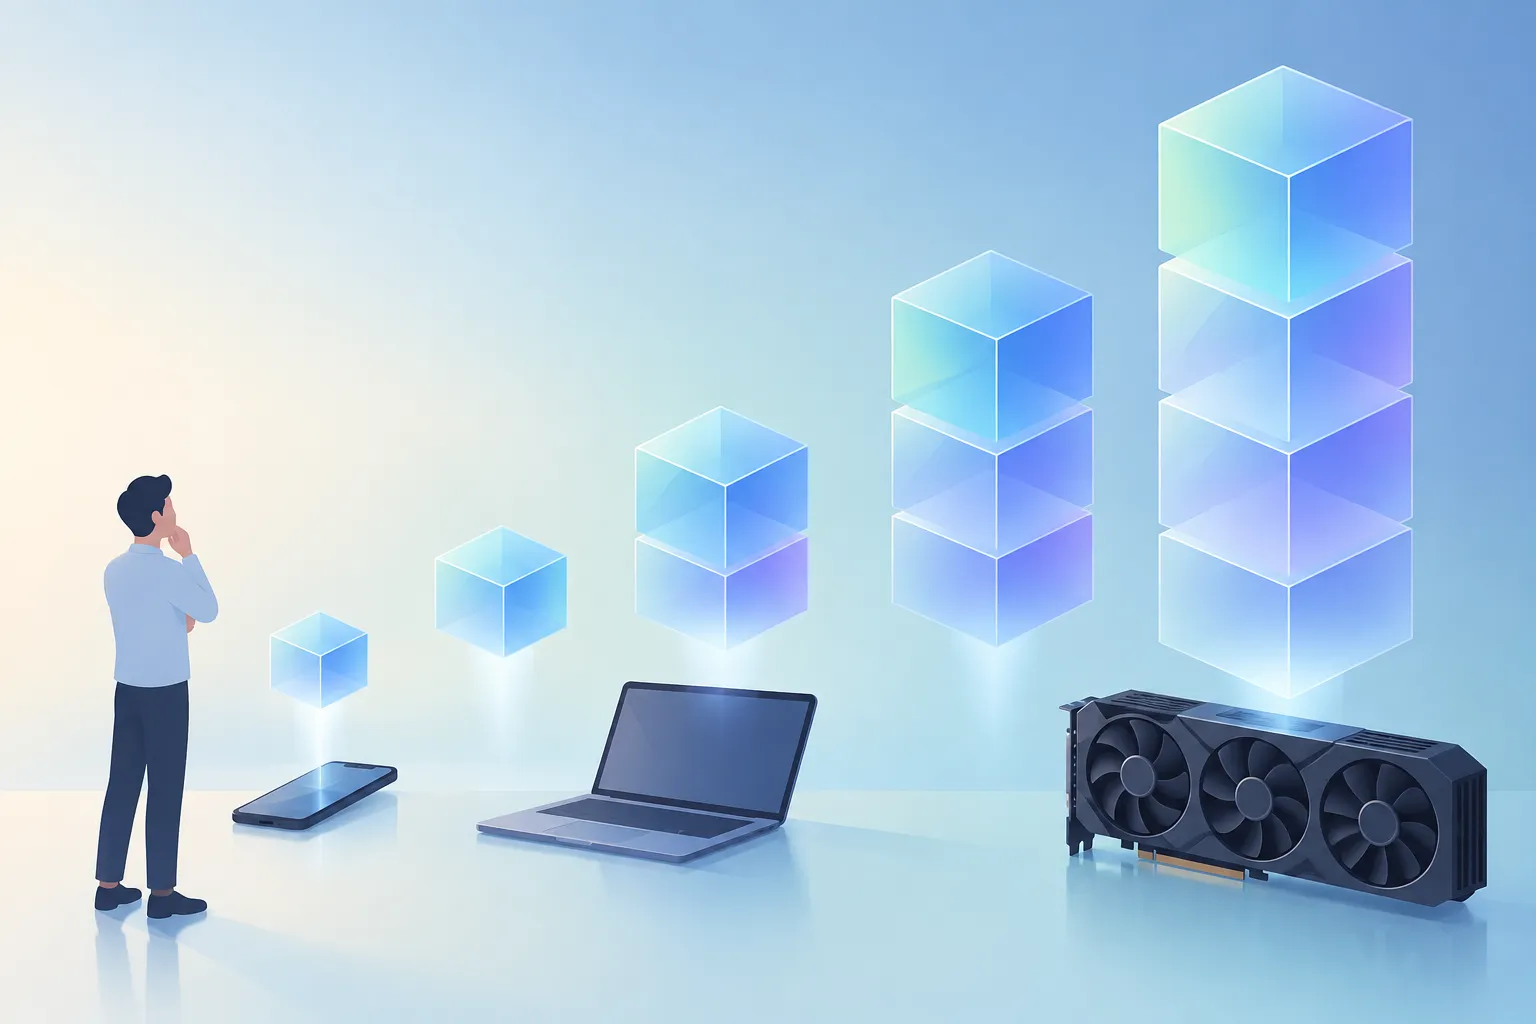
▲ ハードウェア別のGemma 4のサイズ
ブラウザの外に出ない推論
Gemma 4の最小モデルは、Webブラウザ内でクライアント側だけで完結して動かせます。この構成では、Transformers.jsと、ブラウザで高速なコンパイル済みコードを動かす技術であるWebAssemblyを組み合わせ、完全にサンドボックス化された環境で実行します。重い計算は、Fable 5で最適化した独自のGPUカーネルが担います。ただし、こうした初期の生成カーネルは、広く配布できる状態になるまでに調整と書き直しが必要でした。
試しに、Harry Potterシリーズの全巻をユーモアと興奮度で比較し、読むべき巻のおすすめも添えた絵文字入りの表を作るようモデルに依頼しました。モデルはすぐに、各巻の面白さ、興奮度、全体の雰囲気、おすすめを列に分けた構造化されたMarkdownの表を返しました。ランキングに誰もが同意するとは限りませんが、重要なのは、複数の要素を含む依頼がサーバーに一切触れずに整理された回答になった点です。
ブラウザでの実行では、次の測定値が得られました。
| 指標 | 結果 |
|---|---|
| 最初のトークンまでの時間 | 0.25秒 |
| プレフィル速度 | 毎秒85.71トークン |
| デコード速度 | 毎秒20.72トークン |
トークンは、モデルが読み書きするテキストの小さな単位です。プレフィルはモデルがプロンプトを読み込む段階、デコードは回答を書き出す段階を指します。これらはすべてデバイス上で行われるため、ユーザーのデータがブラウザの外に出ることはありません。個人情報を扱うアプリや、サーバーコストを抑える必要があるアプリにとって特に有用だと考えられます。
Google AI Edge Galleryで試すオンデバイスAI
Google AI Edge Galleryは、Android、iOS、macOS向けのアプリで、AIモデルをオフラインのまま端末上で直接試せます。主な機能は次のとおりです。
- Ask Image:画像の内容を説明し、画像に関する質問に答える
- Audio Scribe:140を超える言語の音声を、オフラインで文字起こしして翻訳する
- オンデバイスの関数呼び出し:モデルがアプリの操作を実行し、構造化された情報を抽出し、端末のカレンダーに予定を直接追加する
- ミニアプリ:Tiny Gardenゲーム、Haiku Card、天気照会ツール、2048ゲームなどの小さな例
Google Pixel 10のようにニューラルプロセッシングユニットとGPUを備えたスマートフォンでは、CPUに負担をかけずにGemmaモデルがスムーズに動きます。こうしたアクセラレーターを持たない下位機種では、処理がCPUに回されると性能が落ちる場合があります。
▲ オフラインのオンデバイスAI
小さなモデルで大型モデル並みのスコア
性能をパラメーター数に対してプロットしたEloのチャートでは、Gemma 4の26Bと31Bの思考モデルが約1440から1460のスコアを記録しています。ここでのEloは、モデル同士の対戦成績を表す相対的な評価です。これらのスコアは、パラメーター数が約10倍の競合モデルを上回ります。また、モデルが小さければ多数のマシンにまたがる分散推論が不要になり、インフラコストを削減できます。
Quantization-Aware Training、略してQATを使うと、メモリ使用量をさらに減らせます。量子化はモデルの数値を低い精度で保存する手法で、QATはその低い精度を前提にモデルを学習させることで、より多くの能力を保ちます。形式別のGemma 4の必要メモリは次のとおりです。
| モデル | BF16、16ビット | Q4_0、4ビット | モバイル | モバイル・テキスト専用 |
|---|---|---|---|---|
| 2B | 11.4 GB | 2.9 GB | 1.1 GB | 0.84 GB |
| 4B | 17.9 GB | 4.5 GB | 2.5 GB | 2.2 GB |
| 12B | 26.7 GB | 6.7 GB | - | - |
| 26B | 57.7 GB | 14.4 GB | - | - |
| 31B | 69.9 GB | 17.5 GB | - | - |
2Bモデルは16ビット精度の11.4 GBから、モバイル・テキスト専用形式では0.84 GBまで小さくなります。つまり、1 GBに満たないメモリのスマートフォンで言語モデルを動かせるということです。
ローカル推論を検討するなら
Gemma 4を使えば、これまでクラウドAPIに送っていた処理の一部をブラウザやスマートフォンに移せます。データは端末内にとどまり、呼び出しごとの料金やネットワークの遅延もなく、ライセンスは商用製品にも余地を残しています。現実的な進め方は次のとおりです。
- 独自アプリを作る前に、対応予定のデバイスでGoogle AI Edge Galleryを使ってモデルを試します。
- デバイスのメモリに合うモデルサイズを選び、メモリが厳しい場合はQATチェックポイントを使います。
- Webアプリなら、Transformers.jsとWebAssemblyでブラウザ内推論の試作を作ります。
- 自社の領域に合わせる必要があれば、Apache 2.0ライセンスのもとでファインチューニングします。
専用アクセラレーターのないスマートフォンでは性能が落ちる可能性があるため、ユーザーが実際に使っているハードウェアを確認しましょう。性能の低いデバイス向けにクラウドAPIを予備として残しておくほうが、安全な構成といえそうです。