Google DeepMindは、エージェント向けにGemini APIの土台を作り直しました。新しいInteractions APIは、短いモデル呼び出しと長時間動くエージェントの処理を一つのエンドポイントで受け付け、会話と推論の状態をGoogleのサーバー側で保持できます。開発者が履歴を手作業でつなぎ合わせる必要はなくなります。さらにManaged Agentsにより、GeminiはAPI呼び出し一回で専用のLinuxサンドボックス、つまりコードを実行するための隔離されたコンピューターを使えるようになりました。Geminiでエージェントを構築するチームにとって、今回の更新は状態管理、実行環境、秘密情報の扱いという三つの手間をプラットフォーム側へ移すものとみられます。
従来のAPIが追いつかなくなった理由
開発者による言語モデルの使い方は、三つの段階を経てきました。最初は単純な補完です。「ジョークを言って」といったプロンプトを送ると、ひとかたまりのテキストが返ってきます。次に、アプリケーションが確実に扱える出力が求められるようになり、function callingが生まれました。モデルが関数名と引数を記した構造化JSONオブジェクトを返す仕組みです。ニューヨーク市の天気を尋ねると、モデルは天気関数の呼び出しを返します。バックエンドのサーバーは、ユーザー名とパスワードを含む登録フォームを処理するのと同じようにそのデータを扱えます。
現在のモデルはさらに先へ進んでいます。目標を受け取って推論し、複数のツールを使い、答えを返すまで長い時間作業を続けることもあります。Google DeepMindはエージェントを次の四つの要素の組み合わせとして説明しています。
| 要素 | 役割 |
|---|---|
| モデルの推論 | ユーザーの意図を解釈し、次の行動を決める |
| ツール | 検索、コード実行、カスタム関数 |
| コンテキストとメモリー | 短期と長期の記憶の呼び出し |
| 実行環境 | コードや関数が動くサンドボックス |
Google DeepMindのあるデベロッパーエクスペリエンス担当エンジニアは、高性能なモデルほど壊れやすい補助的な仕組みを必要としなくなったと主張します。ファイルの読み取りと編集に別々のツールを用意しなくても、Claude OpusやClaude Haikuといったモデルは一つのbashツールで作業することが多いといいます。より難しいのは時間の問題です。かつては一回のやり取りで終わっていた処理が、今では裏側で動くようになりました。3分以上かけて調べ、長いレポートを仕上げるディープリサーチエージェントがその例です。従来のAPIでは、開発者は深く入れ子になったJSONから結果を掘り出し、会話履歴を自分で管理する必要がありました。
一つのIDで会話と推論を引き継ぐ
Interactions APIの中心は、オプションのサーバー側状態管理です。各レスポンスにはinteraction IDが付いています。次の呼び出しでこれをprevious_interaction_idとして渡すと、サーバーはそれまでの会話とモデル内部の推論状態を復元します。
これが重要なのは、thought signatureがあるためです。最近のGeminiモデルは推論の過程を外から読めない符号化された値として記録し、モデルが本来の性能を発揮するには次のターンでその値を返す必要があります。Google DeepMindによると、これが欠けると推論の質が目に見えて落ちます。履歴を手作業で組み立て直す方法も壊れやすく、空白が一つ変わっただけでサーバーのキャッシュが無効になることがあります。IDを一つ送るだけの方式なら、この種の不具合をまとめてなくせます。
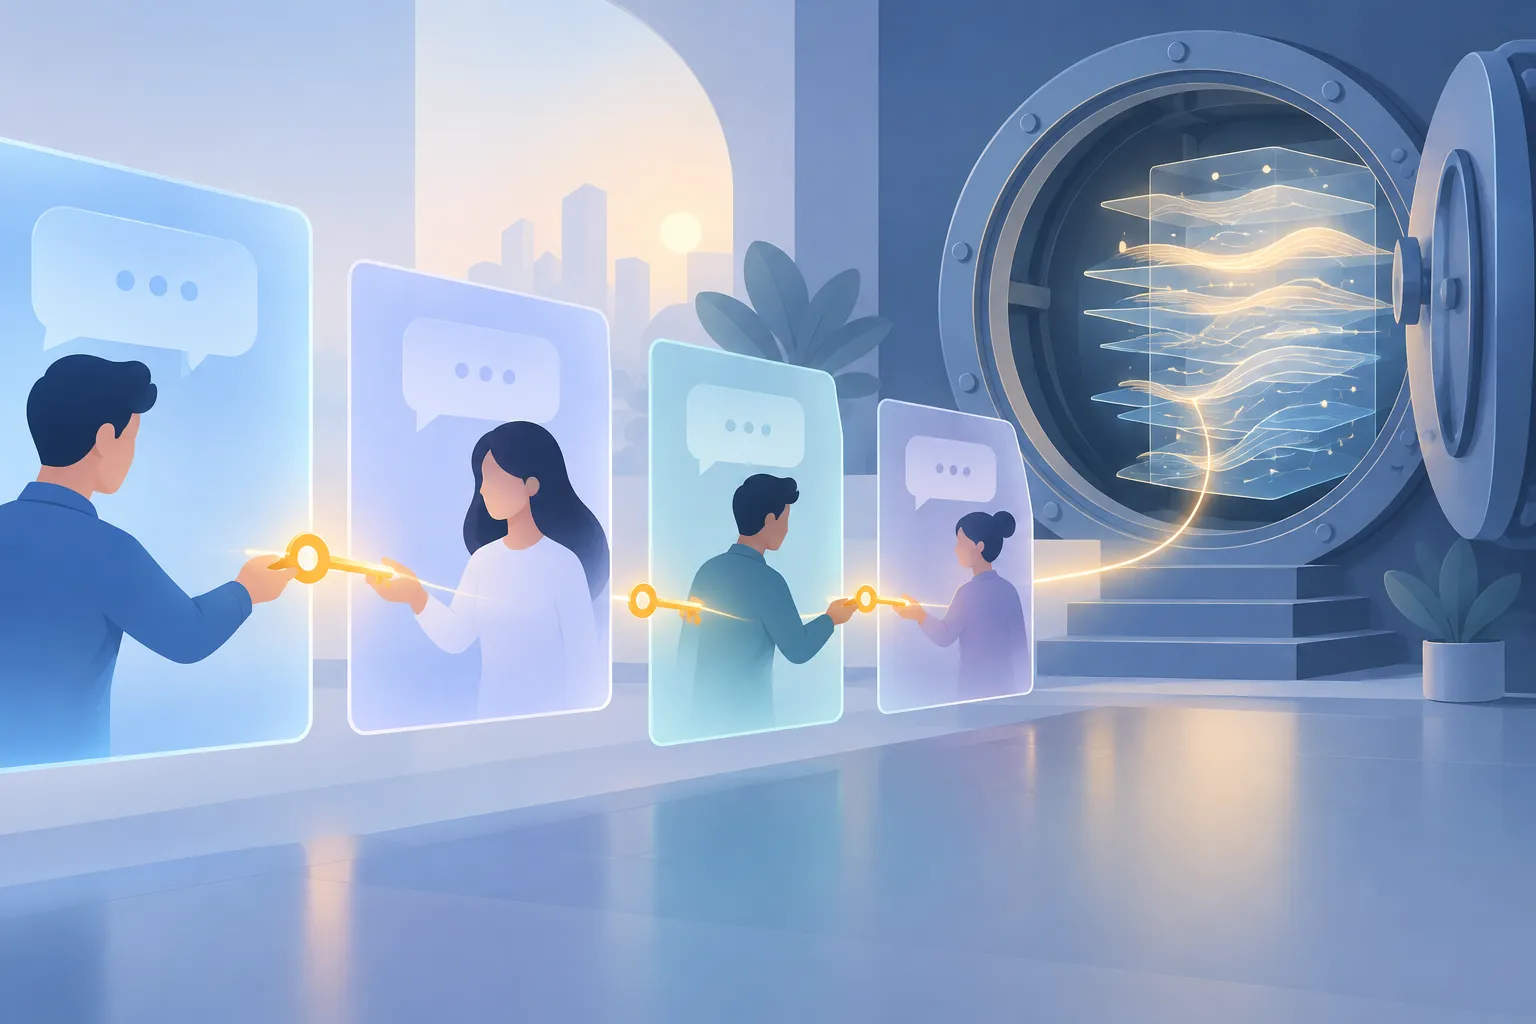
▲ interaction IDで引き継ぐ状態
出力も整理されました。テキスト、音声、画像のレスポンスは型が厳密に決まったオブジェクトとして返るため、入れ子の辞書をたどるパスをハードコードせず、output.typeで処理を分けられます。出力の種類を切り替えるときも、generation_configやresponse_modalitiesといった設定を変えるだけです。Google DeepMindのチームメンバーが作った旅行シミュレーターがその一例です。顔写真を1枚アップロードすると、ベネチアの運河やノイシュヴァンシュタイン城といった場所にその人物がいる画像を並列で生成し、さらにinteraction IDを引き継いで最初のフレームを動くクリップに変えます。
ツール呼び出しとSteps Data Model
Geminiは一回のAPI呼び出しの中で、何を知る必要があるかを判断し、ツールを呼び出して答えを返せます。Google SearchとURLコンテキストツールを使えば、モデルの学習データの期限より後のウェブ情報も取り込めます。同じリクエストにカスタム関数を含めることもできます。たとえば、セキュリティ上の問題を社内のチケットシステムに登録するfile_incidentツールです。これにより、エージェントは調べることと対応することを一度に進められます。
こうした複数ステップの処理を記録するため、Googleは従来のoutputs配列をSteps Data Modelに置き換えました。インタラクション中にモデルが行ったすべてのことを、型が厳密に決まった時系列として残す仕組みです。
| 要素 | 内容 |
|---|---|
| ステップの種類 | モデル出力、思考、関数呼び出し、Google Search呼び出しなど |
| 状態 | 完了、待機中、実行中 |
| 構造化フィールド | ツール名、引数、thought signature |
| コンテンツ | テキスト、画像、音声、動画の生データ |
Managed AgentsでAPIの裏にサンドボックスを用意
Antigravityをリモートエージェントとして動かすManaged Agentsでは、Googleが管理する安全なLinuxサンドボックスの中でGeminiが自律的に作業します。標準のツールには、bashによるコード実行、ファイルシステムへのアクセス、ウェブ検索、URLコンテキスト、エージェントスキルが含まれます。これまでコーディングエージェント、つまりコードを書いて実行するエージェントを作るには、ハーネスを自分で調整し、外部のサンドボックス基盤を探して設定し、コンテキストを保つ方法も考えなければなりませんでした。今は一回のAPI呼び出しで、状態が保たれるサンドボックスを使えます。
ある例では、エージェントがGitHubリポジトリを受け取ってクローンし、ディレクトリを一覧し、ソースファイルを一つずつ読んで、人の手を借りずにプロジェクトの概要をまとめました。別の例では、独自のプログラミング言語と強化学習のループを作ったハッカソンの応募作品を複数ターンにわたって評価し、モデルが処理するテキストの単位であるトークンを200万以上使いながら、サンドボックスの状態を失いませんでした。
複数ターンの作業では、二つの値を保持することが鍵になります。
| 値 | 保持するもの |
|---|---|
| interaction ID | 会話と推論のコンテキスト |
| environment_id | 既存サンドボックスのファイルと実行状態 |
サンドボックスには、Google Cloud Storageのバケット、GitHubリポジトリ、設定値やセットアップスクリプトといったインラインファイルを事前に読み込ませておけます。
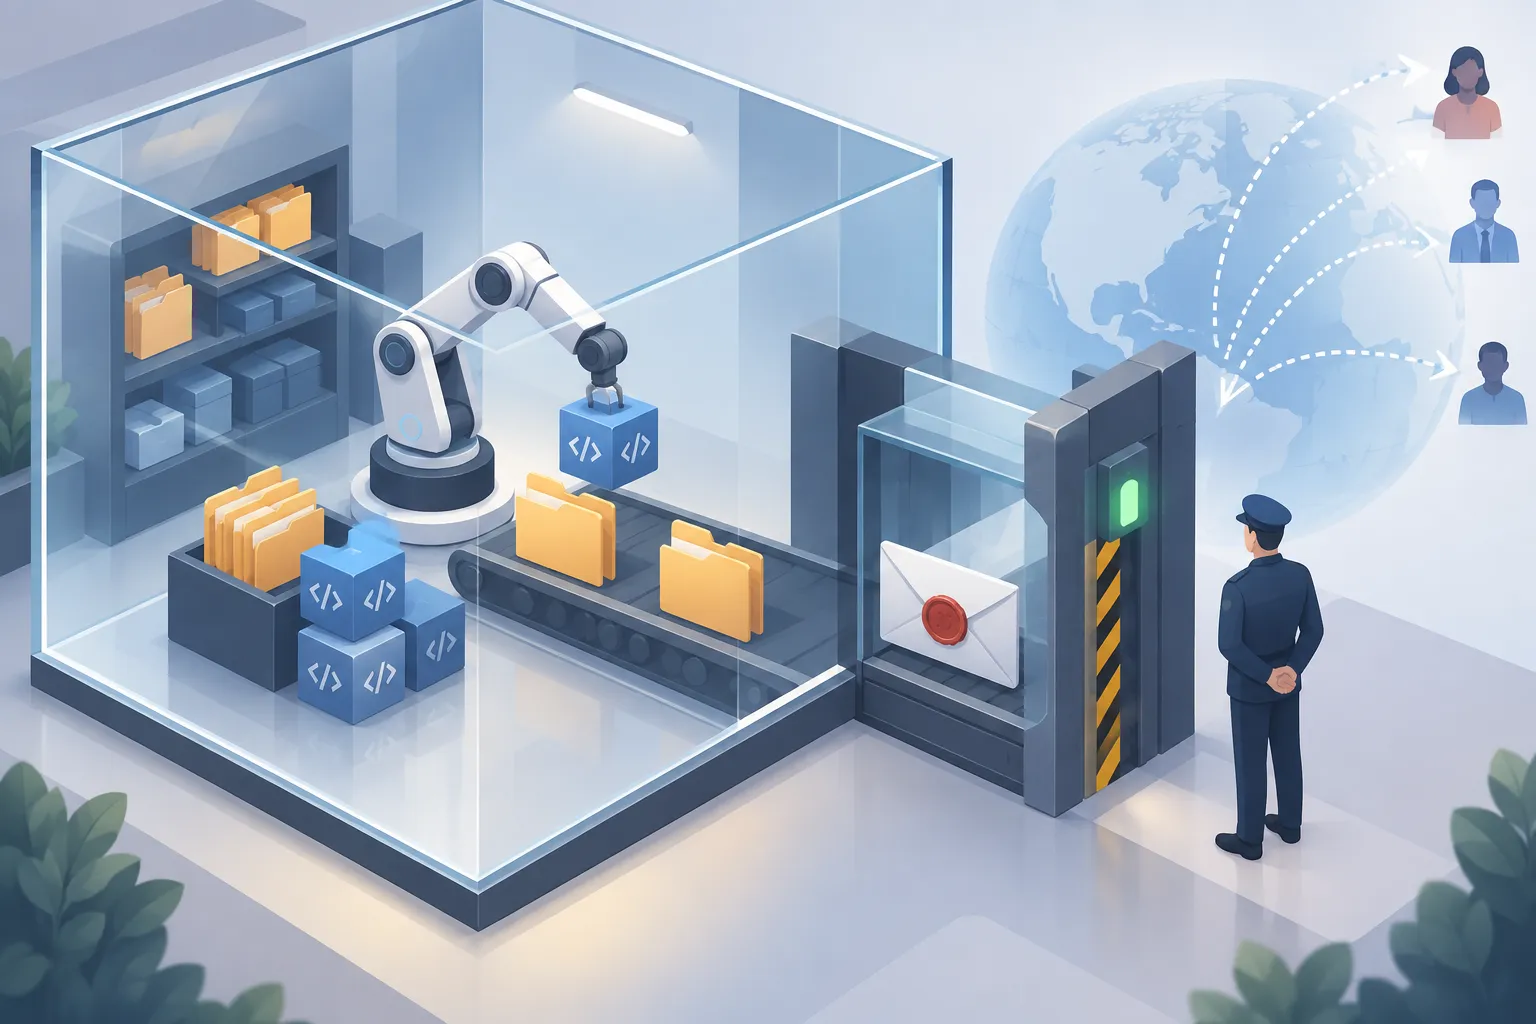
▲ サンドボックスとネットワークプロキシ
ネットワークプロキシで秘密情報をモデルから遠ざける
開発者からは、認証情報の漏えいやプロンプトインジェクションからエージェントをどう守るかという質問がよく寄せられます。プロンプトインジェクションとは、モデルが読み込むコンテンツに指示を隠しておく攻撃です。Googleの答えは、マネージドの中間者型ネットワークプロキシです。サンドボックス内のコードがGitHub APIのような外部サービスにリクエストを送ると、プロキシがそれを受け止め、送信時にヘッダーへ認証トークンを加えます。
モデルが生の秘密情報を目にしたり保持したりすることはありません。攻撃者がプロンプトインジェクションでモデルにメモリーや環境を出力させたとしても、APIキーはそもそもモデル側にないため漏れません。キーをプロンプトや、モデルが読める環境変数に入れる方法と比べると、防御線をモデルの外へ完全に移したといえそうです。
名前付きエージェント、CLI、スキルのリポジトリ
調整済みの指示、ファイル、依存関係の組み合わせは、二つの方法で名前付きのカスタムManaged Agentとして固定できます。
- ソースから作る:必要なスキルと設定ファイルを記したベースのエージェント仕様を書く。
- スナップショットから作る:サンドボックス内でエージェントと対話しながら必要なライブラリをインストールし、その環境を保存して名前を付ける。
名前付きエージェントは1プロジェクトあたり最大1,000個まで作れます。Googleは環境の保存やアイドル状態のサンドボックスには料金をかけず、課金はモデルのトークン使用量だけです。
ターミナルでは、オープンソースのGemini API CLIを使って任意のモデルにプロンプトを送り、エージェントを作成、テスト、デプロイできます。既存のコーディングエージェントを新しいAPIへ移すために、GoogleはGitHubでgemini-skillsリポジトリを公開しました。モデルは学習中によく目にした古いバージョン、たとえばGemini 2.0やGemini 2.5 Flash向けのコードに戻りがちなので、新しいAPIを説明するスキルを与えると最新のパターンに導けます。Googleは、生成されるコードが最新のベストプラクティスに沿うよう、これらのスキルの評価を続けているとしています。
Gemini開発者が今見直すべきこと
Interactions APIとManaged Agentsは、状態管理、インフラ、秘密情報の扱いを開発者の手から引き取る試みに見えます。Geminiでエージェントを構築しているなら、次の点を確認する価値があります。
- 複数ターンの履歴を手作業で組み立て直すのをやめる。各レスポンスのinteraction IDを
previous_interaction_idとして渡すのが、thought signatureを保つ最も簡単な方法です。 - マルチモーダルのレスポンスは、入れ子のパスをハードコードせず
output.typeを確認して処理する。 - Managed Agentsを使う場合は、interaction IDと
environment_idの両方を保存し、コンテキストとサンドボックスを維持する。 - APIキーはプロンプトや環境変数ではなく、ネットワークプロキシ経由で注入する。
- gemini-skillsリポジトリのInteractions APIスキルをコーディングエージェントに追加し、名前付きエージェントとして固定する前にGemini API CLIでテストする。
設定なしですぐ試すなら、無料枠のあるGoogle AI Studioでモデルを試せます。