OpenAIがDevDayで発表したGPT-6.1 Solは、実際に試したテストで、アプリが連携して動くブラウザー上のデスクトップと、遊べる3Dゲーム2本を作りました。ただし、見た目のデザインや物理的な制御の課題では結果にばらつきがありました。最初に作った3Dの見た目は、同じ課題に取り組んだClaude Sonnet 5.5の先行例ほど洗練されておらず、見本となる画像を渡すとその差は縮まりました。
仕様とベンチマークのスコア
OpenAIはGPT-6.1 Solを、GPT-6 Astraに近い知能をより低いコストで提供するモデルと位置づけています。APIの価格は入力100万トークンあたり$2、出力100万トークンあたり$10で、Claude Sonnet 5.5の価格と同じです。入力と出力のトークンは、モデルに送る内容とモデルが生成する内容を数える単位です。価格が同じだからといって、どちらのモデルがより良いアプリを作るかが決まるわけではありません。
ソフトウェアエンジニアリングのベンチマークであるDeepSWE v1.1も、もう1つの参考になります。GPT-6.1 Solの結果は、モデルがタスクにどれだけ取り組むかを変える推論の設定によって異なります。
| 推論の設定 | DeepSWE v1.1のスコア | タスクあたりのコスト |
|---|---|---|
| High | 75.2% | $0.65 |
| Maximum | 71.9% | $0.97 |
このベンチマークで、GPT-6.1 SolはGPT-6 Astraの基本性能に並び、GPT-6 Solを6.4ポイント上回りました。高い設定のほうがスコアが低いのは、モデルが評価の想定を超えてタスクを複雑にしてしまうことがあるという、知られた現象によるものです。APIのモデル一覧によると、GPT-6.1 Solのコンテキストウィンドウは105万トークン、出力の上限は12万8,000トークン、学習データの基準日は2026年4月30日で、テキストと画像を入力でき、テキストを出力します。
これらのスコアはベンチマークでの性能を測るもので、ゲームの仕上がりやロボットの把持の成否を示すものではありません。アプリ制作のテストは、そうした結果をより近くから見せてくれます。
アプリ同士が連携して動くブラウザー上のデスクトップ
最もはっきりしたソフトウェアの成果は、最大の推論設定で33分42秒かけて生成されたHalo OSです。これは1つのHTMLファイル、つまりブラウザーがページを表示するために読み込む形式に収まった、自己完結型のブラウザー上のデスクトップです。Google Chromeで開くと、ウィンドウ、ドック、ランチパッド、メモ、メール、シンセサイザー、壁紙の変更やセッションの保存のためのツールが表示されました。ドックとサイドバーの一部のアイコンは表示されませんでしたが、デスクトップと主要なアプリは動きました。
ウィンドウの中では2本のゲームが動きました。Signal Cityは、ローポリの街並み、運転できる車、荷物の配達、歩行者を備えていました。車の操作とカメラの反応は良好でしたが、パトカーがプレイヤーの車のすぐ横や真上に現れることがありました。Orbital Runでは、宇宙船を操縦してリングや障害物の間を抜けます。コースを完走すると4,216点が与えられ、デスクトップのメールアプリに証明書が届きました。
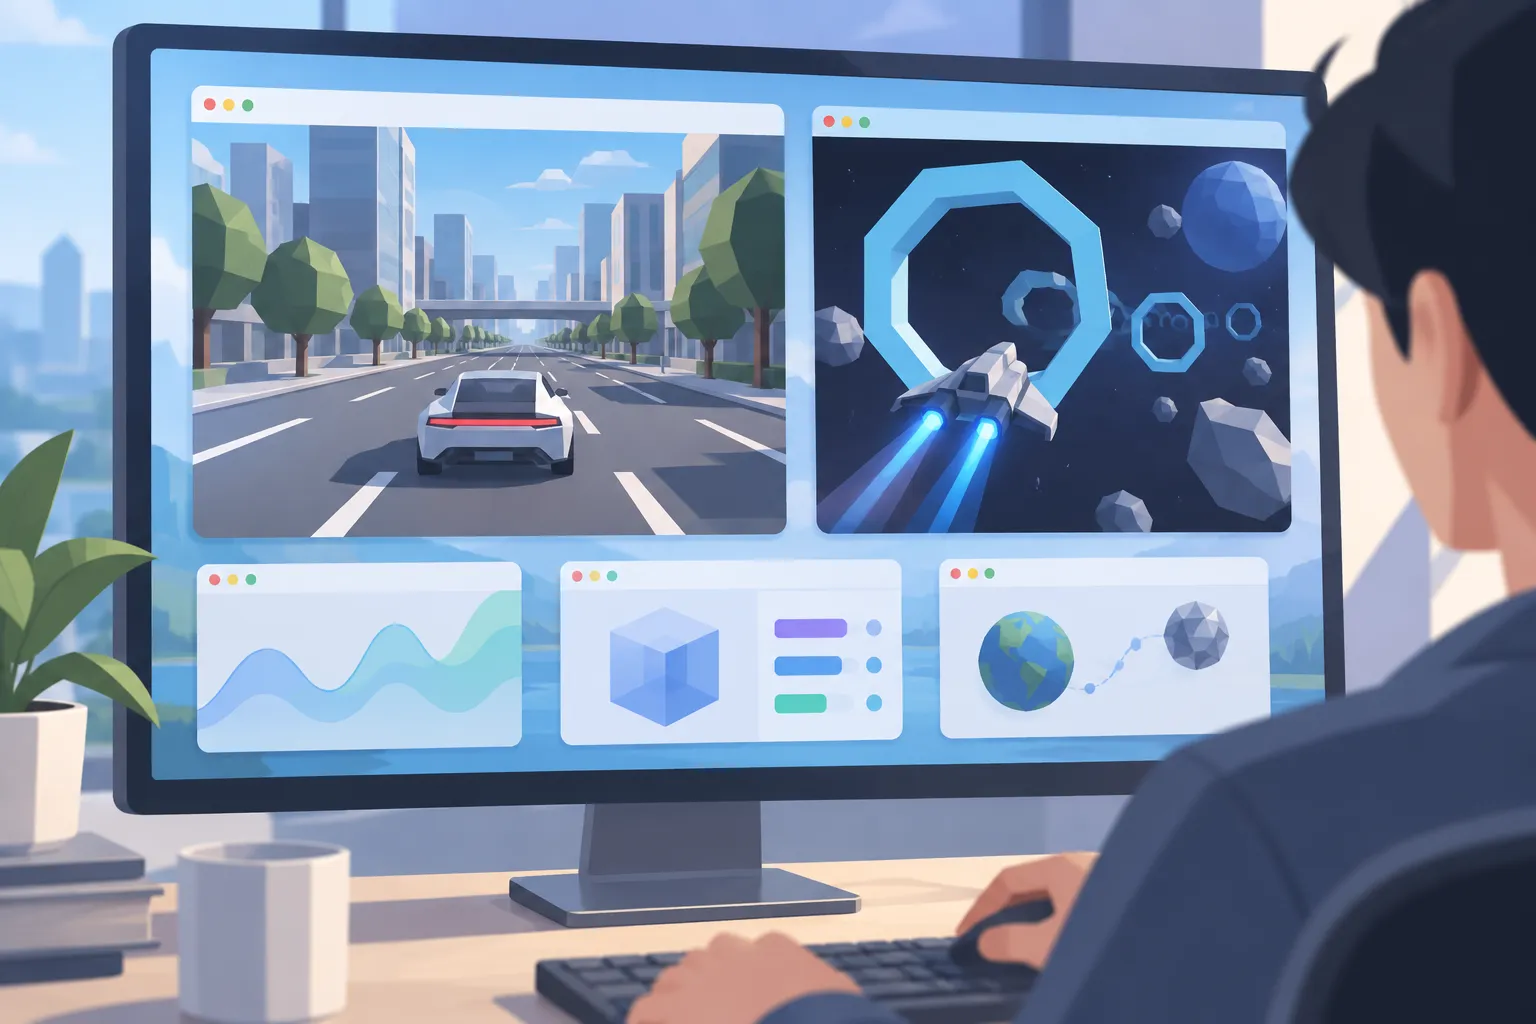
▲ ブラウザー上のデスクトップで動く2つのゲーム
連携はゲームにとどまりませんでした。メールには両方のゲームでの動きが反映され、メモはテキストファイルとして書き出せ、Continuumは開いているウィンドウ、ゲームの状態、メモを保存して復元しました。評価にとっては、アプリの数よりもこの状態の共有のほうが重要です。生成されたデスクトップが、別々の機能を連携させられることを示しているからです。見た目の評価はそれほど良くありませんでした。前日のClaude Sonnet 5.5の成果物のほうが洗練されて見えた一方、GPT-6.1 Solはブラウザー上のシステムを目立って速く生成し、きびきびと動かしました。
遊べるゲームだが、見た目の仕上がりにはむら
プールのゲームの課題では、3DモデリングツールのBlenderとゲームエンジンのGodotを使い、プレイヤーが選べる4人のダイバー、水の表現、効果音、得点の仕組みを作るよう求めました。最初の実行ではFast Modeを使い、18分12秒かかりました。この設定が出力の品質に影響した可能性があるため、以前のファイルを消去し、Fast Modeを切ってプロジェクトを作り直しました。
作り直しには約51分かかりました。裏庭の場面、キャラクター選択、ためてからのジャンプ、空中での技、得点のつく水しぶきはすべて動きました。それでも、比較対象のClaude Sonnet 5.5のプールのゲームのほうが、粒子の表現が豊かで、アニメーションに表情があり、見た目のユーモアも強くなっていました。これはその課題における見た目の品質の差を示すものです。
スケートボードのプロジェクトは、指示によって結果がどれだけ変わるかを示しました。GPT-6.1 Solは最初、技と、求められたスローモーションのリプレイを備えたC++の遊べるゲームを作りましたが、街並みはがらんとして見えました。見本となるスクリーンショットと、複数のソースファイルを使ってよいという許可を受け取ると、反射や景色、音を備えた、より充実した水辺の舞台を作りました。歩行者との衝突判定は、まだ実装されていませんでした。この改良は、動く最初の成果物をそのモデルの最終的な見た目と見なす必要はないことを示しています。
ほかのテストでも、機能がそろっていることと完成していることの違いがはっきりしました。ブラウザーで遊ぶ地下鉄のゲームは、敵の波と駅の間の電車移動を結びつけ、使える武器や後半の強い敵も備えていましたが、電車の発車の様子は不自然に見えました。Old School RuneScapeの対戦を再現したゲームは、19分30秒で精巧なインターフェースのパネルと遊べる戦闘を組み立てましたが、特殊攻撃は期待どおりに反応しませんでした。どれも具体的な欠点のある、かなり作り込まれた動く成果物であり、一様に完成したゲームではありません。
ロボットアームは課題を終えずに停止
物理的なテストでは、格子状のマットの上にあるロボットアームの操作をGPT-6.1 Solに任せました。課題は、おもちゃの車を動かすことです。約18分の動作中、車が動かされたり向きを変えられたりすると、アームは軌道を調整しました。カメラからのフィードバックと動作の計画が、作業空間の変化に反応していたことがわかります。
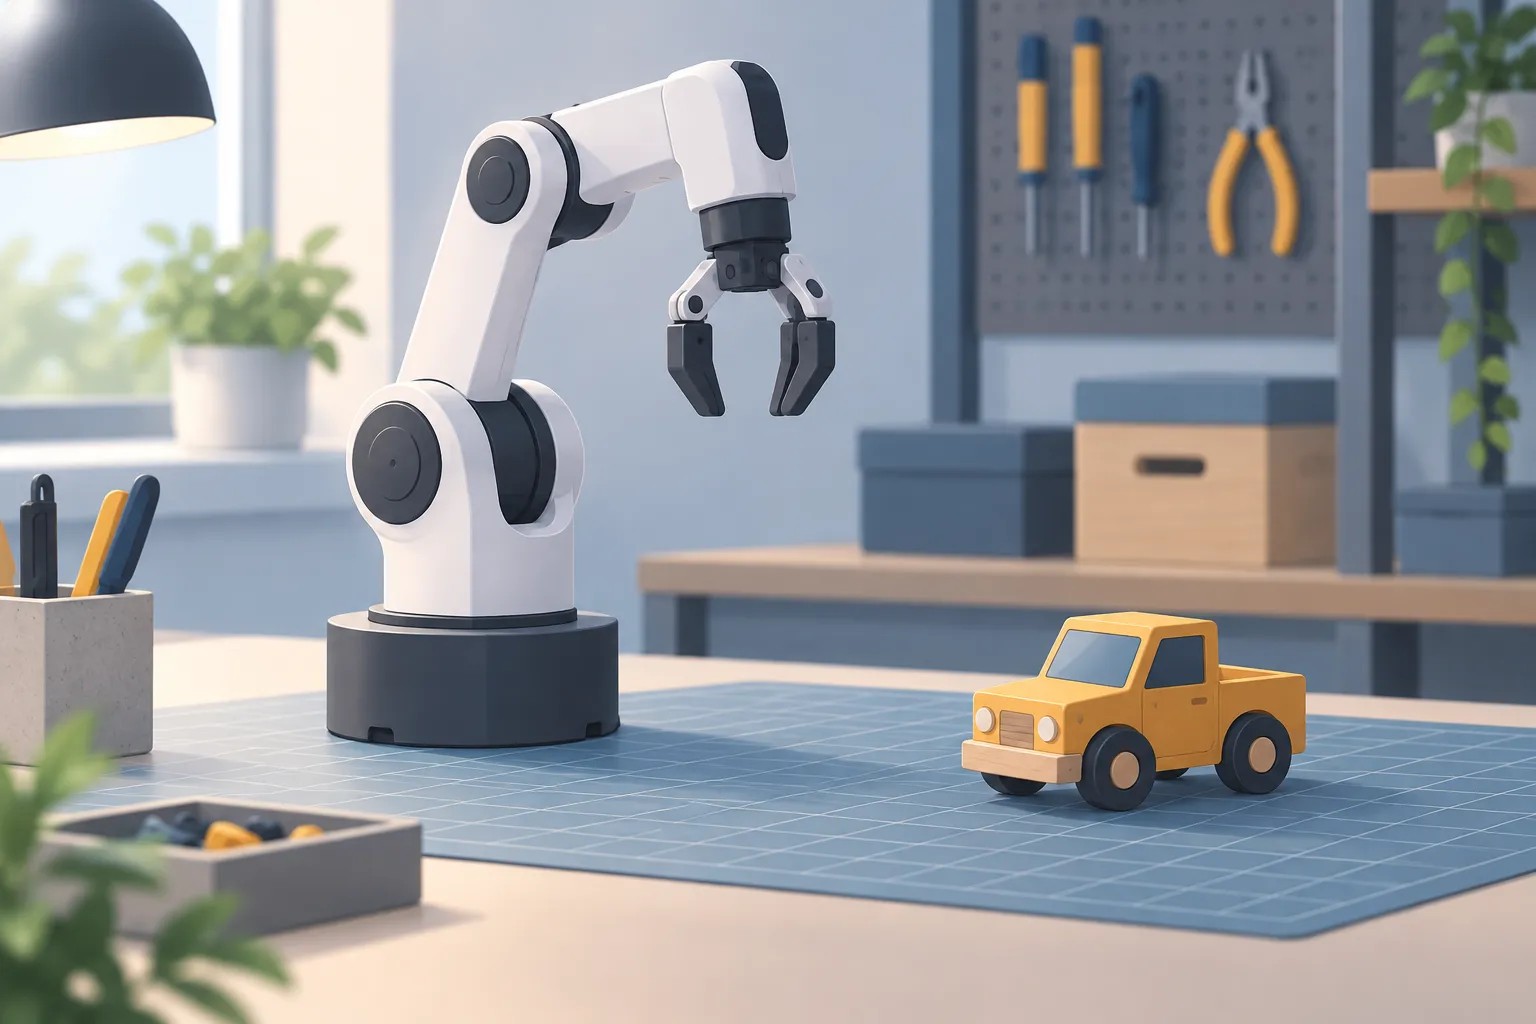
▲ おもちゃの車から離れて止まったロボットアーム
アームは車を安定してつかめず、運ぶこともできませんでした。その後、おもちゃから離れて直立の姿勢で止まりました。結果は課題の失敗ですが、安全面で役立つ違いがあります。反応の良い追跡は操作の成功にはつながりませんでしたが、システムは不確かな動きを続けずに止まりました。物理的な課題では、完了したかどうかと、失敗後のふるまいの両方を評価に含めるべきです。
結果から何を読み取るか
報告されたテスト全体を通じて、GPT-6.1 Solは、特にロジックや複数の手順を要する課題で、連携する機能を持つインタラクティブなソフトウェアを作れるように見えます。最初の3Dの見た目は安定して印象的とは言えず、ロボットは運搬を完了できませんでした。一連のテストの間、ChatGPT Proのアカウントの週間の利用枠は残り98%から95%に減りました。これは1つのアカウントの使用量であり、ほかの作業の見通しではありません。
アプリのプロジェクトにモデルを選ぶなら、候補のモデルに同じプロンプトと制約を与えて比べましょう。機能が実際に動くかを試し、見た目の品質は別に確認し、それぞれの成果物がエラーや失敗した操作をどう扱うかを確かめます。見た目が重要なら、見本となる画像を使います。これらの結果から、GPT-6.1 Solは、Claude Opusのような最上位のモデルと比べても、こうした作業で試す価値のある、堅実で費用対効果の高い候補と言えます。