顧客ごとにインフラを運用するあるプラットフォームエンジニアリングのスタートアップは、AIエージェントを使って、切り離されがちな二つの作業をつないでいます。運用データの調査と、そのデータを生み出すインフラの変更です。エージェントはElasticsearchのログを検索し、メトリクスとクラスター構成を確認したうえで、プルリクエストを通じて修正を提案できます。この設計は、障害の把握に必要な情報を手放さずにオブザーバビリティのコストを抑え、提案された変更をレビューの対象にとどめることを狙っています。
データは分けても調査は分けない
同社は顧客ごとに専用のKubernetesクラスターを運用しています。Kubernetesはコンテナ化されたアプリケーションを管理する基盤です。分離された多数のクラスターを一体型の商用サービスで監視すると、同社の試算では年間$30万以上の費用がかかります。この数字は同社自身の想定ケースを示すもので、一般的な削減額の目安ではありません。
そこで同社は、テレメトリーの収集、保存、可視化を切り分けています。テレメトリーとは、ログや性能の計測値といった運用上のシグナルを指します。メトリクスはVictoriaMetricsに保存し、Elasticsearchが検索可能なログストレージを担います。メトリクスの収集にはvmagentを、ログの集約にはFilebeatとLogstashを使い、OpenTelemetryも収集手段の選択肢になります。可視化とアラートはGrafanaが担当します。同社はクラウド環境と社内環境を合わせて、約12のElasticsearchクラスターと、ほぼ同数のVictoriaMetricsのデプロイメントを管理しています。
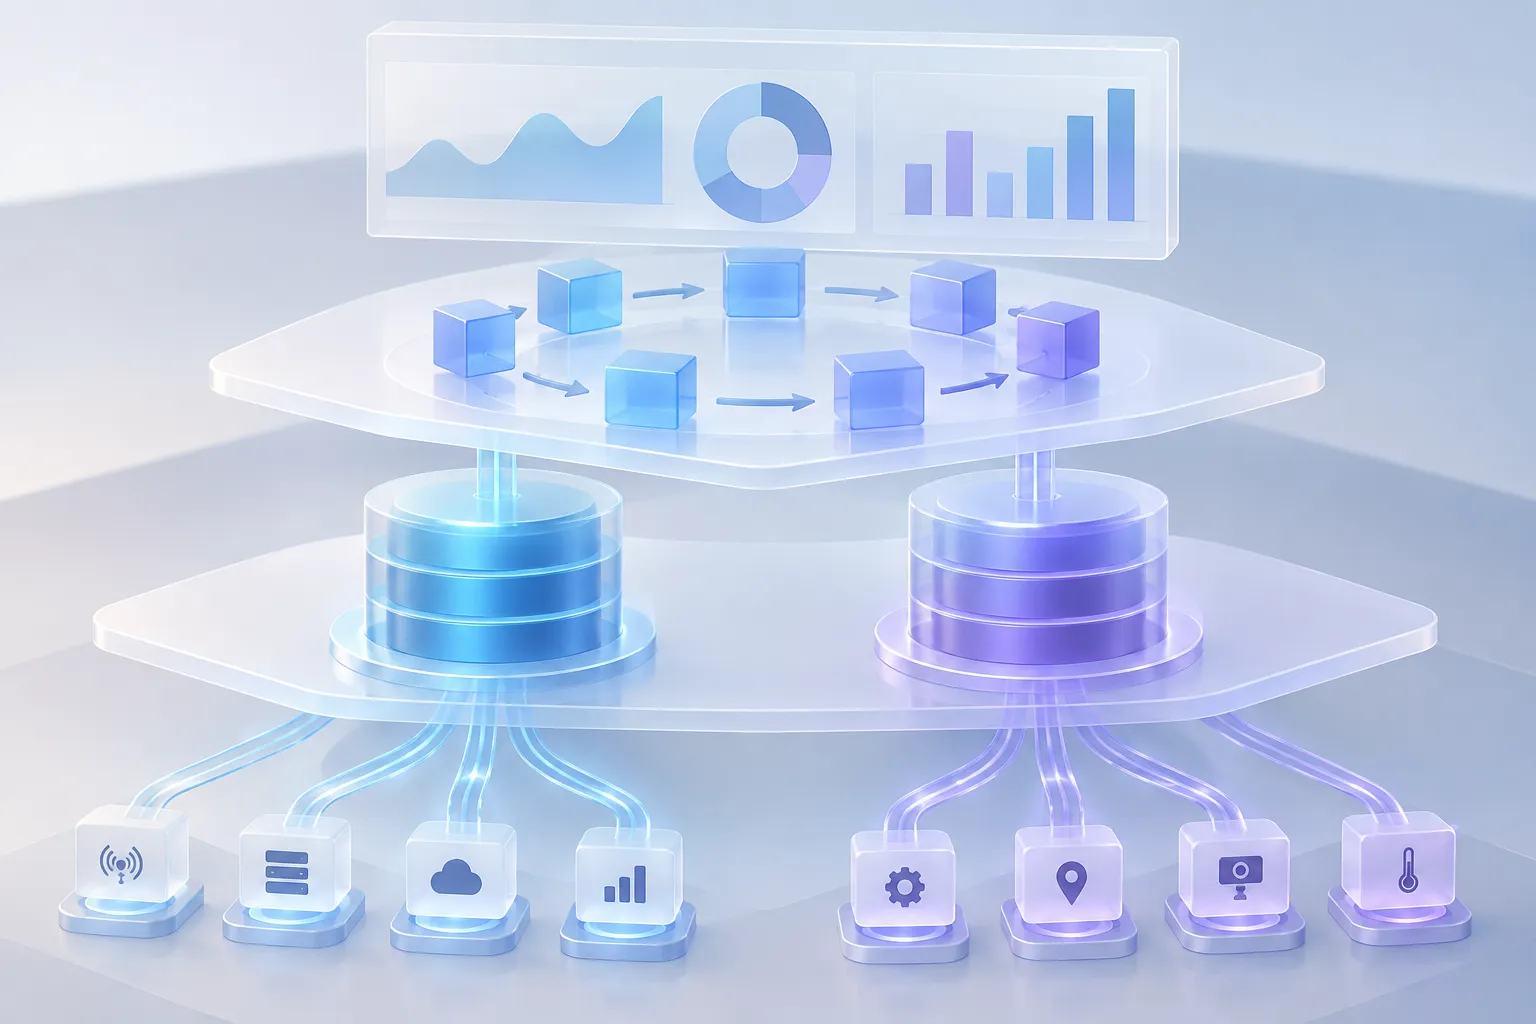
▲ 分離したデータストアと均等なインデックス
これらの構成要素を分けたからといって、すべてのエンジニアにとってダッシュボードが不要になるわけではありません。洗練されていない画面は、チームがデータを活用しにくくなる原因にもなります。同社の手法は、エージェントに基盤のデータストアを直接照会させて結果を届けつつ、人が確認できるグラフも残すというものです。コスト面の利点が得られるかどうかは、ダッシュボードを置き換えることではなく、有用なログとメトリクスを保てるかどうかにかかっています。
エージェントが手を入れる前にElasticsearchを安定させる
自動管理を行うには、Elasticsearchに安定した土台が必要です。インデックスは検索可能なレコードの集まりで、シャードはクラスター全体に分散配置されるインデックスの一部分です。同社はIndex Lifecycle Management(ILM)を使い、シャードが大きくなりすぎたり古くなりすぎたりする前に、ログを新しいインデックスへ切り替えています。ある設定例では、プライマリシャードの最大サイズが50GBに達するか、インデックスの経過日数が7日になるとロールオーバーし、30日を過ぎたインデックスを削除します。これはこの事例でのポリシー設定であり、どこにでも当てはまる目標値ではありません。シャードサイズを予測可能に保つことで、負荷の偏りや緊急の再インデックスを避けやすくなります。
クラスター自体には、Elasticsearchの管理を自動化するオペレーターであるElastic Cloud on Kubernetes(ECK)を使っています。KubernetesのCustom Resource Definition(CRD)が、ノードセット、ストレージ、バージョン、設定を、オペレーターが処理できる形式で記述します。ECKは、ローリングアップグレード、証明書の生成、ノードのスケーリング、ストレージのリサイズといった作業を担います。
CRDは、エージェントが変更を提案するための明確な場所にもなります。GitOpsでは、インフラの設定をGitで管理し、適用前にプルリクエストで変更を記録してレビューできます。これはステートフルなデータストアでは特に重要です。ノードの追加や再起動はシャードの移動を招き、サービスを妨げるおそれがあるためです。しきい値に基づく単純で頻繁なスケーリングは、容量とクラスターの状態を見極める作業の代わりにはなりません。
容量のシグナルからストレージ変更の提案まで
同社のエージェント作業ツールは、定期的なクラスター監査を実行できます。ある作業フローでは、週次ジョブがオブザーバビリティ担当とインフラ担当のエージェントをそれぞれ割り当て、Elasticsearchの容量を調べさせました。オブザーバビリティ担当のエージェントはPrometheusのメトリクスを照会し、CPU使用量やファイルシステムの空き容量を含む推移を表示しました。インフラ担当のエージェントは、KubernetesのリソースとGitOpsの設定を確認しました。二つの視点を合わせることで、エージェントはクラスターの実際の動きと、設定が要求している内容とを比べられます。
作業フローは次の4段階で進みます。
- 定期監査を実行し、メトリクスとクラスターの状態を集める。
- 容量の推移を現在のElasticsearchの設定と比べる。
- 変更が妥当であれば、GitOpsのプルリクエストを用意する。
- 承認と適用の後、更新されたクラスター定義をECKに反映させる。
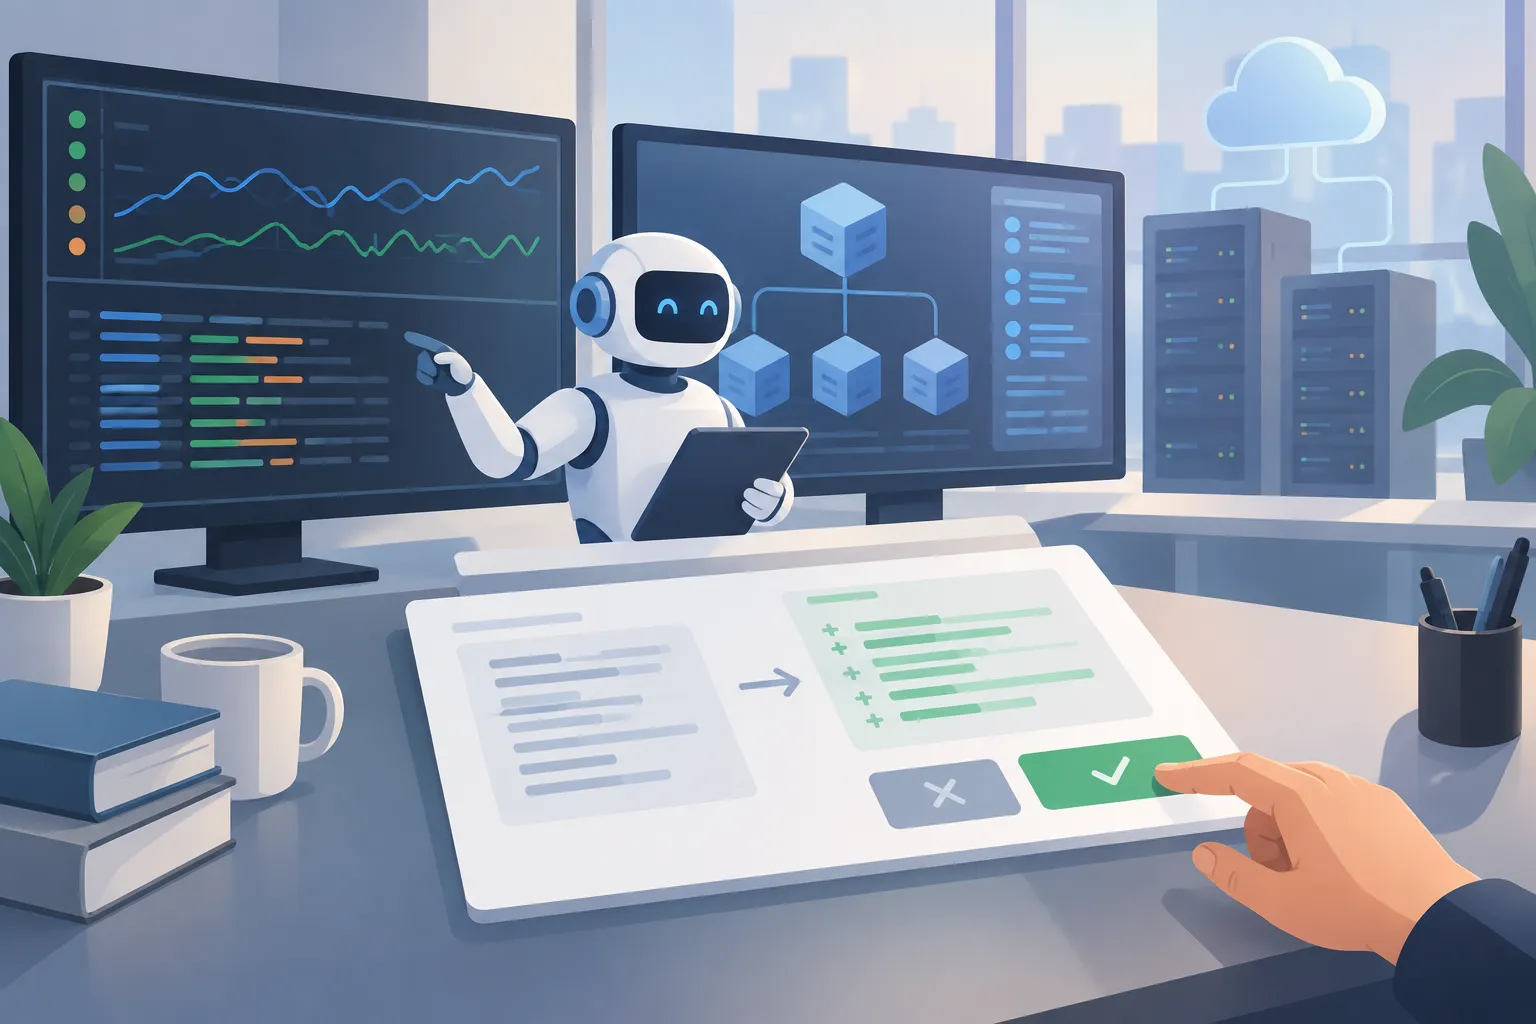
▲ 人のレビューを待つエージェントの提案
ある結果は、提案と自動的な編集が別物であることを示しています。グラフでは空きディスク容量の減少が見られたものの、エージェントは当初、ディスク容量とシャード数からみて拡張は不要と判断し、プルリクエストを作成しませんでした。その後、明示的な指示がこの判断を覆しました。エージェントはそれを受けて、3台のElasticsearchノードそれぞれの要求ストレージを500Giから550Giに増やす、合計150Giの増量をGitHubのプルリクエストで提案しました。この変更は上書きの指示を受けた提案であり、当初の評価が拡張を求めていたことを示すものではありません。
障害対応にも同じ根拠の道筋を使う
ログとインフラのつながりは、アプリケーションの障害にも当てはまります。HTTP 500エラーの増加を知らせるアラートに対し、エージェントはメトリクスとKubernetesの状態を確認し、Elasticsearchのログを検索し、アプリケーションのコードを調べました。エラーの原因がFastAPIのエンドポイントで断続的に発生する例外だと突き止めると、コード修正と回帰テストを含むGitHubのプルリクエストを用意しました。この調査は、誰かが一つずつ手作業でクエリを組み立てなくても、症状から関連するログ、そして修正案へと進みました。
アラートはWebhookを通じてこうしたジョブを起動でき、調査結果は障害対応専用のSlackチャンネルで共有できます。これにより作業フローは定期的なクラスター保守の枠を超えて広がりますが、根拠を確かめ、提案された変更をレビューする必要がなくなるわけではありません。
エージェントの権限は作業範囲より狭く保つ
同社は、オーケストレーションのサービスがクラウドでホストされている場合でも、コーディングエージェントを顧客のKubernetesクラスター内の隔離されたPodで実行します。この仕組みは、社内のログ、テレメトリー、認証情報を顧客の環境内にとどめることを目的としています。エージェントの操作は依頼したユーザーのIDを引き継ぎ、ロールベースアクセス制御(RBAC)を適用するKubernetesプロキシを経由します。
オブザーバビリティツールの中には、メトリクスごとのきめ細かな権限チェックを備えていないものもあります。そのため同社は、ポリシー言語Regoで書いたOpen Policy Agent(OPA)のルールで個々のツール呼び出しを確認しています。ルールは呼び出しを拒否することも、人の承認を求めることもできます。既定では読み取りは自律的に進められ、書き込みにはプルリクエストかプラットフォーム上の確認による承認が必要です。SOC 2のようなコンプライアンスの枠組みも、コード変更が本番環境に届く前に人の承認を求めています。
押さえておきたい点
この手法は、ログ検索を調査の終点とみなすのではなく、収集、検索可能なデータ、エージェントによる分析、クラスター管理をつなげています。同様の作業フローを検討するチームは、まずインデックスのロールオーバーとクラスター設定を確実なものにし、そのうえでエージェントにテレメトリーと関連するインフラ定義の両方へのアクセスを与えるべきです。それぞれの提案の根拠を見える状態に保ち、提案された書き込みが本番環境に届く前には必ず人がレビューするようにしましょう。