Ponytail是Claude Code最受欢迎的技能之一,现已更新到第5版,其核心承诺在独立测试中基本站得住脚。技能是一组打包好的指令,用来教AI智能体如何处理某类工作;Ponytail的指令则促使Claude尽可能少写代码。在基于Claude Opus 5.5的验证中,与未安装任何技能的Claude Code相比,它生成的代码少61%,成本低24%,完成速度快35%,代码的安全性也没有明显下降。问题出在开放式请求上。Ponytail只做被要求的部分,几乎不多做,因此落地页等界面会显得十分简陋。这使它非常适合规格严格限定的工作,却不适合作为开放式工作的默认设置。
Ponytail做什么
Ponytail的出发点是:Claude的输出往往过于冗长,还容易把方案设计得过度复杂。按照这一思路,只要给模型严格的规则,它就会专注于真正需要的部分,产出更简洁、更便宜、更快的结果。该项目在GitHub上已获得近17万颗星,目前的版本为v5.3.2。
其核心机制是智能体在写代码前逐级回答的七个问题,构成一道阶梯。第一个问题是“这真的需要存在吗?”,最后一个是“能不能用一行解决?”。代码只会在可行的最低一级写出,并附带一个小测试。
日期选择器的例子最能说明差异。在被要求为应用前端添加日期选择器时,未使用该技能的Claude要么引入外部库,要么从零编写自定义日历,最终写出335行代码。使用Ponytail 5后,模型识别出浏览器内置的日期输入和应用现有的UI组件,只用10行就完成了任务。
项目公布的第5版官方数据如下:
| 指标 | Ponytail 5宣称的变化 |
|---|---|
| 代码行数 | 减少53% |
| 成本 | 降低26% |
| 输出token | 减少45% |
| 执行时间 | 缩短41% |
| 附带测试的高风险逻辑 | 98%,未使用该技能时为68% |
第5版的五项变化
- 规则手册更短。 指令提示词从1,094个词缩减到592个词,每次会话的运行成本因此比v4.13低约10%。
- 先梳理变更。 在动代码之前,Claude必须先梳理整个变更:调用方、测试夹具(测试所依赖的预存数据)、配置以及影响范围,也就是这次修改可能波及的一切。
- 说明跳过了什么。 模型必须说明跳过了什么、选择不检查什么以及还存在哪些风险。在第4版中,这一步是可选的。
- 审查范围更广。 审查环节过去只查找过度设计,如今还会查找diff(即被修改的代码行)之外的缺陷、安全漏洞、缺失的测试和性能问题。
- 仓库地图与实时状态栏。 每次会话开始时,Ponytail会生成仓库地图,让智能体复用已有函数。终端中的状态栏会显示会话成本、token用量、智能体用时、复用代码的比例以及测试是否通过。
数据经得起检验吗
本文所述测试共使用了约700个Claude Code会话。其中,核对官方主要数据的测试在Claude Opus 5.5上运行了39项任务、132个会话,结果与项目宣传的数据相当接近。
| 指标 | 宣称 | 实测 |
|---|---|---|
| 代码减少 | 53% | 61% |
| 成本降低 | 26% | 24% |
| 执行时间缩短 | 41% | 35% |
| 相比v4.13的成本降幅 | 约11% | 10.5% |
官方主要数据中漏掉了六项任务,容易让人怀疑是在挑选有利结果。单独运行这六项任务后,代码减少了76%,看来将其排除并没有让结果显得更好看。
七个词能否胜任
X和Reddit上常见的一种反对意见认为,Ponytail设计过度,只要一行援引YAGNI的指令就能完成同样的工作。YAGNI是“You Aren’t Gonna Need It”的缩写,指在真正需要之前不构建任何东西的软件开发原则。为了检验这一说法,测试将Ponytail与一条放在AGENTS.md中的七个词的指令进行对比。AGENTS.md是编程智能体会读取的常驻指令文件,这条指令是:“Follow YAGNI principles, and prefer one-liner solutions.”
在30项任务的纯效率比较中,简短提示词胜出。它将代码减少72%,成本降低38%,而Ponytail分别为60%和24%。
但在对24项“帮我做个应用”类任务进行盲审时,局面发生了反转。这些任务包括计算器、分析仪表盘和日历应用,评审者并不知道每个结果出自哪种设置。
| 审查指标 | 七个词的提示词 | Ponytail |
|---|---|---|
| 导致数据丢失的缺陷 | 2个 | 0个 |
| 附带测试交付的任务 | 24项中14项(58%) | 24项中24项(100%) |
| 必备功能达成率 | 89% | 95% |
| 核心功能达成率 | 97% | 100% |
| 披露跳过项的比例 | 49% | 78% |
Ponytail规则中多出的约580个词,看起来起到的是护栏作用,而不是冗余。反过来看,这也是一个警告:只写“保持简短”的指令,在成本图表上也许很好看,却可能悄悄省掉测试,让破坏数据的缺陷进入生产代码。
▲ 护栏与单薄的简短提示词
安全性保持稳定
一个合理的担忧是,把Claude限制得这么紧,可能会让代码出错或变得不安全。在Claude Opus 5.5上盲测运行351项编程任务,并用隐藏的验证测试检查,有342项通过。另一项使用145个刁钻输入的压力测试中,各设置的通过率如下:
| 设置 | 刁钻输入通过率 |
|---|---|
| 原版Claude | 100.0% |
| Ponytail 5 | 99.5% |
| 七个词的提示词 | 98.4% |
一项隐私任务要求各设置在不暴露任何人邮箱地址的情况下,给全部新闻通讯订阅者发送邮件,这需要使用BCC(密件抄送)。每种设置各试三次,原版Claude失败两次,Ponytail 5失败一次,而旧版Ponytail和七个词的提示词三次全部失败。从这些结果看,Ponytail 5并不会明显让代码出错或变得不安全。
真正的代价:没人要求的额外元素
取舍体现在界面开发中。如果给出一份把从A到G的每项规格都写清楚的详细PRD(产品需求文档),Ponytail会简洁、干净地执行指令。而面对“帮我做个落地页”这类开放式提示词时,原版Claude依靠的是Opus 5.5推断意图、自行做隐性调研,并补上用户期望的UI元素的能力。Ponytail压制的恰恰是这种能力。
由一位评审者盲评的五个落地页提示词,清楚地显示了这一差距。这里的额外元素,指没有人明确要求、但最好具备的元素。
| 设置 | 额外元素交付率 | 外观评分(满分5分) | 五个页面的成本 |
|---|---|---|---|
| 原版Claude | 82% | 4.3 | $1.83 |
| Ponytail 5 | 41% | 2.7 | $0.64 |
| 七个词的提示词 | 46% | 2.9 | $0.66 |
| Ponytail 5加“polish it” | 63% | 3.1 | $2.82 |
事后再让Ponytail“polish it”(润色一下),额外元素增加到63%,但费用升至$2.82,远高于原版Claude,页面看起来仍然更差。
为一款提供Free、Pro和Team三档方案的SaaS产品制作定价页面时,结果同样如此。
| 设置 | 代码行数 | 成本 | 必备元素 | 额外元素 |
|---|---|---|---|---|
| 原版Claude | 388 | $0.32 | 100% | 89% |
| Ponytail 5 | 94 | $0.13 | 100% | 47% |
| 七个词的提示词 | 93 | $0.11 | 100% | 39% |
| Ponytail 5加“polish it” | 209 | $0.50 | 100% | 66% |
原版Claude交付了完整的导航栏、功能对比矩阵和可折叠的FAQ。Ponytail 5虽然满足了全部必备项,却去掉了导航栏、动画、用户评价等社会认同元素、FAQ、次要行动号召、对比表和计费切换开关。即使在“polish it”之后,丰富的表格和详细的功能说明依然缺失。同样的模式也出现在店铺分析仪表盘、咖啡烘焙店页面、候补名单页面和待办事项应用上。
汇总全部测试,规律十分一致:
| 设置 | 所要求功能的交付率 | 未要求额外元素的交付率 |
|---|---|---|
| 原版Claude | 100% | 98% |
| Ponytail 5 | 98% | 54% |
| 七个词的提示词 | 97% | 36% |
Ponytail保留你要求的东西,砍掉你没有要求的东西。其中一些被砍掉的功能对日常使用很重要,包括搜索、分页、清晰的错误提示和撤销。如果你并非该领域的专家,又指望Claude帮你补齐功能或视觉上的空缺,可能会觉得输出结果不够用。
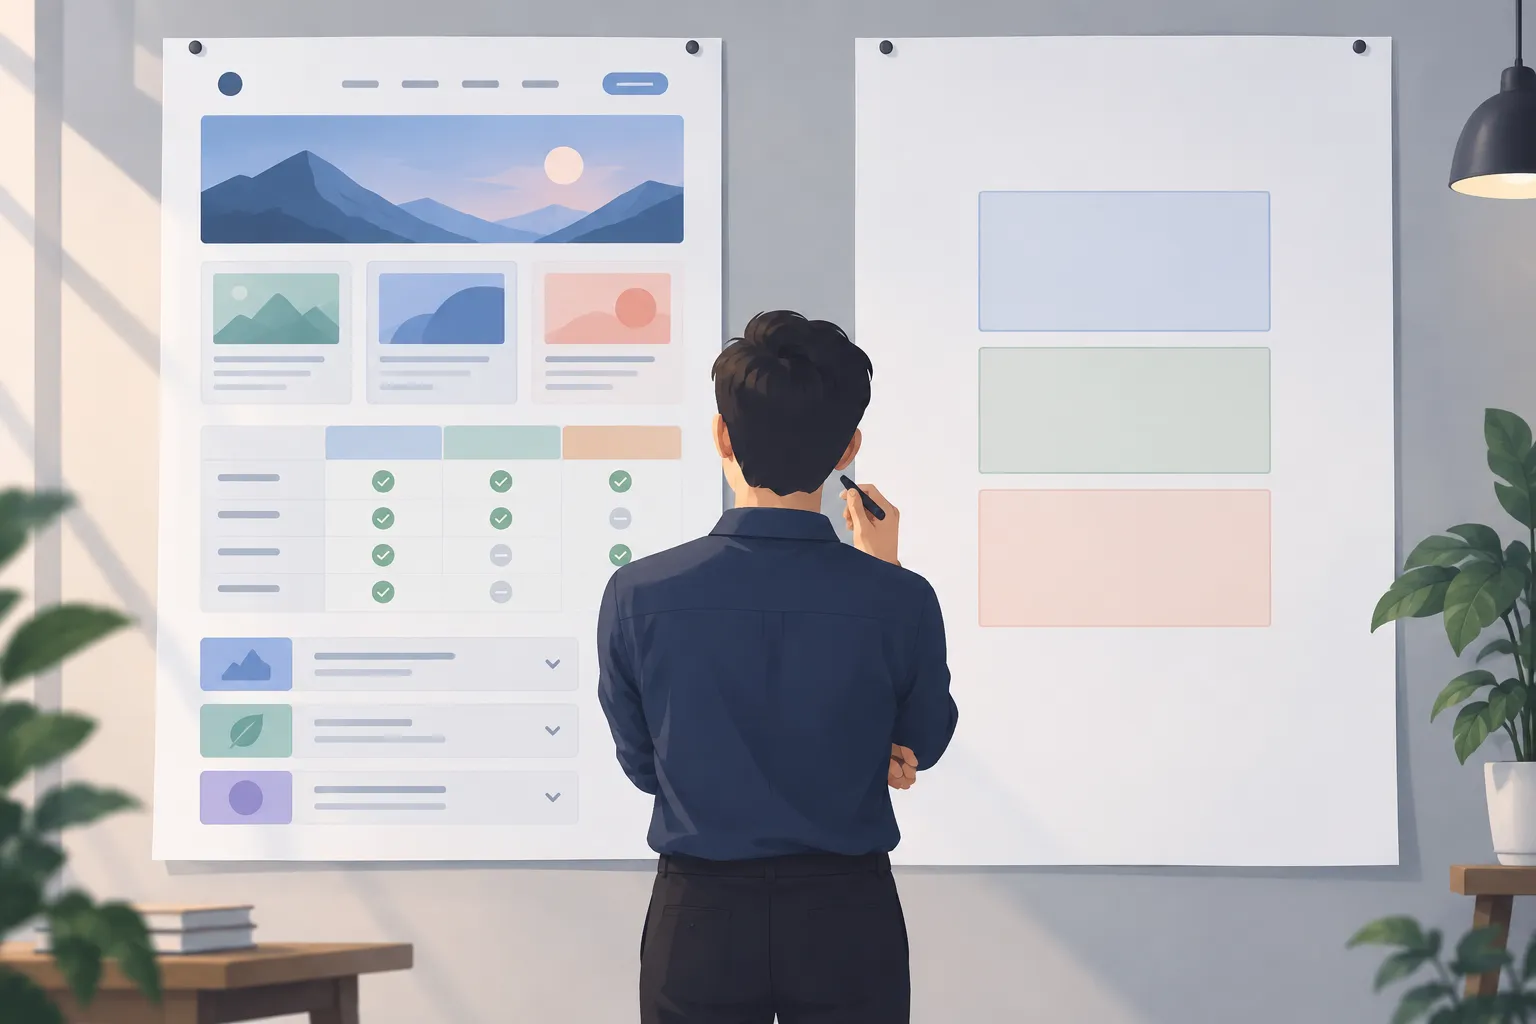
▲ 被省略的未要求页面元素
何时安装,何时不装
Ponytail 5基本证实了自己的说法:实测代码减少61%,成本降低24%,运行速度快35%,且没有引入重大缺陷或安全漏洞。代价是Claude的主动性。Opus 5.5看起来最擅长的,是察觉未说出口的需求,并用合理的默认设置补上,而这恰恰是该技能关掉的能力。而且,如果一套规则真能在所有领域解决token效率问题,Anthropic、拥有Codex的OpenAI以及其他前沿实验室很可能早已把它内置。
| 场景 | 判断 |
|---|---|
| 有详尽PRD的后端或架构工作 | 值得一试 |
| 前端设计、UI原型或模糊的提示词 | 继续使用原版Claude |
| 单行修改或精细的局部修复 | 不要使用,加载规则消耗的token比节省的更多 |
| 打算用“polish it”修补的简陋输出 | 节省的成本会消失 |
如果你正在考虑使用,下面几步会有帮助:
- 先在单个项目中试用Ponytail,再决定是否全局安装,并把成本和输出质量放在一起比较。
- 对能够完整写出规格的工作启用它,希望借助Claude的设计判断时则关闭它。
- 不要用“polish it”之类的后续提示词去修补简陋的结果。多出来的对话轮次会抵消节省,最终花费可能比原版Claude还高。
- 不要把生产代码交给“简短一点”这类极短的指令。它们往往会省掉测试,还可能引入导致数据丢失的缺陷。
- 即使不用这个技能,也可以借鉴其思路。在CLAUDE.md或AGENTS.md中写下规则,让智能体在编辑前梳理变更,并列出跳过或未测试的内容,就能让其中的取舍变得清晰可见。