OpenAI最新发布的智能体功能有一个共同目标:不再等每项服务都提供API,而是让AI智能体直接操作人们使用的同一批应用和界面。OpenAI负责计算机操作(AI模型通过屏幕、鼠标和键盘操作软件的功能)产品与工程的负责人表示,以这种方式操作软件的智能体,在日常数字任务上已经比普通人完成得更快。下一个目标是超越熟练的高级用户,达到这样的速度后,真正实时响应的产品才有可能出现。下面梳理从助理Dot到GPT-6.1 Sol、Agents API和Decisions API,这些新组件如何协同工作,以及开发者现在应该确认什么。
每个智能体都有一台专属计算机
Dot是OpenAI新推出的个人助理,内置计算机操作功能。以往的系统只能在隔离的浏览器或用户自己的机器上运行。Dot则为每个智能体在云端分配一台专属的Linux虚拟机,并且这个环境会持续保留。
这种设计扩大了智能体能够处理的范围。有了完整的桌面环境,它可以同时运行原生桌面应用和网页浏览器。几乎所有软件都是为人通过图形界面操作而设计的,因此拥有这种访问权限的智能体,原则上可以承担人在计算机上完成的大部分工作,包括没有开发者API的服务。具体例子如下:
- 一份精确到鸡肉和米饭克数的备餐订阅订单,手动设置花了两个小时。交给GPT-6.1 Sol后,同样的订单只用15分钟就完成了,速度大约提高了8倍。
- YouTube创作者工具中没有公开API的事务,例如在社区标签页发帖或设置缩略图A/B测试,也很适合交给智能体。OpenAI内部的开发者体验团队已经依靠计算机操作智能体来运营YouTube。
- 此外,智能体还处理过客服流程中的登录、身份验证和账户问题排查,配置过DNS记录,并支付过大额账单。
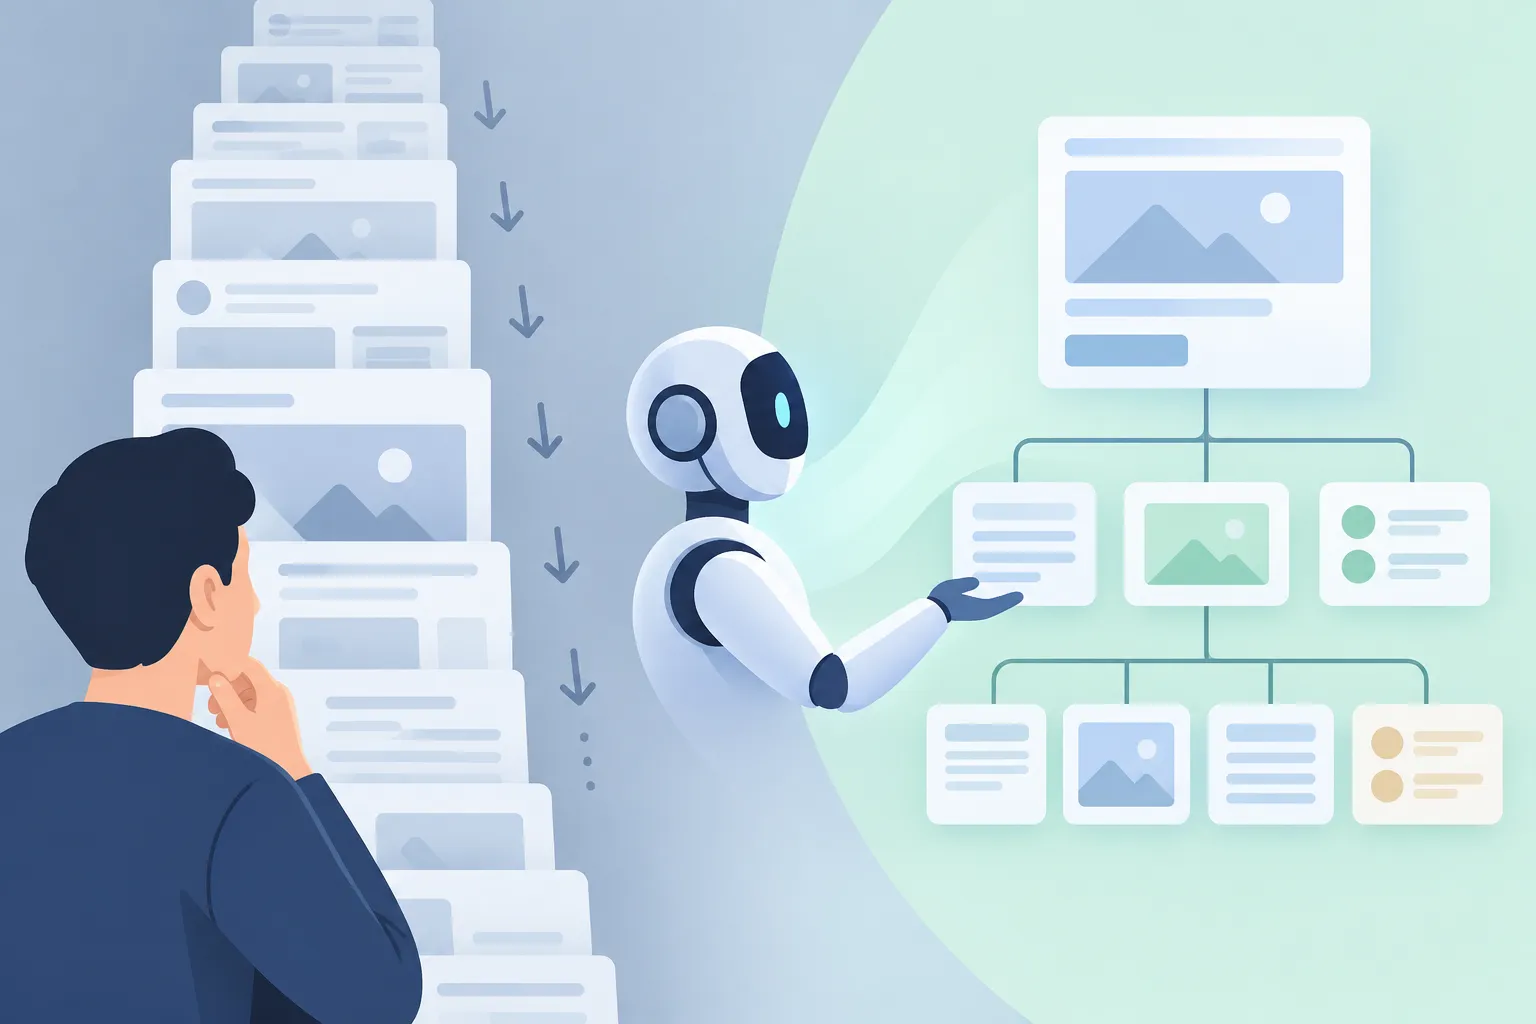
▲ 从截图到界面结构
从截图到界面结构
早期的计算机操作只依赖像素信息。智能体先截图,再滚动页面,再截图,然后把这些画面拼接起来。过去一年里,有三点发生了变化:
| 以前 | 现在 |
|---|---|
| 零散的截图加上滚动 | 通过DOM(文档对象模型)获取页面结构,结合操作系统的无障碍树,一次看到整个屏幕 |
| 每次往返只点击一次 | 生成JavaScript代码,一次执行多个操作 |
| 遇到意外的错误或弹窗就卡住 | 检查失败的步骤,诊断状态并自行调试 |
模型还会根据任务组合不同的输入,包括无障碍树、Playwright浏览器自动化和截图。无障碍技术最初是为屏幕阅读器开发的,如今它能让语言模型以节省token的方式提取按钮、标签和文本框。掌握了整个屏幕的结构后,模型可以一次写出多步骤脚本,而不是零散地逐个执行操作。
DevDay上展示的Appshots,让用户可以直接使用这种方式。在Codex或ChatGPT中连按两次Command键,就能捕获应用的元数据、结构和无障碍树,而不是原始像素。普通截图会丢失链接指向的地址、被截断的日历条目全文等细节,而Appshots会保留这些信息。在Codex中点击附件,可以查看实际发送的原始无障碍数据;展开工具调用,还能看到智能体为批量执行多个界面操作而编写的JavaScript。
最慢的环节往往是网站本身
DevDay主题演讲提到,计算机操作的速度提升了7倍。这一提升来自模型和harness(让模型能够使用工具的软件层)的共同改进;每天的进步看似细微,但几个月累积下来,可靠性和速度都会大幅提升。成本也降低了:GPT-6.1 Sol在一般任务上的价格约为Astra的五分之一,在计算机操作任务上约为七分之一。
随着推理越来越快,瓶颈转移到了模型之外。智能体在DoorDash下单时,大部分运行时间都花在等待页面加载完成上。固定的等待计时器会浪费时间,因此目标是缩短页面渲染完成与智能体执行下一步操作之间的间隔。监听浏览器加载事件比随意等待更好,但很多网页应用在界面更新时仍不会发出明确的信号。客服聊天也有自身的延迟,回复需要30秒到3分钟不等。
OpenAI为何引导开发者使用Agents API
OpenAI已将计算机操作集成到Agents API中,让外部开发者也能使用Codex和ChatGPT所依赖的同一套工具调用harness。开发者也可以自建harness,但OpenAI是在自己的harness上训练模型的,因此官方实现在准确性、延迟和成本方面更有优势。
另一个前提是信任。在把关键任务交给智能体这件事上,早期采用者远远走在大众前面,而更广泛的普及取决于安全保障措施:
- 在执行金融支付等不可撤销的操作前,请用户确认。
- 将每个智能体的访问范围限制在任务所需的域名和应用内。
开发工作也随之改变。智能体可以修改应用、构建并运行它,同时检查外观和行为,从而接手过去开发者需要为模型生成的代码手动完成的质量检查。可视化试玩测试能发现布局回归问题,同样的能力还可用于逐个界面地复刻现有应用。
▲ 智能体自测与用户确认
快速决策与长任务的分工
Decisions API面向快速分类和单步决策。它在不进行长时间推理的情况下并行运行较小的模型,从而降低延迟。据OpenAI的API产品负责人介绍,它并不是新模型:它基于现有的Luna权重运行,推理栈针对首个token的输出时间做了优化,结构化输出则以并行批次方式评估。首个版本以零样本方式发布,以便OpenAI在训练专门的微调模型之前收集反馈;它还继承了Luna的视觉能力,无需额外的集成工作。
OpenAI指出了两种主要用途:
- 大批量分类。OpenAI内部的用户运营团队已用它来分拣收到的客服工单。
- 计算机操作流程中的快速步骤。Astra这样的深度模型可以写出完整的多步骤脚本,而Decisions API上的Luna负责挑选下一个单步操作。
OpenAI还在测试一种语音方案:由GPT Live与用户对话并分派工作,同时由Decisions API执行工具调用,而不让对话停顿。
局限也很明显。由于不进行推理,Decisions API并不适合冗长或含糊的任务;如何把快速执行与深思熟虑的推理结合起来,仍是一个悬而未决的研究课题。
面向智能体的API更新
多项平台更新面向长时间运行、交互式的智能体:
- 异步工具调用:随GPT-6一同推出,让模型在启动耗时较长的工具后继续生成和推理,并在工具完成时获取结果。
- 轮次中引导:开发者可以在模型推理过程中插入新的指令。
- WebSocket:在应用与模型之间保持全双工连接,减少反复往返调用工具的开销。
- 更快的响应:重写Responses API后端,缩短首个token的输出时间和token之间的间隔。
- 缓存保证:承诺30分钟内命中缓存,面向企业用户的12小时保证仍处于预览阶段。开发者可以预先支付缓存写入费用来预热提示词,诊断工具则能显示提示词前缀从哪里开始无法命中缓存。
- 压缩:在Agents API中由harness自动完成。在Responses API中,服务器可以在达到设定的token阈值时压缩历史记录,也可以用compact命令手动触发。
OpenAI还推出了Ultrafast模式,让前沿模型逼近当前可实现的最快速度。此前的效率优化已使Luna的价格下降约80%。
开发者现在应该做什么
OpenAI的方向似乎更偏重计算机、决策调用、缓存这类基础构件,而不是一个包揽一切的智能体框架。OpenAI的API产品负责人借自己在Stripe的经历来说明底层基础功能与便捷的高层抽象之间的平衡:在Stripe,支付基础功能之上成长出了许多产品。可以马上着手的步骤如下:
- 挑选一项没有公开API、需要多个步骤的重复性任务,尝试交给计算机操作智能体。
- 让智能体等待加载事件等页面信号,而不是使用固定计时器。
- 在支付等不可撤销的操作之前加入用户确认,并把每个智能体限制在所需的域名内。
- 把快速分类和单步决策交给Decisions API,多步骤工作则交给更大的模型。
- 保持系统指令和提示词前缀稳定,以提高缓存命中率,并用诊断工具找出缓存中断的位置。