借助RunPod Flash,开发者无需编写自定义Dockerfile即可部署Python模型代码,并在GPU worker闲置时将其关闭,从而有望降低图像生成服务的运行成本。不过,“$1生成3,000张图片”这一醒目估算,描述的是一个处于预热状态的worker持续处理稳定流量的情形。对于请求间隔较长的服务,每张图片消耗的GPU时间可能更多;而存储、应用逻辑以及一次生成两张图片的用户体验,也会带来单图基准测试无法反映的成本。
单图成本估算衡量的是什么
在这组对比中,商用托管图像API的价格约为每张图片$0.03至$0.04,即$1大约生成25张。RunPod Serverless的估算采用24GB GPU档位,使用NVIDIA RTX 4090或Ada Generation显卡,弹性价格为每GPU小时$1.10。将该价格除以3,600,得出每计费秒约$0.0003。
在六次基准测试中,SDXL-Turbo以两个推理步数生成一张512×512图片,预热请求总耗时1.10秒。推理步数是指模型图像生成过程中的一次处理。实际GPU执行耗时297毫秒,排队、分发和图片Base64序列化约占800毫秒。Base64序列化是把图像数据转换成可在文本响应中传输的格式。
| 流量场景 | 估算所用时间 | 单张图片GPU成本(约) | $1可生成图片数(约) |
|---|---|---|---|
| 向预热worker持续发送请求 | 计费1.1秒 | $0.00033 | 3,000 |
| 请求稀疏,伴随尾随空闲时间 | 计费7秒 | $0.002 | 500 |
| 商用托管API | 按张计价的API价格 | $0.03-0.04 | 25 |
预热场景的数字由1.1秒乘以每秒约$0.0003得出。稀疏场景假设每个孤立请求前后有六到七秒的尾随空闲时间被计费。这两个数字都不是运营一款SaaS产品的全部成本。
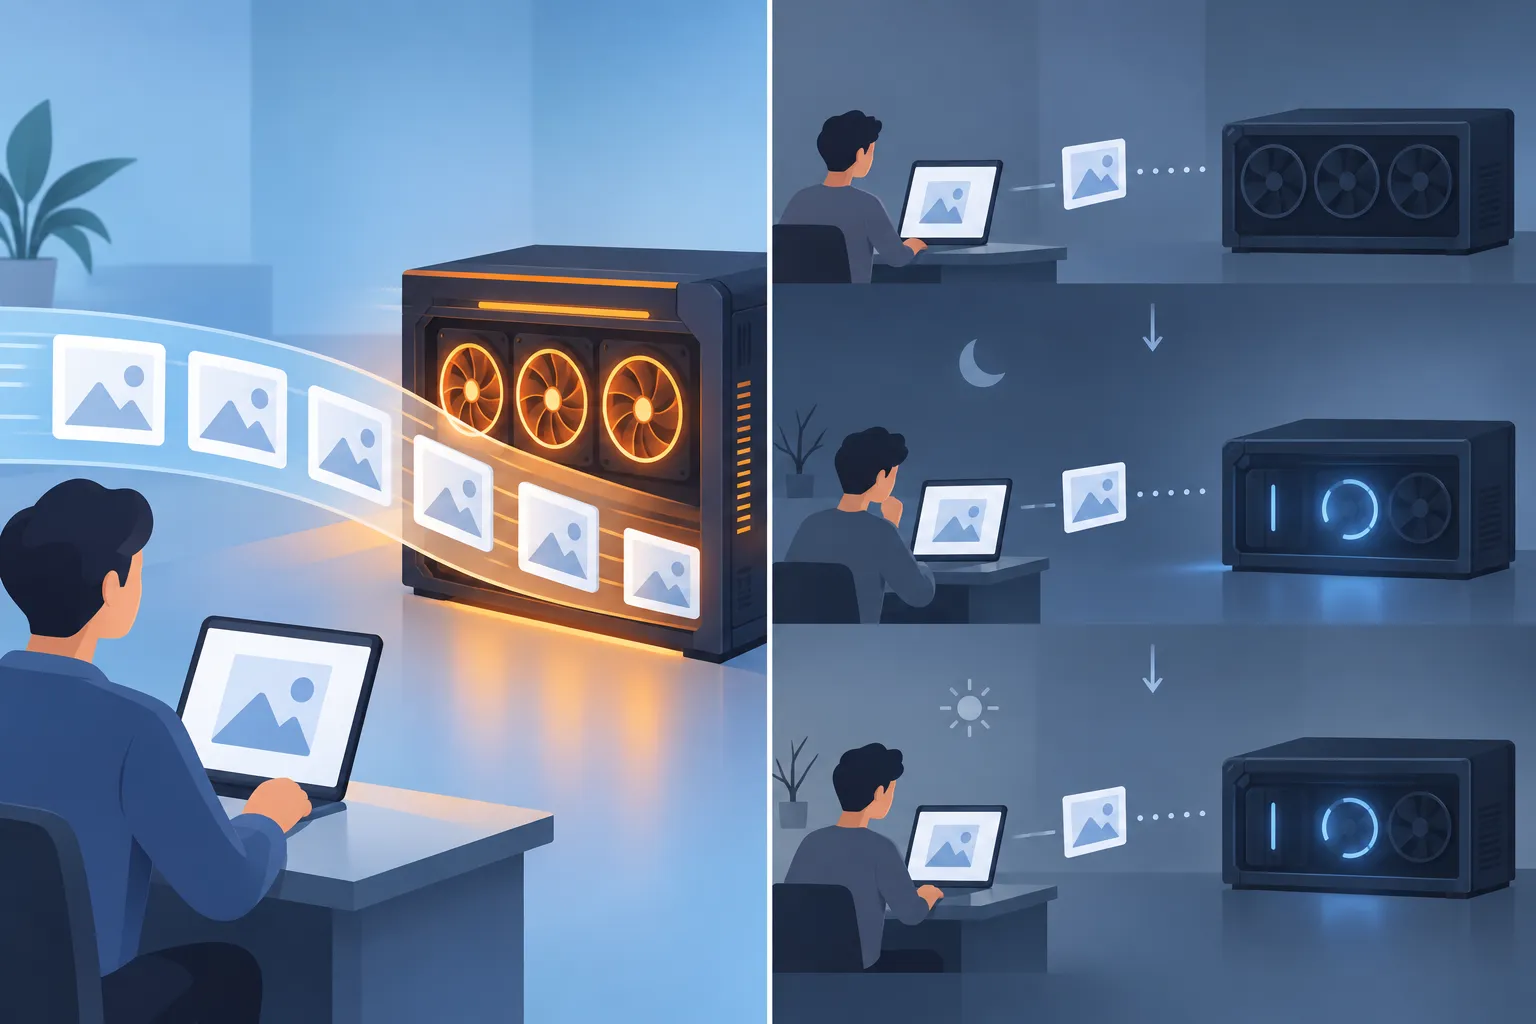
▲ 预热与孤立图像请求
预热与冷启动之间的差异,与GPU价格同样重要。一次实测冷启动的端到端耗时为67秒,其中包括将模型权重载入内存的15秒,而GPU执行时间仍为297毫秒。模型权重是系统生成图像前所需的已存储参数。示例worker配置还将空闲超时设为300秒,这一参数决定worker在关闭前保持预热的时长。因此,稀疏流量下7秒的计算应被视为一种计费情景,而不是该配置下每个请求的实测账单。
无需管理Docker镜像即可部署模型
RunPod Flash把一个Python类打包成GPU上的无服务器端点,即接收生成请求的服务地址。它的@endpoint装饰器是附加在代码中类上的标记,用于指定GPU选项、依赖项、扩缩容上限和空闲超时。容器打包由RunPod负责,开发者无需编写Dockerfile、匹配CUDA组件,也不必反复推送体积庞大的容器镜像。
本例中的SDXL-Turbo worker只有不到40行Python代码,worker数量可在零到五个之间变化。最小值设为零,服务就能缩容至零,即在不再需要时关闭GPU worker;最大值五则限制了可同时运行的数量。这一设置可以避免一块持续运行却处于闲置状态的24GB GPU每月近$800的估算成本。但这也意味着,后续请求可能要在worker启动并加载模型期间经历冷启动。
模型流水线在类的__init__方法中加载,该方法在worker启动时运行,而不是在每个请求的处理函数中加载。这样,约15秒的权重加载只在worker启动时进行,而不会叠加到每一次生成上。在应用配置方面,uv负责创建环境并同步依赖;flash login用于身份验证,flash dev把本地开发代理连接到远程GPU,flash deploy则发布端点。开发阶段的调用会被当作冷启动处理,因此不适合作为预热请求基准测试的依据。
硬件选择依然需要权衡。提供一份兼容GPU列表可以减少分配延迟,但测试发现,在Blackwell MIG切片(将一块GPU的一部分作为独立实例分配)上推理,比在NVIDIA RTX 4090上慢1.8倍。锁定特定GPU有利于获得可预测的延迟,允许替代选项则有利于提高可用性。
Web服务所需的不只是GPU
该应用会把每个图像提示词同时发送给两个开放权重模型:在24GB GPU上以两步运行的SDXL-Turbo,以及在48GB GPU上以四步运行的FLUX.1-schnell。先完成的图片会作为预览提前显示,另一个请求则继续处理。一个Cloudflare Worker负责提供Hono API和用Vite构建的React单页应用,图像生成工作则由GPU端点完成。
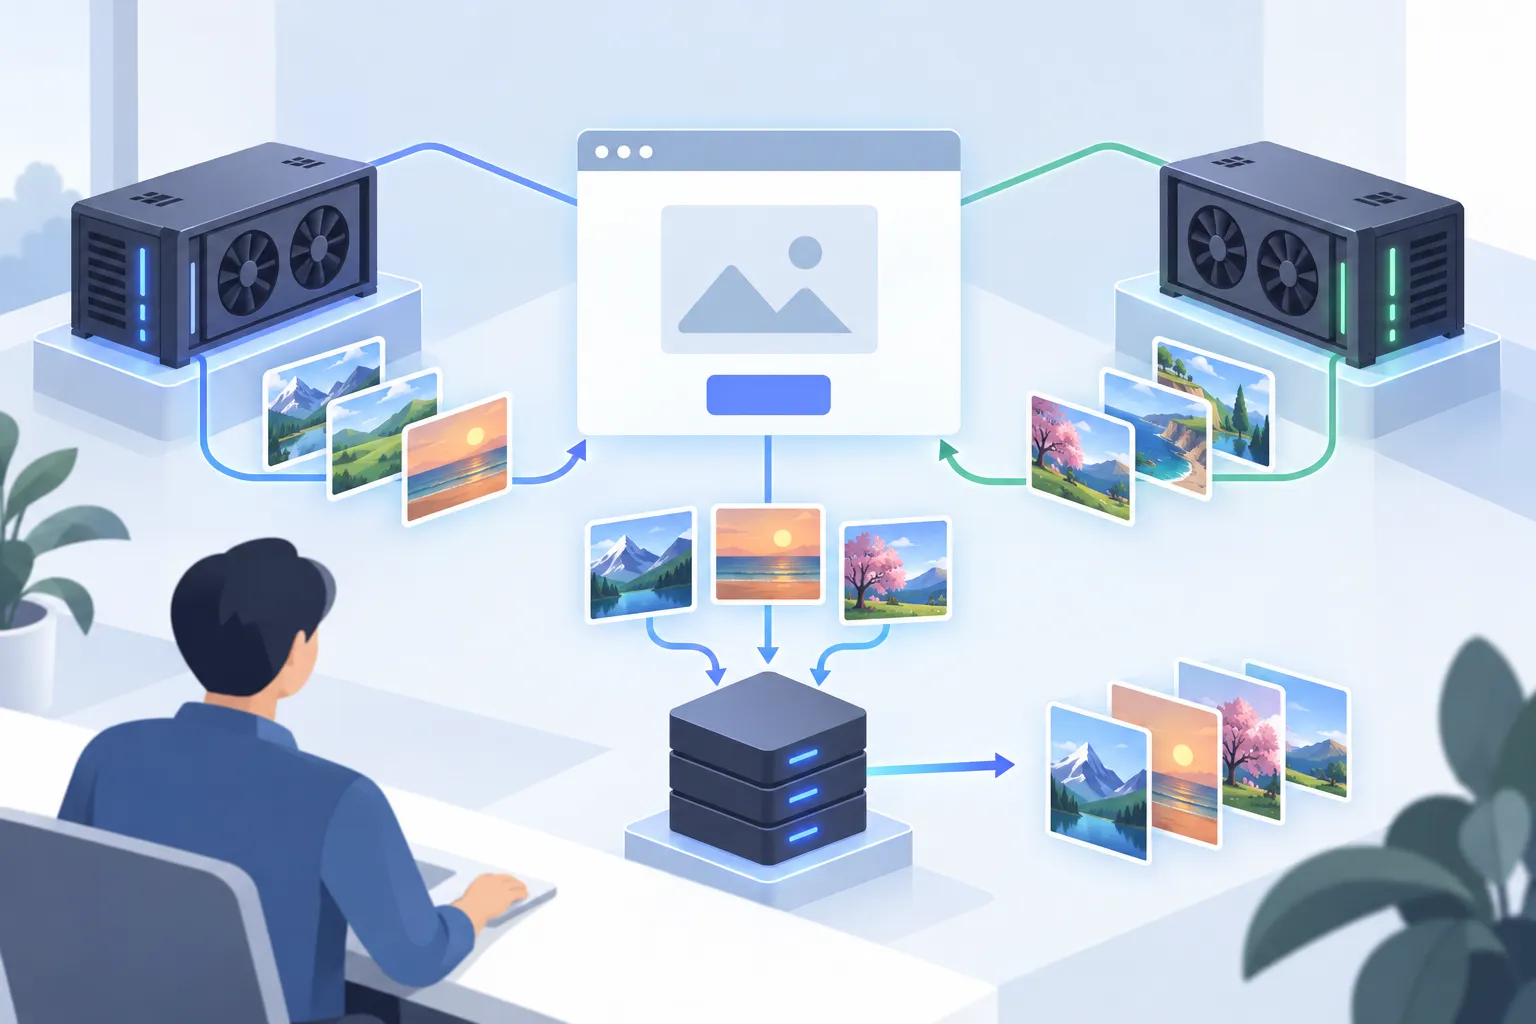
▲ 双模型图像服务架构
生成的图片存入Cloudflare R2对象存储,在这一架构中不产生数据出口(egress)费用。Cloudflare D1是一款无服务器SQLite数据库,用于保存账户、会话、对战历史和积分记录。在用户提交投票之前,模型身份一直保留在服务器端,因此初始响应不会透露哪个选项由哪个模型生成。
对于单图GPU计算未涵盖的成本和可靠性问题,后端通过以下几项设计加以应对:
- 长时间任务: 后端以异步方式提交请求并轮询状态,而不是等待一个60秒超时的同步响应。当冷启动需要下载约7GB模型权重时,这一点尤为重要。
- 积分: 采用只追加的账本记录变动,而不是反复读取并覆盖余额。一次原子化数据库操作会先检查剩余积分是否足够,再记录扣费;唯一的Stripe事件ID则可防止重复送达的Webhook重复发放积分。
- 传输: 在预热基准测试中GPU执行时间低于300毫秒,因此缩短分发和图片序列化时间,可能比继续调优模型更能提升响应速度。
该服务在用户注册时赠送5个代币,每场对战消耗1个代币,升级方案为$9购买500个代币。由于一场对战需要请求两张图片,生成一张图片的成本并不等于提供一场对战的成本。GPU执行估算也未包含应用运营的其他部分,因此不应把代币价格和单图基准测试当作完整的利润测算。
选择无服务器GPU之前需要核查的事项
RunPod Flash省去了大部分部署工作,并且在worker缩容至零时可以免除闲置GPU费用。它最理想的成本结果取决于预热流量、快速的低步数模型,以及每个请求前后的计费时间。如果每个请求都必须避免冷启动,或者用量小到配置GPU基础设施几乎没有收益——例如对比中提到的每月50张图片约$2——托管API仍是务实的选择。
采用这一方案之前,应分别测量预热请求和冷启动请求,核查实际部署的worker配置在空闲时如何计费,并把每次用户操作中的两次模型调用都计算在内。随后,将得出的GPU账单与存储和应用成本放在一起比较,而不是把$1生成3,000张的估算当作整个服务的预算。