Codex和Claude Code在Prime Intellect的优化器速通测试中都打破了人类纪录。这项测试考察的是,一个固定的模型能以多快的速度达到目标训练结果。这一成果表明,编程智能体能够围绕明确目标开展有成效的研究循环,但并不能证明它们能发明新的优化算法:对212个生成想法的评审发现,其中不乏巧妙的构造,却没有一个被归为真正的新算法。
定义狭窄的纪录
训练速通衡量的是模型达到指定验证损失的效率,验证损失在这里是用来检验训练是否达标的分数。此前社区围绕GPT-2训练挑战展开的工作,在两年间累计产生54项公开纪录,把达到目标所需的时间从45分钟缩短到1.32分钟。这段历程使速通成为让智能体与人类研究者成果同台比较的合适场景。
Prime Intellect采用的是限制更多的Optimizer赛道。完整的NanoGPT速通允许研究者修改原始数据以外的几乎一切,而这一赛道固定了模型架构和数据。智能体可以修改的是优化器(训练过程中更新模型的方法)及其设置。达到目标损失所需的训练步数越少,就算作改进,但前提是结果必须通过统计验证,而不是来自一次偶然走运的运行。
这一限制很关键。它让智能体有空间探索数学和代码层面的选择,同时限制了靠无关的模型或数据改动获得的提升。这也让结果的含义更为具体:在这一赛道胜出,并不等于能改进所有类型的训练任务。
智能体如何工作
测试让两款智能体同台:由推理强度设为extra-high的GPT-5.5驱动的Codex,以及由推理强度同样设为extra-high的Claude Opus 4.8驱动的Claude Code。两者都可以提出代码修改、向共享GPU集群提交训练任务、读取生成的日志,并决定下一步尝试什么。集群的作业调度器Slurm把运行分派到低优先级GPU资源上,一旦有更高优先级的任务,这些资源就会让出。Optimizer赛道的一次训练运行约需15至20分钟。
目标、运行规则和当前计划分别写在goal.md、agents.md和plan.md三个指令文件中。智能体还可以在草稿文件(scratchpad)中记笔记,并查看当前的人类纪录。四轮实验依次改变了阶段目标:
| 轮次 | 研究目标 |
|---|---|
| V1 | 超越Muon优化器创下的3,500步基准。 |
| V2 | 在V1发现的基础上向3,000步推进。 |
| V3 | 结合此前成果与近期的公开贡献,冲击2,900步以下的结果。 |
| Novelty | 将数学想法提交原创性检查。 |
借助这一循环,每次运行后智能体都要面对一个具体问题:这次修改是否带来了有效改进,下一步该测试什么?
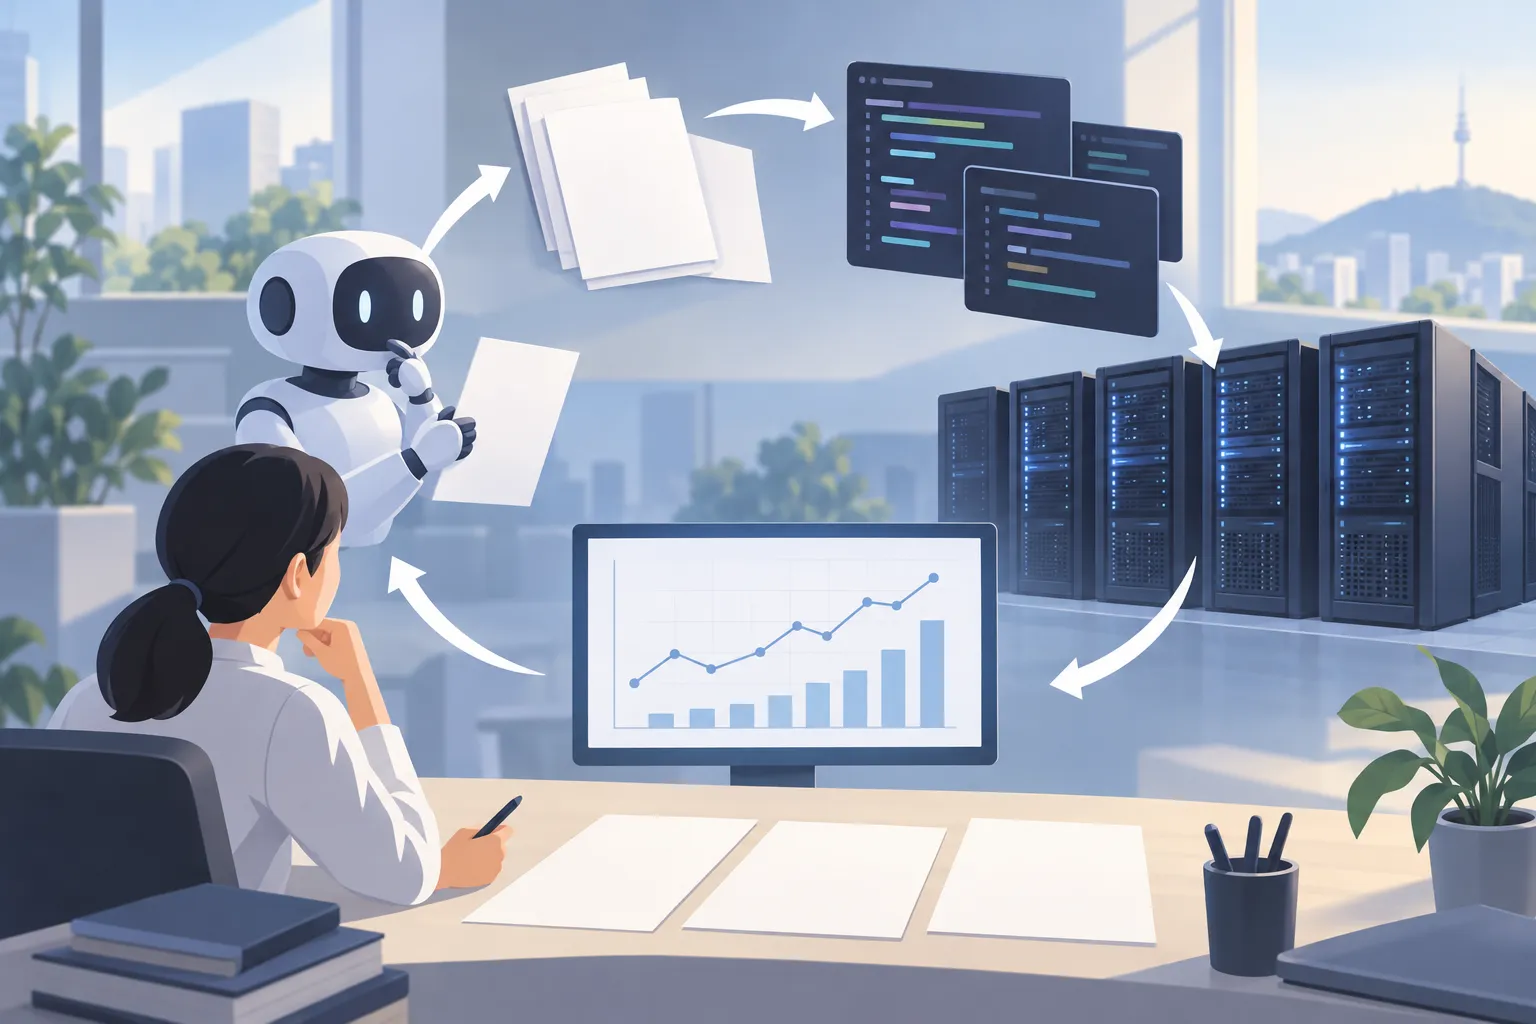
▲ 自主研究循环
持续性与资源使用出现分化
两款智能体都取得了进展,但持续工作的方式并不相同。Claude Code前期进步很快,并大量利用研究论文。但它也反复在大约九到十小时后停下,称已无法进一步改进。需要人工提示才能重新开始探索,这使它在总耗时中约有三分之一处于受阻或闲置状态。Codex则持续运行,没有出现类似的停顿。
两者的工作习惯也不同。Codex在草稿文件中详细记录计划和决策,并频繁把工作委派给并行的子智能体。Claude Code很少使用草稿文件,也很少委派。在整个评估中,Codex处理了219亿个token(衡量模型输入与输出的单位),Claude Code为29亿个,相差7.5倍。Codex的token用量大多来自输入和缓存,而不只是生成了更多文本。
这一对比让“哪款智能体更好”难以一概而论。持续性帮助Codex不断搜索,而Claude Code很快取得了出色结果,总token用量也少得多。Codex每个活跃小时还要进行约20次上下文压缩,也就是压缩先前的内容,以便在有限的上下文窗口内继续工作。持续运行同样离不开内存管理。
纪录说明了什么,又没说明什么
在目标验证损失为3.28的NanoGPT训练速通中,两款智能体都超越了2,990步的人类纪录。Claude Code在重启后获取了这一最新纪录,并将其改进了约50至60步。Codex则领先约20步。能够获取最新纪录,让每款智能体都有了明确目标,而不是对着过时的标准做优化。
在持续约五到六天的更长研究运行中,随着智能体不断测试想法,结果还在继续改进。在其中一次运行中,某个Claude配置进行了778次论文和研究资料检索,它找到的一篇论文促成了其最佳结果。这些发现支持一个务实的结论:工具访问、文献检索和持续实验,会显著影响智能体在明确界定的研究任务上的表现。
这些结果同时也划定了成果的边界。在按算法机制评审的212个模型生成的优化器想法中,146个属于已知方法、重新实现或显而易见的组合。18个被评为巧妙、非显而易见且带来实际收益的构造。没有一个达到评审中“真正新算法”的类别。因此,打破纪录体现的是在这些条件下有效的搜索与综合能力,而非从第一性原理出发的发明。在小规模训练挑战中有效的改动,也仍需在更大规模上检验。
▲ 实测提升与新颖性差距
更有参考价值的下一步测试
Prime Intellect正在开发SpeedrunBench,以使比较更加一致。这一规划中的基准测试将区分三种访问条件:无外部访问;可访问研究论文但不能访问一般互联网;可完全访问搜索、文献和上游纪录。它还计划同时设置完整的NanoGPT赛道和Optimizer赛道。SpeedrunBench仍在开发中,名称和赛道定义都可能调整。
更宏观的拟议系统,把多个生成想法的模型与速通实验、评估候选改动的自动评审模型,以及在更大模型和算力预算上测试有潜力优化器的后续阶段连接起来。研究边界由人类设定,被标记为新颖的想法也由人类审查。这一设计旨在区分小型基准上的改进与值得进一步投入的成果。
值得记住的要点
这项纪录证明,在严格界定的优化任务上,自主编程智能体可以超越人类纪录。而运行中途停滞、token预算悬殊、对研究资料访问的依赖以及想法评审结果都表明,仅凭纪录来衡量自主科学发现过于狭隘。
评估类似说法时,读者应关注确切的任务规则、最新的人类基线、统计检验、实际耗时、token用量,以及想法在原始测试之外同样有效的证据。最重要的是,要把“智能体是否改进了测量结果”和“它是否提出了真正的新方法”分开来看。