本地 AI 硬件决定两件不同的事:能加载多大的模型,以及模型能以多快的速度响应。价格较低的英伟达 RTX 3060 可以让一个 80 亿参数模型以每秒 40 至 50 个词元的速度生成内容,而价格更高的系统则能容纳大得多的模型。预算该定在什么水平,取决于你是需要小模型快速回答、在复杂任务上获得更强表现,还是希望把超大模型留在自己的设备上运行。
内存容量决定上限,带宽决定速度
本地 AI 模型由存储起来的数值权重构成。推理运行环境是加载这些权重并生成回答的软件,相关计算在你的设备上完成。在完全本地化的配置中,模型及调用它的软件都可以离线工作。一个看起来在本地运行的应用,不一定完全在本地运行:例如,Cursor 或 Claude Code 可以在电脑上运行,同时将提示词和项目上下文发送给云端模型。
选择硬件前,先检查其高速内存:独立 GPU 的 VRAM,即显存;或 Apple Silicon Mac 可使用的共享统一内存。模型必须能较宽裕地装入这部分内存。因此,容量限制了模型规模。内存带宽指系统从内存传输数据的速率,在很大程度上决定生成速度。词元是模型生成的一小段文本,因此每秒生成的词元数是衡量响应速度的实用指标。
▲ 内存容量与带宽
这些限制可能让不同机器各有优势。英伟达 RTX 4090 拥有 24GB 显存,内存带宽超过每秒 1TB。部分 Apple Silicon 配置提供 64GB 或 128GB 统一内存,可以容纳更大的模型,但标准配置的带宽大约只有顶级独立 GPU 的 20% 至 30%。容量更大,并不意味着文本生成一定更快。
选择能装进设备的模型
模型名称可以简要提示硬件需求。以 Qwen 3.8 27B Q4 为例,Qwen 表示模型系列,3.8 表示版本,27B 表示 270 亿个参数,也就是存储起来的权重值。Q4 表示 4 位量化:以更低精度存储权重,从而缩小文件体积和内存占用。Q4 量化可将模型压缩至未压缩时的大约四分之一,且输出质量损失很小。
Qwen 3.5 4B 这样的小模型约占 1GB 至 2GB 存储空间,适合作为入门选择。若想搭建能力更强的本地系统,通常可以把 8B 至 35B 参数的模型作为实际目标。即使经过量化,参数量更大的模型通常仍需要更多内存和算力。
专家混合架构(Mixture of Experts,MoE)是另一种值得了解的模型设计。它需要将整套专用模型权重保存在内存中,但计算每个词元时只使用其中一部分。因此,它的生成速度可能比总参数量所暗示的更快;不过,整个模型仍须能装入内存。Qwen 3.5 122B MoE 就是一款面向内存容量远高于入门级 PC 的硬件的模型。
三级预算及其可能实现的效果
以下价格针对所列硬件,不代表组装一台完整 PC 的保证成本。在 2026 年内存短缺的背景下,这些价格也会变化。相比固定报价,更值得关注的是内存规格以及硬件能运行的模型。
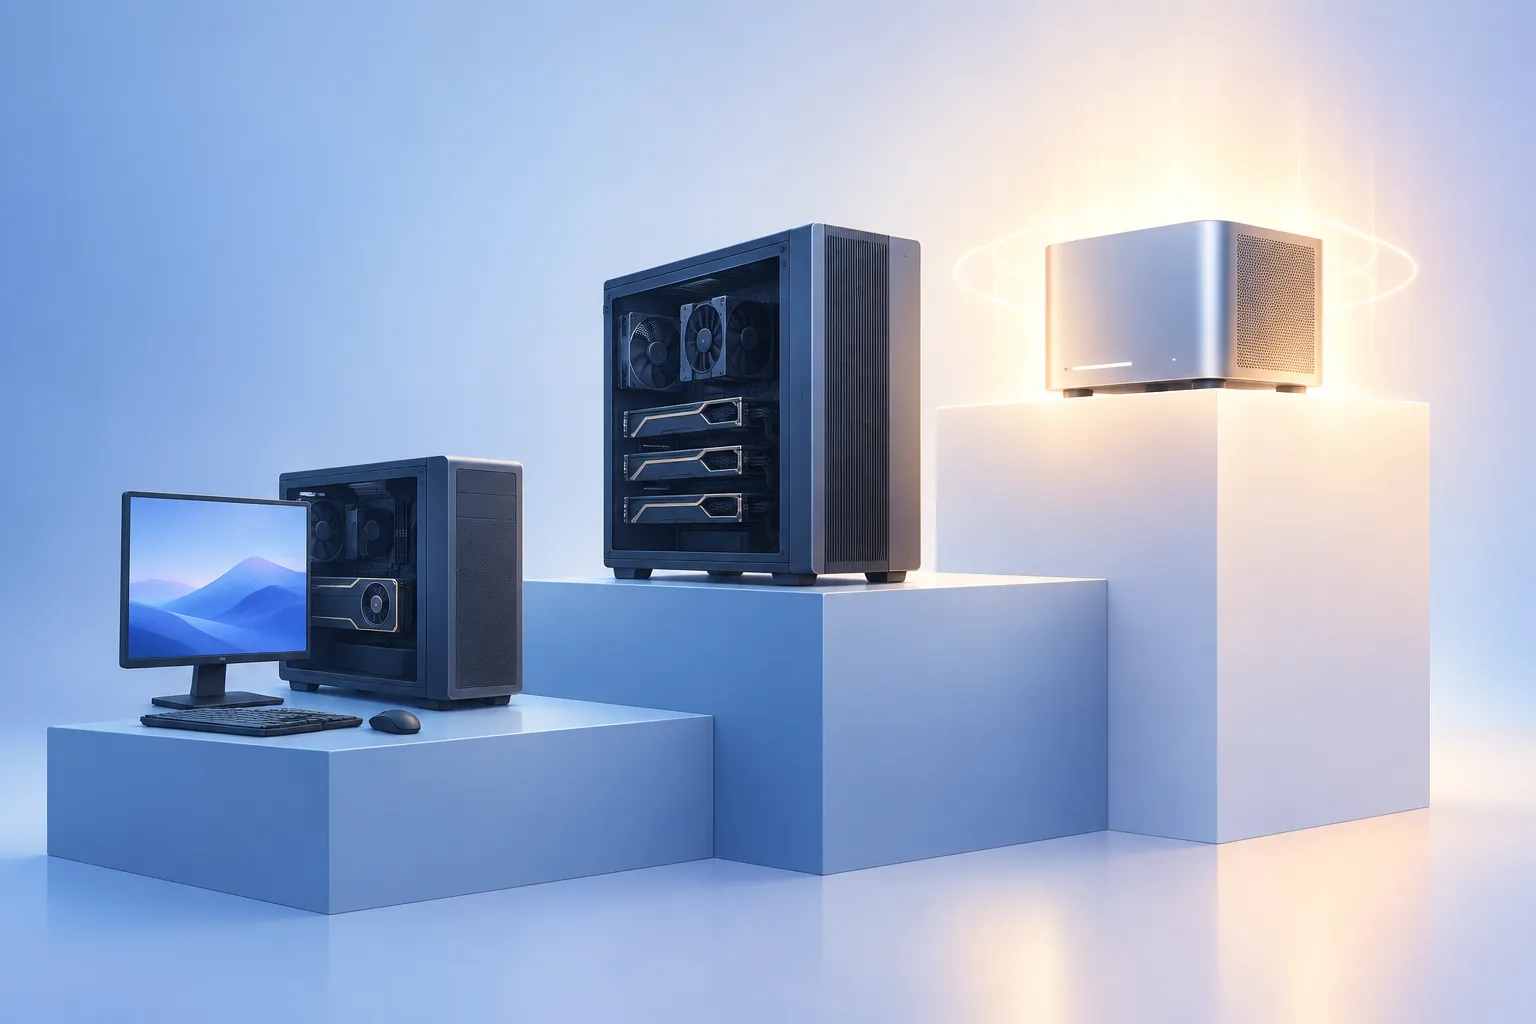
▲ 本地 AI 硬件三级配置
这里具体的速度数据只有两组:RTX 3060 运行 8B 模型,以及英伟达 DGX Spark 运行更大模型的结果。中档配置被描述为响应速度可用,但没有给出每秒词元数,因此不能根据其他档位推断它的速度。
| 档位 | 硬件及所列价格 | 内存与实际效果 |
|---|---|---|
| 入门 | 英伟达 RTX 3060:二手约 $300 至 $400,或新生产显卡标示的建议零售价 $339。基础款苹果 Mac mini:约 $799 至 $800。 | RTX 3060 配备 12GB 显存,运行 Q4 8B 模型时约为每秒 40 至 50 个词元。Mac mini 也能运行 8B 模型,但速度略低,未给出具体数字。 |
| 中档 | 英伟达 RTX 3090:显卡约 $800 至 $1000。搭载 M4 Pro 的 Mac mini:约 $1800。 | RTX 3090 配备 24GB 显存;该款 Mac mini 配备 48GB 统一内存。两者都能运行 Q4 27B 模型,响应速度可用。 |
| 高端 | AMD Strix Halo 迷你电脑:约 $2500。搭载 M5 Max、配备 128GB 内存的 Mac Studio:约 $2499。英伟达 DGX Spark:约 $5000。搭载 M5 Ultra 的 Mac Studio:约 $5499。 | 要运行约 120B 参数的模型,目标是配备约 128GB 高速内存。在一项 DGX Spark 测试中,120B 模型的生成速度约为每秒 40 个词元;35B 至 70B 模型达到每秒 60 至 90 个词元。 |
入门档适合私密写作、摘要生成和文档审阅,但并不足以胜任复杂的多步骤编程智能体任务。如果要运行 27B 模型来承担高要求的开发工作(包括本地编程智能体),中档是更实际的起点。两种中档选择也清楚体现了容量与速度的取舍:Mac mini 提供更多内存,独立 GPU 则在带宽上占优。
在高端档位,约 128GB 的内存目标让运行大得多的模型成为可能,但 DGX Spark 的数据表明,模型规模仍会影响速度:它运行较小的 35B 至 70B 模型时,每秒生成的词元数高于运行 120B 模型时。M5 Ultra 版 Mac Studio 的内存带宽为标准 Mac 配置的四倍,在一定程度上缓解了统一内存通常面临的速度限制。这项规格并不是实测的词元生成速度。
判断这样的取舍是否值得
开始之前,先确认设备确切的显存或统一内存容量。然后选择能较宽裕地装入内存的模型;如果需要在消费级硬件上降低内存占用,可以选用 Q4 版本。Ollama 提供命令行模型管理功能,Docker Model Runner 可为容器化工作负载提供服务,LM Studio 则提供图形界面。这些运行环境也能让其他应用调用本地模型。要验证所选配置是否完全在本地运行,可以断开 Wi-Fi,再检查它是否仍能工作。
在完全离线的配置中,本地运行能让提示词留在设备上,也不必持续支付模型订阅费,但性能足够强的硬件需要一笔可观的前期投入。对于没有严格本地隐私要求的日常工作,每月 $20 至 $60 的云端订阅可能提供更强的模型能力,配置也更省事。如果隐私要求必须在本地推理,就从任务出发确定模型规模,再同时按容纳模型所需的内存容量和保证使用速度的带宽来选购硬件。