Google DeepMind의 오픈 모델 Gemma 4가 서버 없이 웹 브라우저 안에서 바로 답을 내는 수준에 이르렀습니다. API를 부르지 않으니 사용자 데이터가 기기 밖으로 나가지 않고, 호출 요금이나 네트워크 지연도 없습니다. Gemma 4는 상업적 이용과 수정이 자유로운 Apache 2.0 라이선스로 공개됐고, 휴대전화에서 돌릴 2B부터 GPU 한 장에 올릴 31B까지 다섯 가지 크기로 나옵니다. 개발자 입장에서는 클라우드 API와 로컬 실행 가운데 하나를 고르는 일이 이제 현실적인 설계 선택이 됐다고 볼 수 있습니다.
매주 새 기능을 내놓는 Google DeepMind
Google DeepMind는 AI를 책임 있게 만들어 인류에 이롭게 쓴다는 목표를 내세웁니다. 단백질 구조를 예측하는 AlphaFold, 의료·생명과학용 오픈 모델 Med-Gemma, 수학과 로봇 연구가 이 목표 아래 진행되고 있습니다. 동시에 개발자용 제품을 매주 내놓을 만큼 출시 속도가 빠릅니다.
최근 나온 개발자 기능은 다음과 같습니다.
- Computer Use API: AI가 컴퓨터를 직접 다루는 computer use 기능용 API
- Managed Agents: 자연어로 큰 목표를 주면 격리된 Linux 작업 환경(sandbox) 안에서 여러 agent(스스로 작업을 나눠 처리하는 AI)가 일을 처리하는 기능
- Speech-to-Speech 번역 API: 말을 다른 언어의 말로 바로 옮기는 API
이처럼 클라우드에서 쓰는 최신 Gemini 계열 모델과 함께, 내려받아 직접 돌리는 오픈 모델 라인업도 키우고 있다는 점이 눈에 띕니다.
Gemma 4의 다섯 가지 크기
Gemma 4는 가중치(학습으로 정해진 모델의 수치)를 공개한 open-weights 모델입니다. Apache 2.0 라이선스라 내려받아 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법)하고, 수정해 상업적으로 배포해도 라이선스 비용이 들지 않습니다.
| 모델 | 구조 | 알맞은 실행 환경 |
|---|---|---|
| 2B(E2B) | 소형 | 휴대전화, 브라우저 |
| 4B(E4B) | 소형 | 휴대전화, 노트북 |
| 12B | 중형 | 일반 개발용 노트북 |
| 26B(26B-A4B) | mixture-of-experts | GPU 한 장 |
| 31B | dense | GPU 한 장 |
mixture-of-experts는 여러 전문가 하위 모델 가운데 일부만 골라 계산하는 구조이고, dense는 모든 매개변수를 매번 쓰는 구조입니다. 12B 이하는 일반 개발용 노트북에서, 2B는 휴대전화의 전용 가속기에서 돌릴 수 있습니다. 더 작은 모델은 Jetson Nano 같은 소형 보드에도 올릴 수 있습니다.
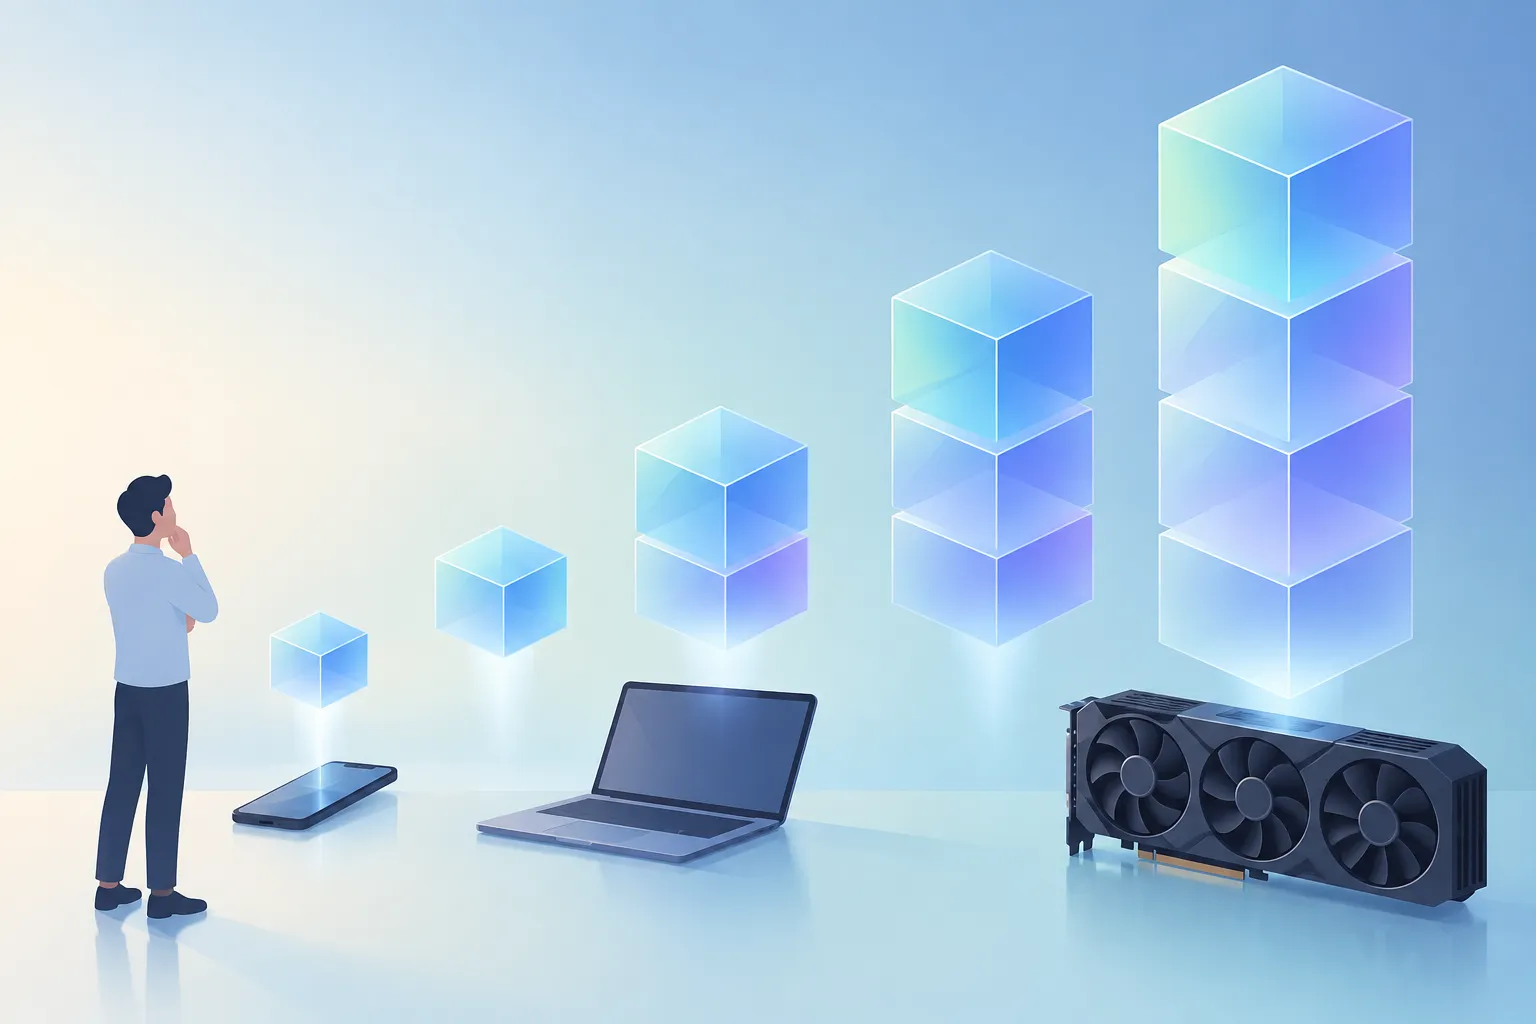
▲ Gemma 4의 크기별 실행 환경
브라우저 안에서 끝나는 추론
Gemma 4의 2B 모델은 서버 없이 웹 브라우저 안에서 모든 계산을 끝낼 수 있습니다. Transformers.js와 WebAssembly(브라우저에서 빠른 실행 코드를 돌리는 기술)로 모델을 실행하고, 계산은 Fable 5가 최적화한 GPU 커널이 맡습니다. 다만 이런 초기 커널 생성 도구는 널리 배포하기 전에 손보고 다시 써야 했습니다.
예를 들어 Harry Potter 시리즈 각 권을 재미와 긴장감으로 비교하고 읽는 순서를 추천하는 표를 이모지와 함께 만들어 달라고 하면, 모델은 곧바로 재미 정도, 긴장감, 전체 분위기, 추천 여부를 열로 나눈 표를 내놓습니다. 순위 자체에는 이견이 있을 수 있지만, 복잡한 요청을 구조화된 답으로 바꾸는 일을 서버 없이 해낸다는 점이 핵심입니다.
브라우저 실행에서 측정된 수치는 다음과 같습니다.
- 첫 token(모델이 글을 처리하는 단위)이 나오기까지 0.25초
- 입력 처리 속도 초당 85.71 token
- 답 생성 속도 초당 20.72 token
계산이 100% 기기에서 이뤄지므로 데이터가 브라우저 밖으로 나가지 않습니다. 개인정보를 다루는 서비스나 서버 비용을 줄이고 싶은 서비스에 특히 의미가 큰 방식으로 보입니다.
휴대전화에서 돌리는 Google AI Edge Gallery
Google AI Edge Gallery는 Android, iOS, macOS에서 쓸 수 있는 앱으로, 인터넷 연결 없이 기기 안에서 AI 모델을 돌려 볼 수 있습니다.
- Ask Image: 사진 내용을 이해하고 설명
- Audio Scribe: 140개가 넘는 언어의 음성을 오프라인으로 받아 적고 번역
- 기기 내 function calling: 모델이 앱 기능을 직접 호출해 정보를 뽑거나 캘린더에 일정을 넣는 기능
- 작은 앱들: Tiny Garden 게임, Haiku Card, 날씨 조회, 2048 게임 등
Google Pixel 10처럼 NPU(AI 연산 전용 칩)와 GPU를 갖춘 휴대전화에서는 CPU에 부담을 주지 않고 Gemma 모델이 매끄럽게 돌아갑니다. 반대로 전용 가속기가 없어 CPU로 계산해야 하는 저사양 휴대전화에서는 성능이 떨어질 수 있습니다.
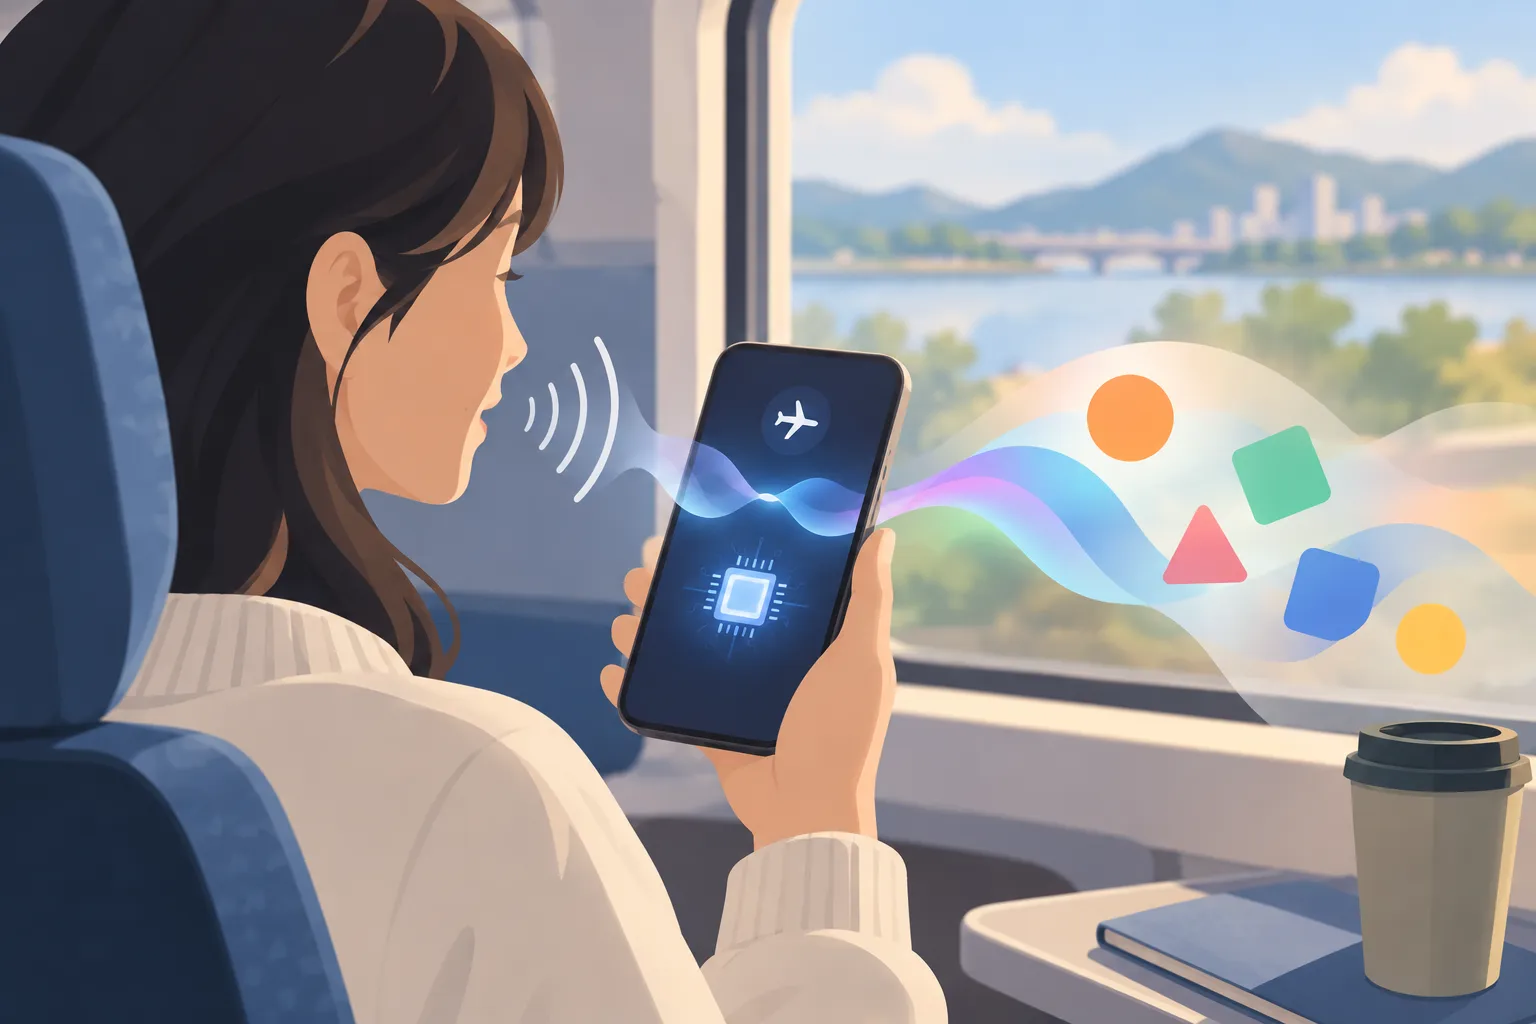
▲ 오프라인 기기 내 AI
작은 크기로 큰 모델과 겨루는 성능
Gemma 4의 26B와 31B thinking 모델은 모델 사이의 상대 실력을 나타내는 Elo 점수에서 약 1440~1460을 기록했습니다. 매개변수가 열 배쯤 많은 경쟁 모델보다 높은 점수입니다. 모델이 작으면 여러 서버에 나눠 돌리는 분산 추론이 필요 없어 인프라 비용이 줄어듭니다.
메모리를 더 줄이는 방법은 QAT(Quantization-Aware Training, 숫자 정밀도를 낮춘 상태를 고려해 학습하는 방식) 체크포인트입니다. 크기별로 필요한 메모리는 다음과 같습니다.
| 모델 | BF16(16비트) | Q4_0(4비트) | 모바일 | 모바일 텍스트 전용 |
|---|---|---|---|---|
| 2B | 11.4GB | 2.9GB | 1.1GB | 0.84GB |
| 4B | 17.9GB | 4.5GB | 2.5GB | 2.2GB |
| 12B | 26.7GB | 6.7GB | - | - |
| 26B | 57.7GB | 14.4GB | - | - |
| 31B | 69.9GB | 17.5GB | - | - |
2B 모델은 16비트에서 11.4GB가 필요하지만 모바일 텍스트 전용 형식에서는 0.84GB로 줄어듭니다. 1GB가 안 되는 메모리로 휴대전화에서 언어 모델을 돌릴 수 있다는 뜻입니다.
로컬 추론을 검토할 때 할 일
Gemma 4는 클라우드 API에 맡기던 일 일부를 브라우저와 휴대전화로 옮길 수 있게 합니다. 데이터를 밖으로 보내지 않아도 되고, 호출 요금과 지연이 없으며, 라이선스 부담도 적습니다. 로컬 추론을 검토한다면 다음 순서가 현실적입니다.
- Google AI Edge Gallery로 목표 기기에서 모델이 얼마나 빠르게 도는지 먼저 확인합니다.
- 기기 메모리에 맞춰 크기를 고르고, 메모리가 빠듯하면 QAT 체크포인트를 씁니다.
- 웹 서비스라면 Transformers.js와 WebAssembly로 브라우저 실행을 시험합니다.
- 업무에 맞게 다듬어야 하면 Apache 2.0 라이선스를 활용해 fine-tuning합니다.
저사양 기기에서는 성능이 떨어질 수 있으므로, 사용자 기기 분포를 확인하고 필요하면 클라우드 API를 함께 두는 구성을 고려하는 편이 안전해 보입니다.