AI 답변에 민감한 정보가 직접 나타나지 않더라도 데이터가 안전하다고 단정할 수는 없습니다. 직원이 입력한 내용은 검색 자료와 합쳐지고, AI agent(도구를 호출해 작업을 수행하는 AI 시스템)가 다른 시스템으로 전달할 수도 있습니다. 한 조사에 따르면 AI 관련 사고로 데이터 프라이버시 침해를 겪은 조직은 31%에 이릅니다. 보안 점검의 출발점은 어떤 AI 도구를 쓰는지 목록을 만드는 데서 그치지 않고, 데이터가 어디서 들어와 어떻게 바뀌고 어디로 가는지 파악하는 일입니다.
민감 데이터는 여러 경로로 들어옵니다
AI 시스템에서는 모델 학습부터 사용자의 요청, 검색 결과, 도구 호출까지 각각 다른 경로로 정보가 유입됩니다. 경로별로 확인할 대상도 다릅니다.
| 경로 | 점검할 데이터 이동 |
|---|---|
| 학습 데이터 | 민감 기록, 내부 코드, 지식재산이 학습 자료에 포함되는지 확인합니다. |
| 사용자 prompt | prompt(모델에 주는 지시문)에 입력하거나 붙여 넣은 기밀 내용이 어디로 전달되는지 확인합니다. |
| RAG | RAG(검색 결과를 답변 생성에 활용하는 방식)가 내부 문서, 스프레드시트, 데이터베이스에서 가져온 내용이 추론 과정에 어떻게 쓰이는지 확인합니다. |
| 시스템 지시 | 모델의 행동을 정하는 내부 정책과 운영 지침이 권한 밖에 노출될 가능성을 살핍니다. |
| AI agent | 데이터베이스 조회, 외부 도구 호출, 하위 agent의 작업으로 이어지는 이동을 확인합니다. |
직원이 내부 자료를 공개 챗봇에 올리면 그 자료가 공개 모델의 학습에 쓰일 수 있다는 점도 위험 경로입니다. 보안 검토 없이 도입된 내부 AI 시스템이라면 조직의 정책과 통제를 적용하기가 더 어렵습니다. 그렇다고 데이터 흐름을 막으면 AI 시스템도 제 역할을 하지 못하므로, 사용을 막기보다 흐름을 파악하는 쪽이 현실적인 대응으로 보입니다.
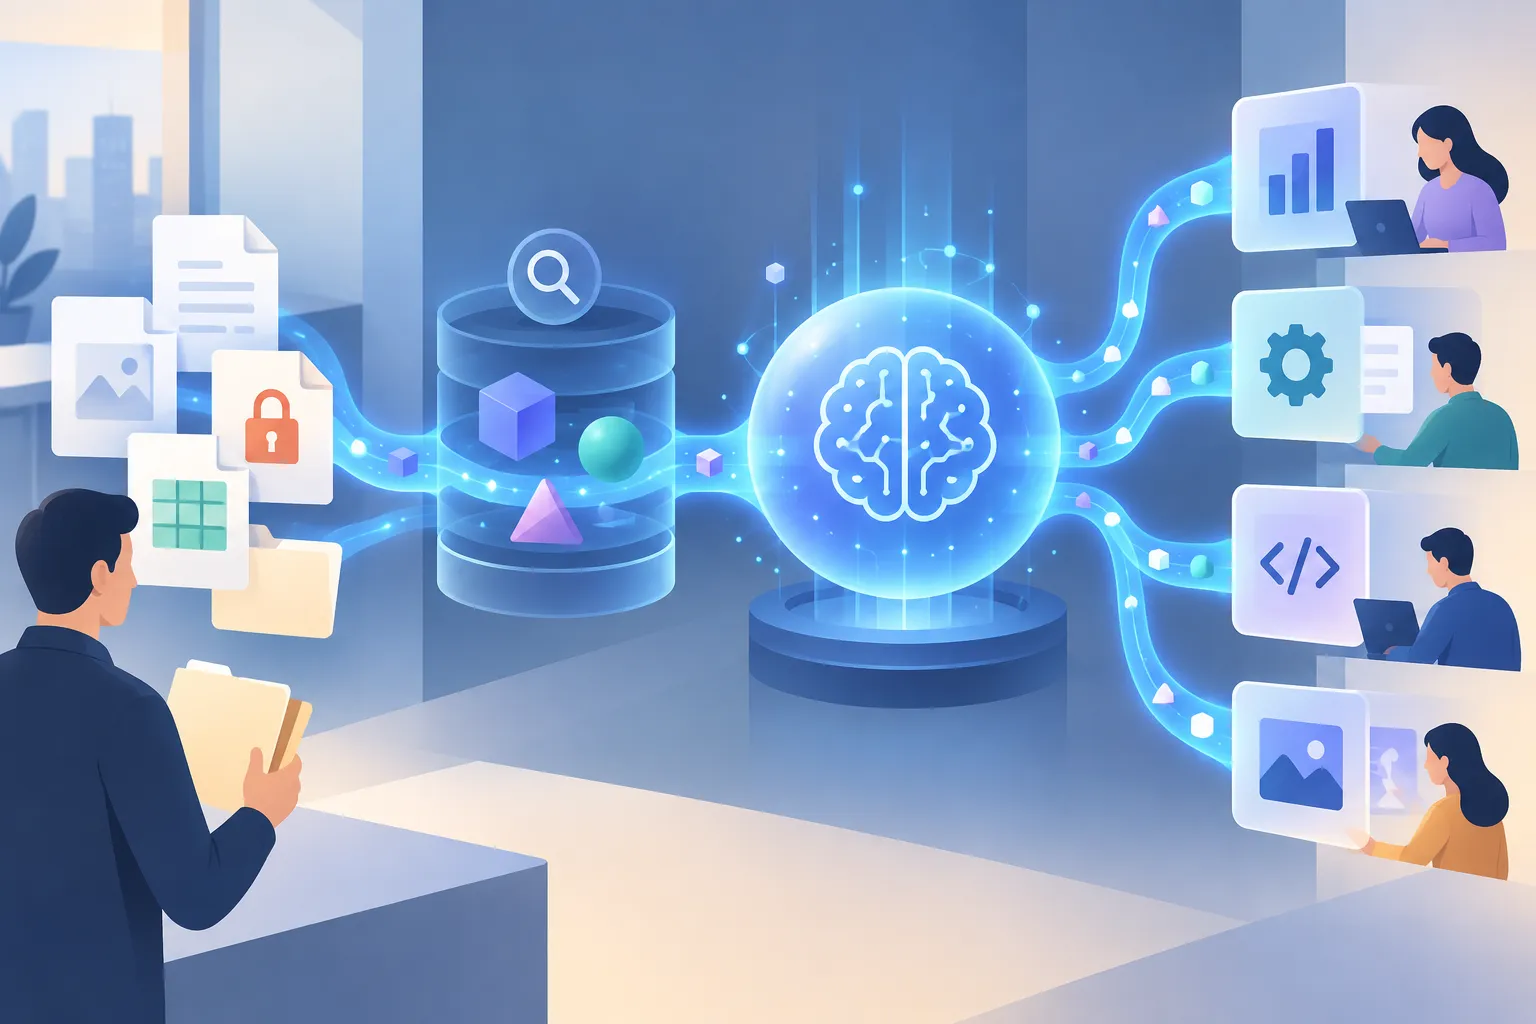
▲ 검색과 도구 호출 경로
기존 DLP(데이터 유출 방지 도구)는 주로 정적인 파일과 일반적인 네트워크 이동을 살피도록 설계됐습니다. 그러나 RAG가 가져온 문서가 embedding(텍스트를 검색에 쓸 벡터로 변환하는 과정)을 거쳐 벡터 데이터베이스에 저장되거나, agent가 여러 도구를 연달아 호출하면 원본 파일만 살펴서는 이동 경로를 놓칠 수 있습니다. 필요한 것은 원본과 변환된 데이터, 최종 도착지를 이어 보는 기록입니다.
시스템의 움직임과 직원의 사용을 함께 봅니다
점검 대상은 내부 AI 시스템이 데이터를 처리하는 시스템 작업 흐름과 직원이 AI를 쓰는 직원 사용 흐름으로 나눌 수 있습니다. 각 흐름에서 무엇을 관찰하고, 어떤 이동을 추적하며, 결과를 어떻게 제시할지 정해야 합니다.
| 흐름 | 관찰 | 추적 | 제시 |
|---|---|---|---|
| 시스템 작업 흐름 | AI 앱, RAG 자료 수집 과정, 벡터 데이터베이스를 살핍니다. | 원문이 벡터로 바뀌거나 형식이 달라져도 민감 데이터의 연결을 유지합니다. | 데이터의 출처, 변환, 도착지를 한 흐름으로 보여 줍니다. |
| 직원 사용 흐름 | 직원의 파일 업로드와 다운로드를 살핍니다. | 민감 내용의 복사·붙여넣기와 원본에서 파생된 파일의 관계를 추적합니다. | AI 결과물이 조직 안에서 어떻게 사용·공유되는지 보여 줍니다. |
파일에 붙은 보안 분류만으로는 충분하지 않을 수 있습니다. 직원이 파일의 일부를 AI 입력창에 붙여 넣거나 원본을 바탕으로 새 문서를 만들면, 원본 파일에 붙은 보안 분류 표시가 그 내용을 계속 따라가지 못할 수 있기 때문입니다. 원본과 파생 파일의 관계까지 기록해야 민감 정보의 이동을 이어서 확인할 수 있습니다.
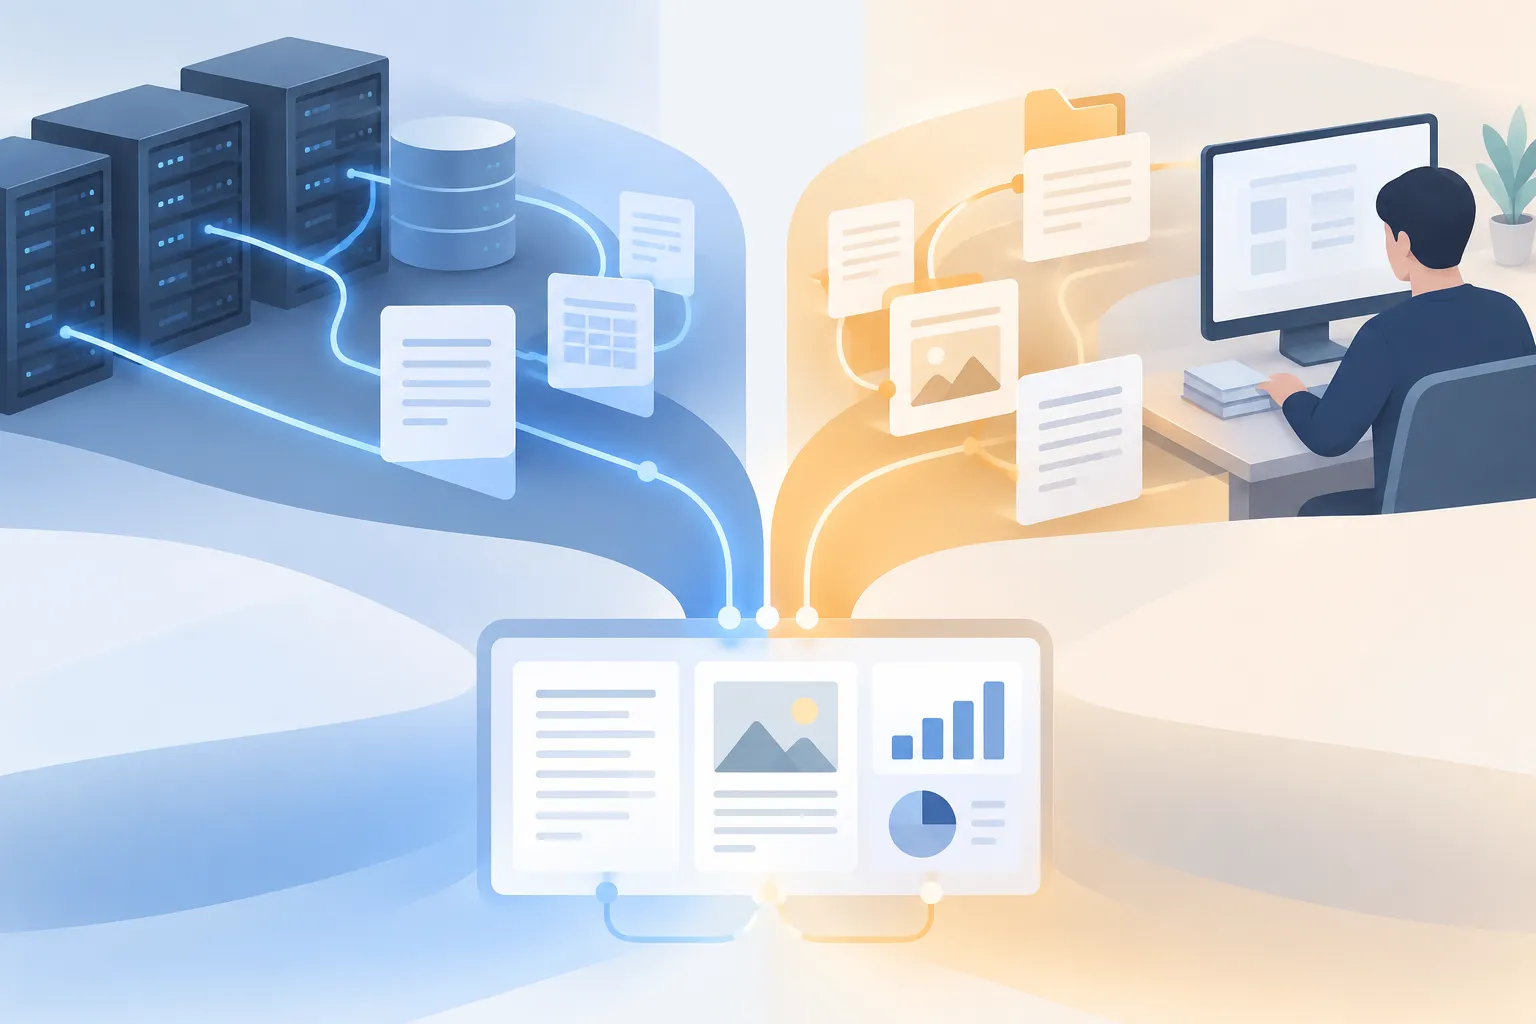
▲ 시스템과 직원 사용 흐름
흩어진 기록을 하나의 이동 경로로 연결합니다
현재의 탐지 수단은 서로 다른 부분을 봅니다. agent 운영 기록은 모델, prompt, agent와 MCP(모델과 도구를 연결하는 규격) 도구의 실행을 보여 줍니다. 직원의 컴퓨터를 살피는 DLP는 로컬 AI 도구와 브라우저 확장 기능 등을 확인합니다. 클라우드와 사내 저장소를 살피는 도구는 파일의 소유자와 민감도를 분류합니다. 각각의 기록만으로는 한 데이터가 전체 경로를 어떻게 지났는지 알기 어렵습니다.
따라서 점검 체계에는 세 가지 기능이 필요합니다.
- 지속적인 발견과 분류: 여러 저장소의 개인정보, 건강정보, 재무 자료, 지식재산을 자동으로 찾아 분류합니다.
- 처음부터 끝까지의 경로 추적: RAG 검색, 데이터 변환, 모델의 추론, agent 실행 사이에서 출처와 도착지의 연결을 유지합니다.
- 상황을 반영한 조사: 사용자의 권한, 데이터의 민감도, 이동 목적지를 함께 살펴 노출 가능성을 판단합니다.
이 기록을 한곳에서 연결하고 정책을 일관되게 적용하면, 도구마다 따로 확인할 때 생기는 공백을 줄일 수 있습니다. 상황 정보를 자동으로 결합하는 조사 방식은 분석에 걸리는 시간을 몇 주에서 몇 분으로 줄일 수 있습니다. GDPR, EU AI Act, SOC 2, HIPAA, ISO 27001 등에 맞춘 보고에도 데이터가 어디서 어떻게 이동했는지 설명할 근거가 필요합니다.
첫 점검은 데이터 한 건의 경로를 잇는 일입니다
조직에서 이미 쓰는 AI 시스템을 기준으로 민감 데이터의 입력 지점부터 목록화해야 합니다. 학습 자료와 prompt, RAG 저장소, 시스템 지시, agent가 접근하는 도구를 확인하고, 직원의 업로드·복사·붙여넣기 및 파생 파일 기록과 연결합니다. 그다음 데이터가 변환된 뒤에도 원본과 연결되는지, 최종 도착지와 접근 권한을 확인할 수 있는지 살펴야 합니다. 답변만 검사하는 방식에서 벗어나 전체 이동 경로를 설명할 수 있어야 노출 위험도 구체적으로 점검할 수 있습니다.