고객별 인프라를 운영하는 한 플랫폼 엔지니어링 스타트업에서 Elasticsearch는 로그를 찾아보는 저장소에 그치지 않습니다. AI agent(목표에 맞춰 도구를 사용하고 작업을 이어 가는 프로그램)가 지표와 로그로 장애 원인을 조사하고, 클러스터 설정까지 확인한 뒤 변경 요청을 작성하는 작업 흐름의 일부입니다. 핵심은 분석과 실행을 연결하되, 실제 변경에는 검토 가능한 경로를 두는 데 있습니다.
관측 비용을 낮추는 분리 설계
이 회사는 고객마다 격리된 Kubernetes 클러스터를 따로 운영합니다. 이런 환경 전체에 상용 관측 서비스를 적용하면 비용이 빠르게 늘어납니다. 회사 자체 추산으로는 Datadog을 사용할 경우 연간 비용이 $30만를 넘을 수 있습니다. 이는 이 회사의 배포 구조에 관한 추산이지, 다른 조직에도 그대로 적용되는 비용은 아닙니다.
이에 따라 수집·저장·시각화를 서로 다른 도구로 나눠 운영합니다. 지표는 VictoriaMetrics, 로그 검색은 Elasticsearch, 시각화는 Grafana를 사용합니다. 데이터 수집에는 OpenTelemetry 같은 수집 도구와 로그 수집 도구인 Filebeat·Logstash를 활용합니다. 운영 중인 Elasticsearch 클러스터는 약 12개입니다.
이 선택은 비용만의 문제가 아닙니다. 대시보드의 사용성이 낮아지면 개발자가 관측 데이터를 덜 활용할 수 있습니다. 이 회사는 사람이 여러 화면을 직접 뒤지는 대신 agent가 저장된 데이터에 질의해 답과 근거를 제시하도록 설계했습니다. 대시보드를 없앤다기보다, 데이터 보관과 검색 능력을 유지하면서 분석에 드는 수작업을 줄이려는 접근으로 볼 수 있습니다.
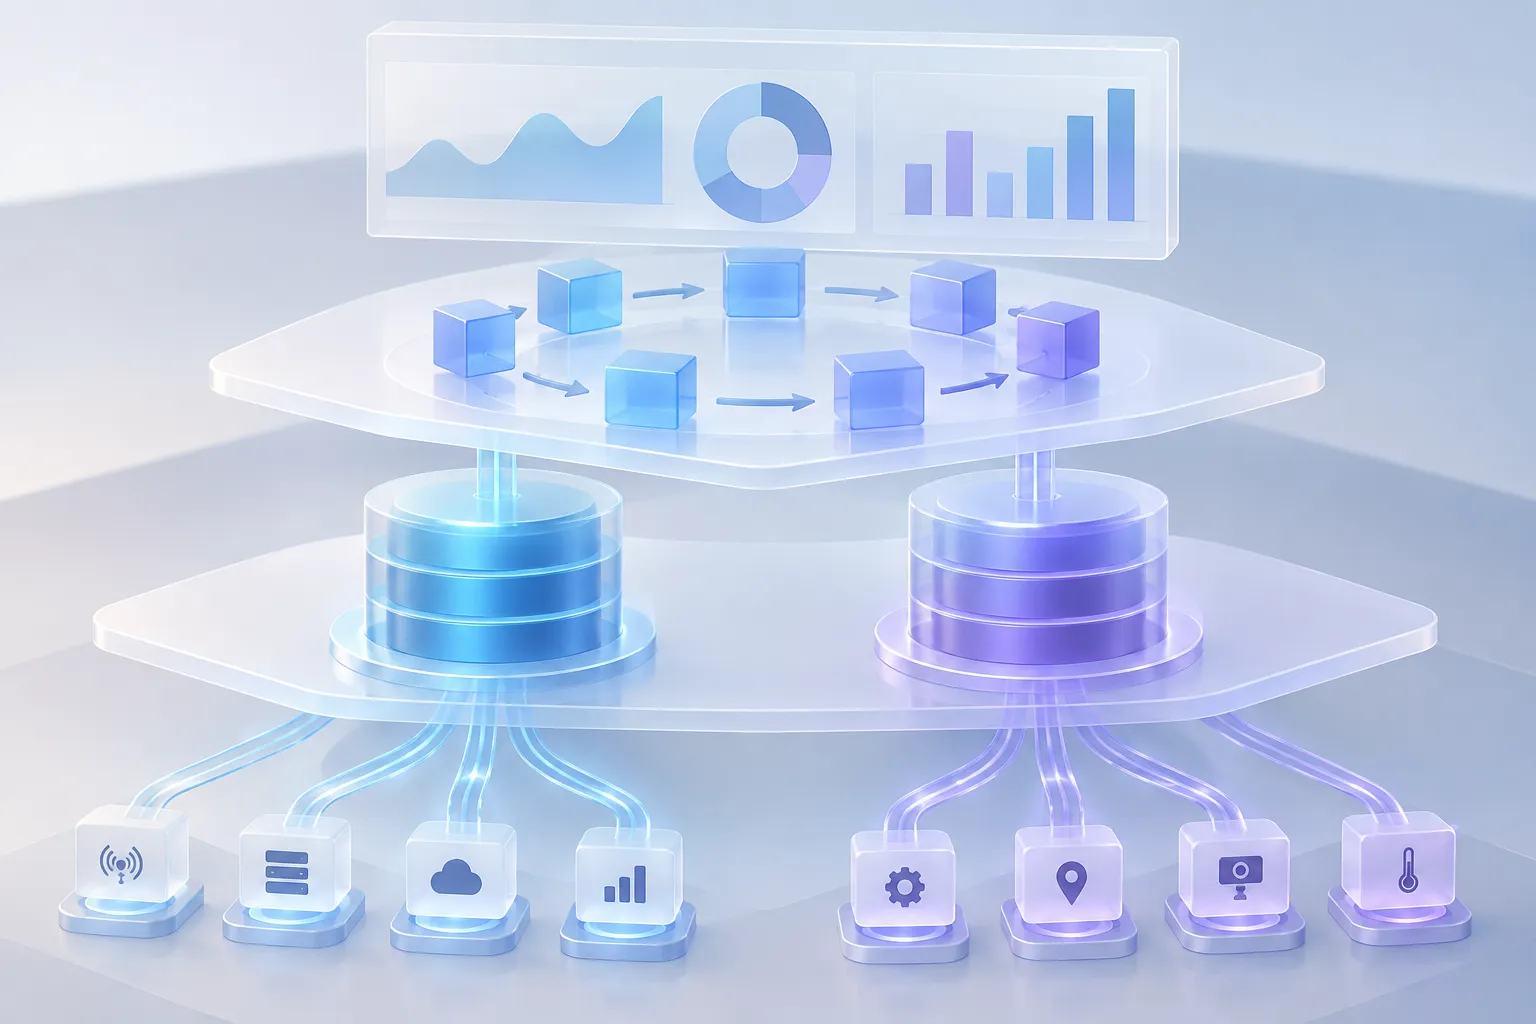
▲ 분리된 관측 데이터 구성
agent가 관리하기 전에 갖춘 클러스터 기반
agent가 운영을 돕더라도 Elasticsearch의 기본 관리 규칙은 필요합니다. 큰 인덱스가 계속 자라도록 두면 샤드가 고르게 분산되기 어렵습니다. Index Lifecycle Management(ILM, 인덱스의 교체와 삭제 시점을 관리하는 기능)를 이용하면 샤드 크기나 인덱스 나이를 기준으로 새 인덱스로 전환할 수 있습니다. 한 정책 예시는 기본 샤드가 50GB에 이르거나 인덱스가 7일이 되면 전환하고, 30일이 지난 인덱스를 삭제합니다.
클러스터 설정은 Elastic Cloud on Kubernetes(ECK)에 정의합니다. ECK는 Kubernetes에서 Elasticsearch 운영 작업을 자동화하는 operator(클러스터 관리 작업을 대신 수행하는 구성 요소)입니다. 노드 구성, 저장 공간, 버전 같은 설정을 파일로 관리하면 agent도 현재 상태를 읽고 수정안을 만들 수 있습니다. 변경 요청이 승인돼 설정이 반영되면 ECK가 순차 업그레이드나 저장 공간 확장 같은 작업을 처리합니다. 이처럼 설정 변경을 저장소에서 관리하는 방식이 GitOps입니다.
저장 공간, 노드 수, CPU·메모리 조정은 단순한 수치 변경이 아닙니다. Elasticsearch처럼 상태를 보유한 시스템에서는 재시작과 샤드 재배치가 뒤따를 수 있으므로, 지표가 임계값을 넘을 때마다 작은 폭으로 확장하는 방식에는 주의가 필요합니다.
지표 확인에서 변경 요청까지
이 회사의 agent 작업 도구는 정기 작업이나 경보를 계기로 agent를 실행합니다. 클러스터 용량을 점검하는 흐름은 다음과 같습니다.
- 관측 담당 agent가 Prometheus 지표에서 CPU 사용량, 남은 디스크 공간, 클러스터 상태를 확인합니다.
- 인프라 담당 agent가 Kubernetes 상태와 저장소의 설정 파일을 확인합니다.
- 두 정보를 합쳐 확장 필요성을 판단하고, 필요하면 설정 변경 요청을 작성합니다.
- 사람이 요청과 근거를 검토한 뒤 반영하면 ECK가 클러스터 상태를 조정합니다.
판단과 변경 요청은 별개입니다. 한 용량 점검에서는 남은 디스크 공간의 감소 추세를 확인했지만, agent는 디스크와 샤드 상태상 당장 확장이 필요하지 않다고 판단해 변경 요청을 만들지 않았습니다. 이후 저장 공간을 늘리라는 별도 지시에 따라 Elasticsearch 노드 3개의 요청 용량을 각각 500Gi에서 550Gi로 바꾸는 요청을 작성했습니다. 따라서 이 확장은 agent의 최초 권고가 아니라 명시적인 추가 지시에 따른 결과입니다.
장애 조사에도 같은 연결 방식이 쓰입니다. HTTP 500 오류율 경보를 받은 agent는 지표와 Elasticsearch 로그를 확인하고 애플리케이션 코드를 조사합니다. 한 사례에서는 간헐적으로 예외를 내도록 만든 FastAPI 코드가 원인이었고, agent가 수정 코드와 회귀 테스트를 작성해 GitHub 변경 요청으로 제출했습니다. 로그 검색에서 멈추지 않고 원인 확인, 수정, 검증으로 이어진 사례입니다.
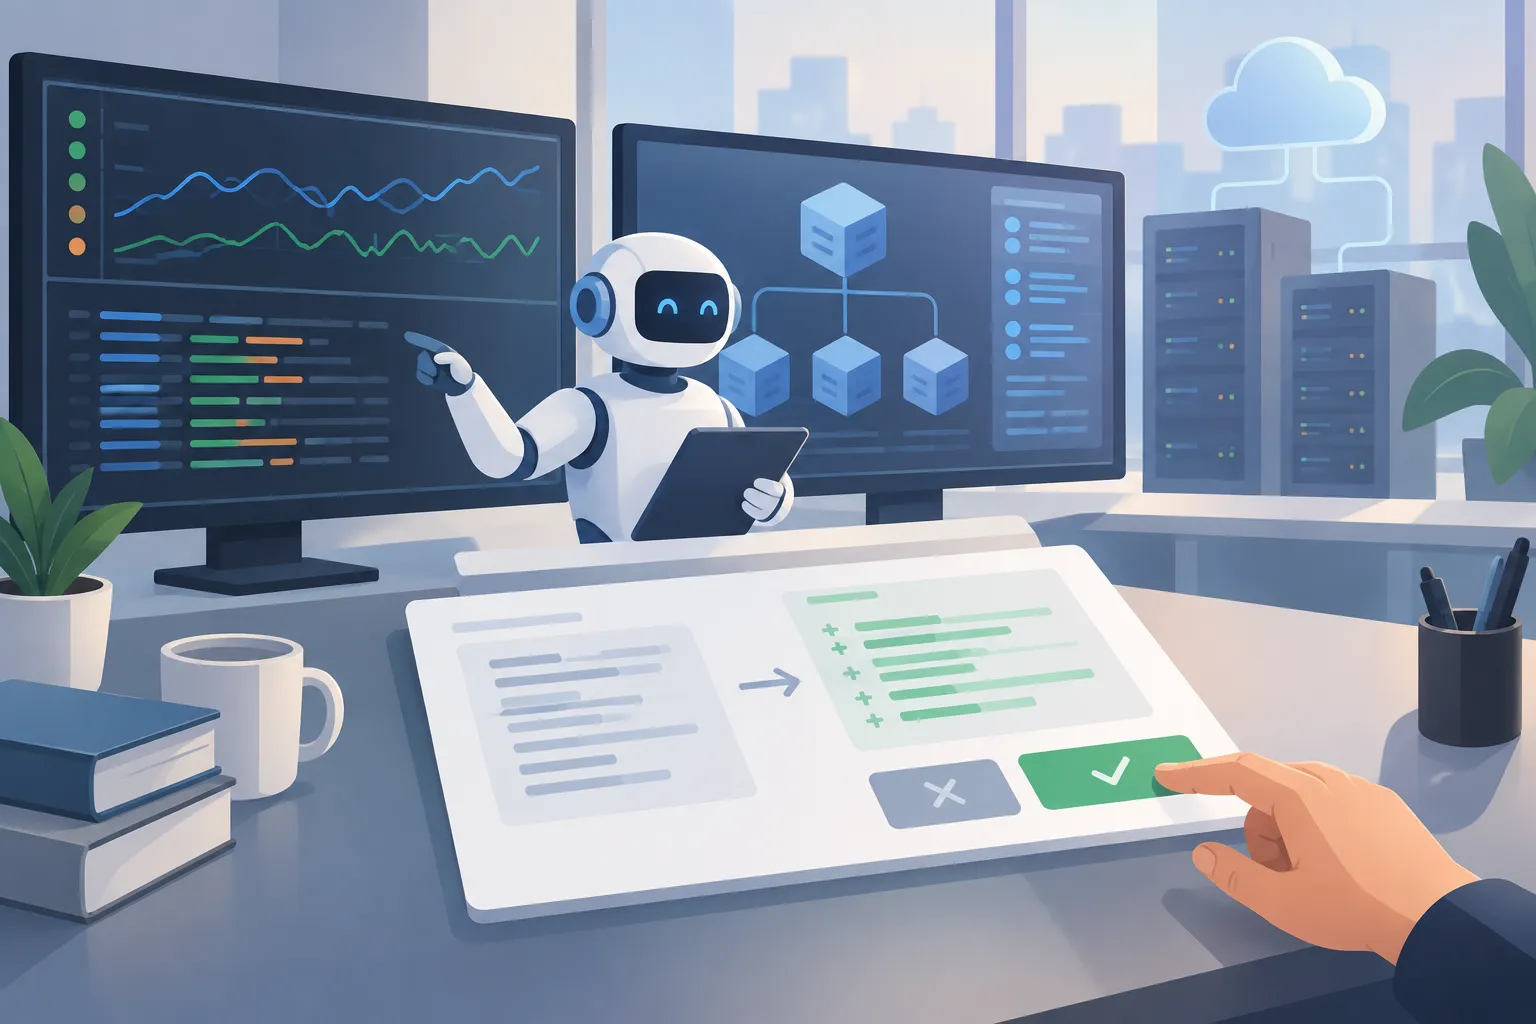
▲ 변경 요청과 사람의 검토
자동화의 끝에는 검토를 둡니다
이 흐름을 적용할 때는 agent가 어디서 실행되고 무엇을 할 수 있는지도 함께 정해야 합니다. 이 회사의 코딩 agent는 고객의 Kubernetes 클러스터 안에 격리된 실행 환경에서 작동합니다. 작업 권한은 요청한 사용자의 권한을 따르며, 클러스터 접근에는 역할 기반 권한 제어를 적용합니다. Open Policy Agent의 Rego 정책은 도구 호출을 허용하거나 거부하고, 필요하면 사람의 승인을 기다리게 할 수 있습니다.
운영자가 먼저 점검할 것은 로그와 지표의 연결, 인덱스 전환 규칙, 저장소에서 관리되는 클러스터 설정입니다. 그다음 읽기 중심의 정기 점검부터 시작해 agent가 사용한 근거를 확인하고, 쓰기 작업은 변경 요청과 사람의 승인으로 마무리하는 편이 적절합니다. 이 사례가 보여 주는 것은 무조건적인 자동 확장이 아니라, 관측 데이터에 근거한 판단을 검토 가능한 운영 변경으로 잇는 방법입니다.