Claude Code에 Jev를 더한다고 해서 모든 작업이 일괄적으로 빨라지는 것은 아닙니다. 살펴볼 대상은 여섯 개의 저장소와 하나의 활용 사례 디렉터리입니다. 각각 입력에 맞는 화면을 고르고, 브라우저를 조작하고, 웹페이지의 내용을 분류하는 등 서로 다른 일을 맡습니다. 따라서 ‘몇 배 빠른가’보다 기존 작업의 어느 판단을 맡길 수 있는가가 출발점입니다.
Jev는 답변보다 선택을 맡습니다
TypeSafe AI의 Jev는 문장을 한 단어씩 생성하는 대신, 정해진 선택지나 확률로 결과를 내놓는 모델입니다. 긴 글을 쓰거나 복잡한 계획을 세우는 역할보다는 ‘이 요소가 광고인가’, ‘어느 버튼을 눌러야 하는가’처럼 범위가 좁은 판단에 맞춰져 있습니다. Claude Code가 전체 작업을 계획하고 Jev가 반복적인 판단을 처리하는 식으로 역할을 나눌 수 있습니다.
아래의 속도 수치는 각 도구에서 제시된 작업 사례의 값입니다. 특정 작업의 측정치를 Claude Code와 결합한 모든 작업의 성능으로 받아들일 수는 없습니다.
입력과 음성에 즉시 반응하는 화면
Shapeshift: 입력 내용을 화면 구성요소로 바꾸기
Shapeshift는 일반 입력창에 들어오는 내용을 분류해 그에 맞는 화면 구성요소를 보여줍니다. 입력 의도를 14가지 유형의 질문으로 병렬 평가하며, 일정에 관한 문장은 편집 가능한 일정 카드로, ‘25분 타이머’는 작동하는 타이머로 바뀝니다. 계산식을 넣으면 결과를 담은 계산 카드가 나타납니다.
활용 장면은 사용자가 명령 형식을 외우지 않아도 되는 입력창입니다. 다만 여기서 확인할 일은 단순히 화면이 빨리 바뀌는지가 아니라, 모호한 입력을 의도에 맞게 분류하는지입니다.
Jev Voice Browser: 말을 들으며 브라우저 움직이기
Jev Voice Browser는 발화가 끝나기를 기다리지 않고 이어서 들어오는 음성에서 의도를 판단합니다. 단어당 약 250~350밀리초 안에 판단하고 브라우저 동작을 시작하는 방식입니다. 페이지로 이동하거나 링크를 선택하는 음성 명령을 연속해서 처리하는 데 쓰입니다.
음성으로 웹을 탐색하는 작업이라면, 사용자가 말을 마친 뒤 긴 답변을 생성하는 방식보다 명령을 짧게 판별하는 방식이 어울릴 수 있습니다. 실제 적용에서는 발화 중간에 의도가 바뀌는 상황도 함께 살펴봐야 합니다.
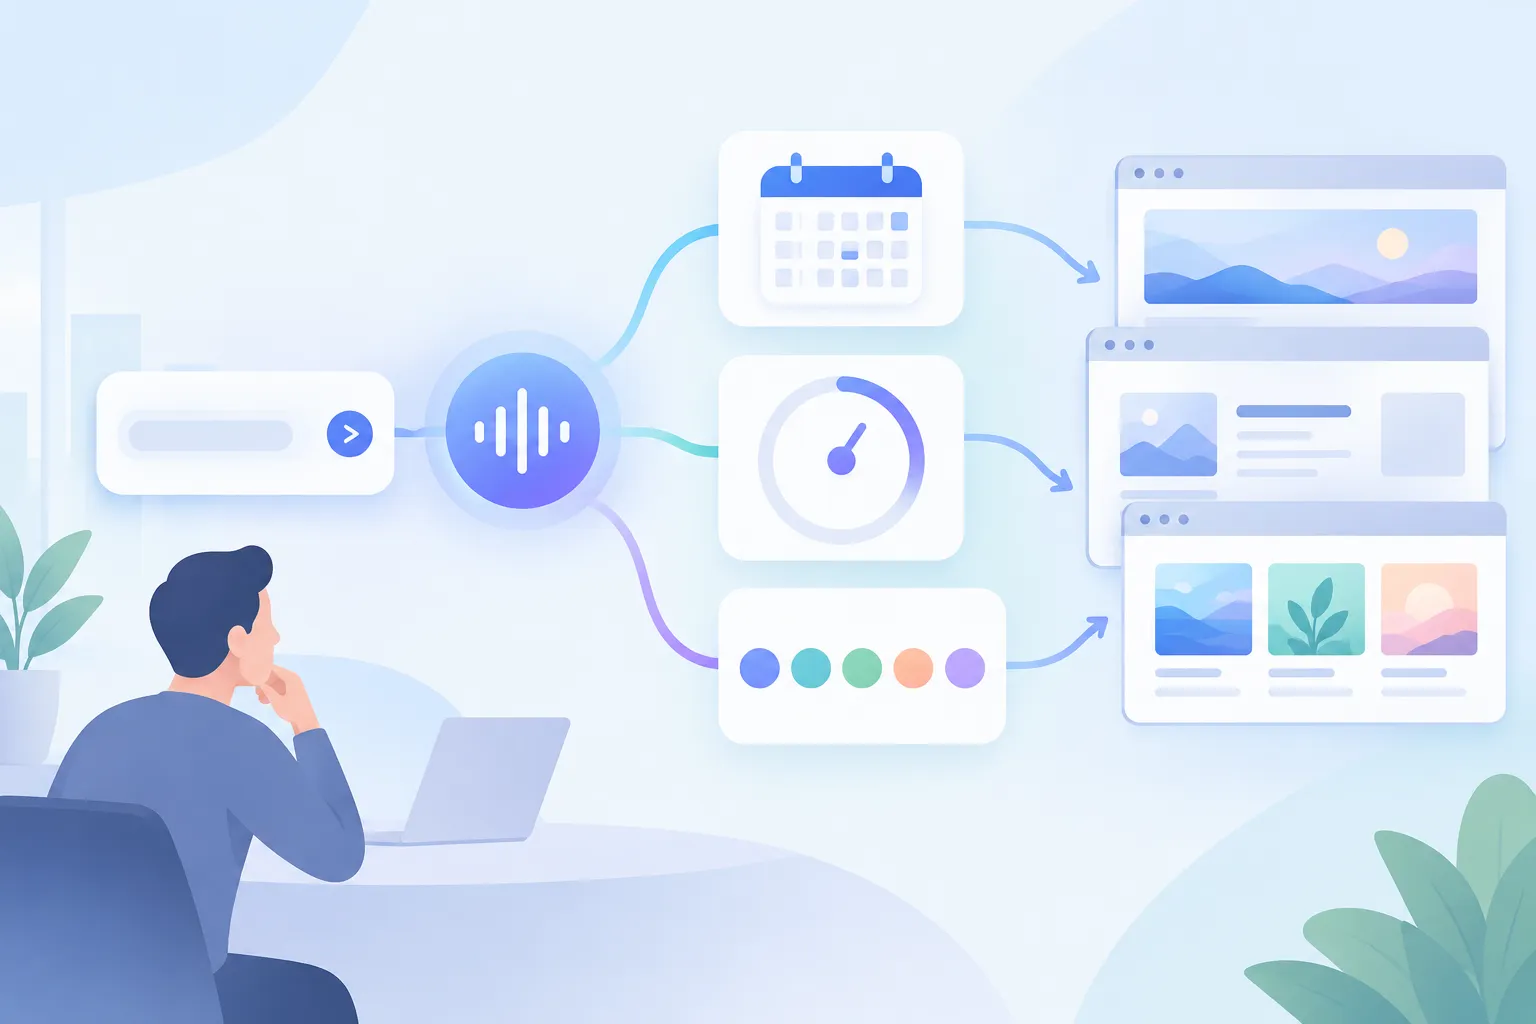
▲ 입력과 음성에 맞춘 화면
화면을 찾고 웹페이지 요소를 분류하기
TypeSafe Computer Use: 누를 위치 고르기
TypeSafe Computer Use는 전체 화면을 매번 해석하는 대신 OCR(이미지 속 글자 인식)과 DOM(웹페이지 요소의 구조)에서 얻은 정보를 이용해 클릭 대상을 고릅니다. 티켓 구매 페이지에서 선택지를 찾고 다음 화면으로 이동하는 작업이 한 예입니다.
제시된 비교에서는 한 단계의 판단 시간이 다음과 같았습니다. 이는 해당 방식과 작업에서 나온 비교값입니다.
| 판단 방식 | 한 단계에 걸린 시간 |
|---|---|
| TypeSafe Computer Use | 0.13~0.38초 |
| 화면 전체를 해석하는 Claude Opus 5 방식 | 약 5.2~5.5초 |
이 도구가 맡는 것은 구매 여부 같은 상위 판단이 아니라, 이미 정한 작업을 진행하기 위해 화면에서 대상을 찾는 기계적인 단계입니다.
TypeSafe Fun AdBlocker: 광고로 분류한 요소 제거하기
TypeSafe Fun AdBlocker는 웹페이지의 DOM 요소를 읽고 광고일 확률이 높은 부분을 제거하는 실험적 확장 기능입니다. 미리 정한 규칙에 따라 차단하는 방식과 달리, 현재 나타난 개별 요소를 분류한다는 점을 보여줍니다.
다만 기존의 규칙 기반 광고 차단기가 현재는 더 효율적입니다. 당장 광고 차단기를 교체할 도구라기보다, 페이지가 만들어지는 동안 요소별 판단을 적용하는 사례로 보는 편이 적절합니다.
Claude Code 안에서 검증을 나누기
Jev MCP: 외부 내용을 읽기 전에 확인하기
Jev MCP는 MCP(모델과 외부 도구를 연결하는 규격)를 통해 Jev의 판단 기능을 Claude Code에 연결합니다. 확인, 분류, 추출 등 11가지 도구를 제공하므로 Claude Code가 모든 작은 판단을 직접 처리하지 않아도 됩니다.
가격 안내 페이지를 다루는 사례에서는 외부 내용에 숨은 prompt injection(AI의 동작을 바꾸려는 지시)을 먼저 살피고, 추출한 페이지 내용에 비춰 네 가지 가격 주장을 확인했습니다. 숨은 지시를 탐지한 결과에는 0.99의 확률이 제시됐습니다. 이때 ‘확인’은 추출된 페이지 내용과 주장이 맞는지 대조하는 작업이지, 페이지 밖의 사실까지 독립적으로 입증한다는 뜻은 아닙니다.
Claude Code로 외부 웹페이지를 읽고 정보를 정리한다면, 내용을 다음 단계에 넘기기 전에 의심스러운 지시를 거르고 필요한 항목을 추출·대조하는 작업에 연결할 수 있습니다.
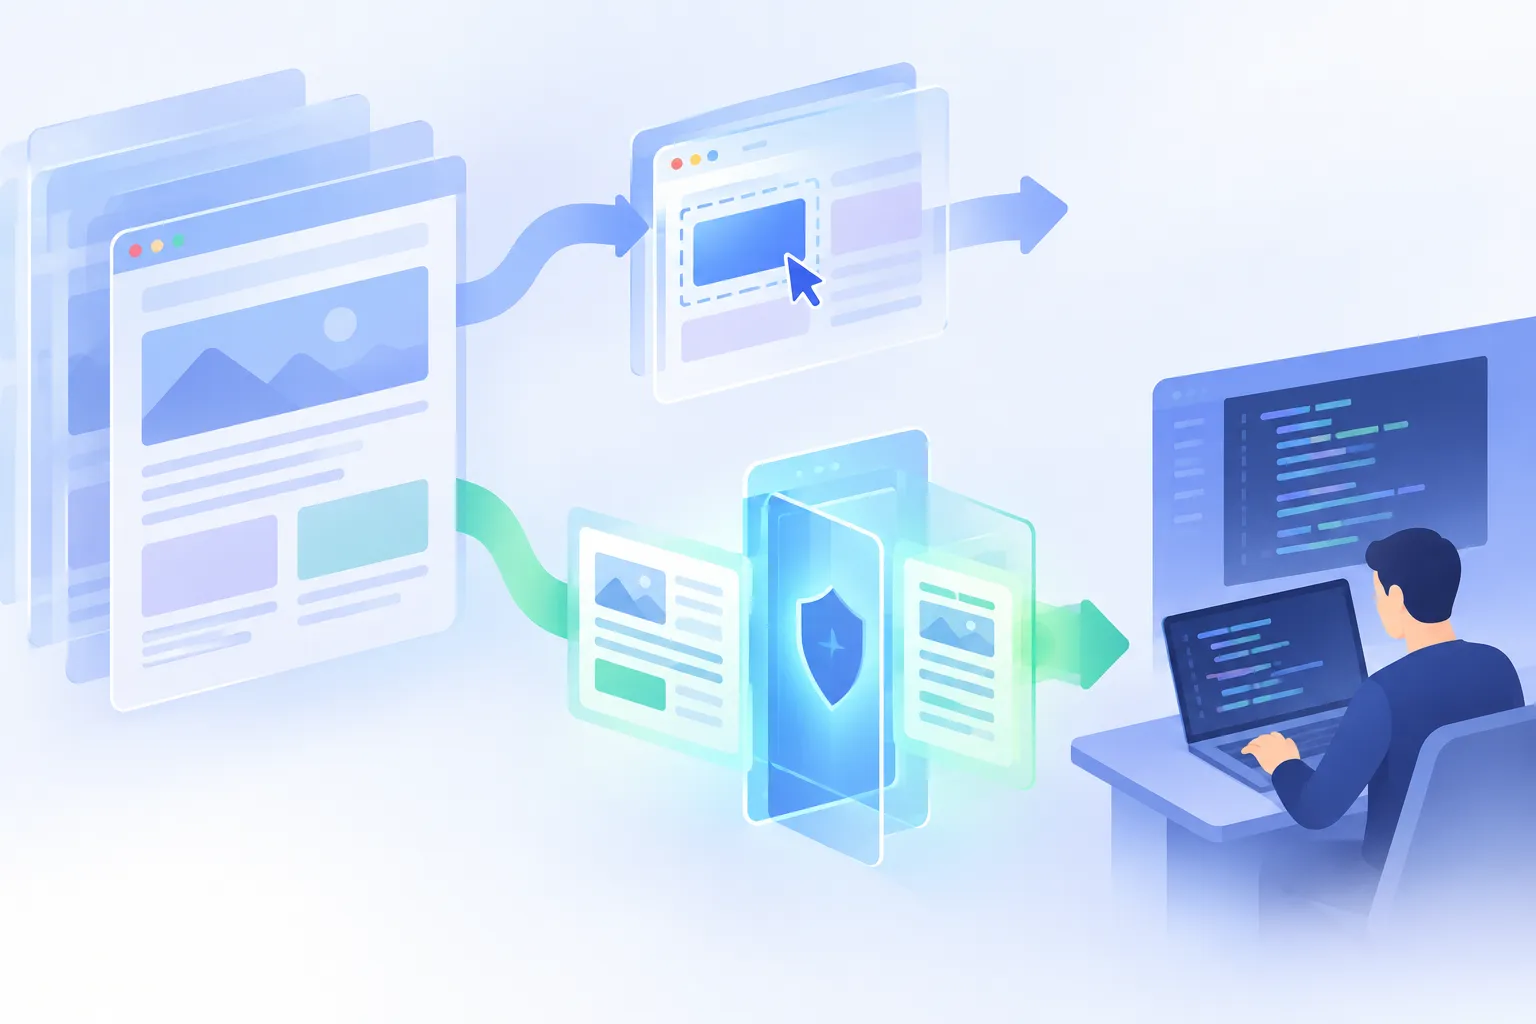
▲ 화면 선택과 내용 검증
발언을 문장별로 평가하기
Jevmeter: 이어지는 음성에 분류 점수 붙이기
Jevmeter는 음성을 글로 옮긴 뒤 각 문장을 Jev에 보내 평가합니다. 사실 주장, 회피, 자기모순, 감정 호소, 질문 비켜가기 등 다섯 기준의 결과를 실시간으로 표시합니다. 토론을 분석한 사례에서는 1,191번의 Jev 호출이 이뤄졌고, 호출당 응답 시간의 중앙값은 0.4초였습니다.
이 기능은 진행 중인 발언에서 특정 유형의 표현이 언제 나타나는지 살펴보는 데 활용할 수 있습니다. 표시되는 값은 설정된 기준에 따른 분류 결과이므로, 한 사람의 발언이 참인지 거짓인지 최종 판정한 결과로 읽어서는 안 됩니다.
일곱 번째 자료에서 출발해 한 작업에 연결하기
마지막 자료는 저장소가 아니라 Jev 활용 사례를 모은 디렉터리입니다. agent(스스로 작업 단계를 이어 가는 AI 프로그램)와 브라우저, 실시간 시스템, 콘텐츠, 도구 등 여러 분야의 사례 551개가 정리돼 있습니다. 무엇을 새로 만들지 정하기 전에, 이미 쓰는 작업과 비슷한 사례를 찾는 용도에 가깝습니다.
시작할 때는 한 번에 모든 도구를 붙이기보다 다음 순서로 범위를 좁히는 편이 좋습니다.
- 기존 Claude Code 작업에서 반복되는 판단 하나를 고릅니다. 웹페이지 항목 추출, 클릭 대상 선택, 입력 의도 분류처럼 결과를 확인할 수 있는 일이 적합합니다.
- 그 판단에 해당하는 저장소를 살펴보고, Claude Code가 맡을 계획·종합 단계와 Jev가 맡을 분류 단계를 구분합니다.
- 작은 작업에서 결과가 의도에 맞는지 확인한 뒤 적용 범위를 늘립니다. 빠른 응답 자체보다 잘못 분류했을 때 다음 단계에 어떤 영향이 생기는지를 먼저 확인해야 합니다.
여섯 저장소가 공유하는 방향은 Claude Code를 대체하는 것이 아닙니다. 넓게 생각하는 단계와 좁고 반복적인 선택을 분리하는 것이 Jev를 함께 쓰는 핵심입니다.