AI로 반복 업무를 자동화할 때 비용을 밀어 올리는 범인은 대개 큰 모델이 아니라 작은 판단입니다. 메일 한 통이 뜨거운 리드인지, 댓글이 스팸인지, 이 요청에 어떤 모델을 붙일지는 답을 새로 쓰는 일이 아니라 골라내는 일입니다. 이 글에서는 골라내기만 전담하는 판단 모델 Jev를 앞단에 세워, 고성능 모델이 답을 쓰는 데만 힘을 쓰게 하는 구조를 실제 테스트의 비용·시간 수치와 함께 살펴봅니다.
판단만 하도록 좁힌 모델
한 AI 스타트업이 내놓은 Jev는 흔히 말하는 생성 모델이 아닙니다. 문장을 쓰지 않고 코드도 쓰지 않습니다. 출력은 세 가지로만 제한됩니다. 예 또는 아니오로 답하기, 사용자가 준 목록에서 하나 고르기, 2단계에서 10단계 사이의 사다리에서 점수 매기기입니다. OpenAI나 Anthropic의 모델 옆에 붙어, 무거운 모델이 하던 즉석 판단을 대신 맡습니다.
특징은 모든 답에 신뢰도 퍼센트가 함께 온다는 점입니다. 분노가 섞인 메일을 받으면 Jev는 밀리초 안에 부정 감정 여부와 99퍼센트라는 신뢰도를 돌려줍니다. 이 메일을 정중한 문장으로 다시 쓰는 일은 Claude 같은 생성 모델로 넘어갑니다. 인지심리학에서 말하는 빠른 판단과 느린 사고의 구분을 모델 구성으로 옮겨 놓은 셈입니다. 신뢰도가 낮게 나온 건만 상위 모델로 올리는 식으로 파이프라인을 짤 수 있습니다.
잘하는 일과 맡기면 안 되는 일
Jev가 잘하는 일은 세 가지입니다. prompt(모델에 주는 지시문)에 가장 저렴한 모델을 골라 주는 일, 수십에서 수백 개로 늘어난 스킬과 도구 목록에서 맞는 것을 집어 주는 일, 티켓이나 리드처럼 쌓여 있는 데이터를 대량으로 분류하는 일입니다. 도구 목록이 커질수록 라우팅을 Jev에 맡기는 편이 context window(모델이 한 번에 참고할 수 있는 입력 범위) 낭비를 줄입니다.
반대로 맡기면 안 되는 일도 분명합니다.
- 텍스트 작성과 코드 생성
- 수학 계산과 날짜 비교
- 다른 모델이 낸 답의 품질 평가
- 요약과 압축
- 금융 이체처럼 자율 실행이 따르는 거래
품질 평가를 맡길 수 없는 이유는 여러 단계를 이어 가는 추론 능력을 갖고 있지 않기 때문입니다.
가격은 입력에만, 출력은 $0
2026년 9월 기준 Jev의 가격은 입력 100만 token(모델이 텍스트를 처리하는 단위)당 $0.042이고, 출력 token에는 비용이 붙지 않습니다. 라우팅 한 번에 드는 비용은 약 0.002센트, 달러로는 $0.00002 수준입니다. 판단 한 건당 비용은 상위 추론 모델을 쓸 때보다 40배에서 1,000배 이상 낮은 것으로 제시됩니다.
주의할 점은 프라이버시입니다. 개발사는 기본 등급 계정에서 SOC 2, ISO, GDPR을 준수하지 않습니다. 데이터를 보관하지 않는 정책도 기업용 계정에만 적용됩니다. 고객 이름, 금융 기록, 자격 증명처럼 민감한 값은 기본 등급으로 보내지 않는 편이 안전합니다.
메일 100통 분류에서 드러난 차이
가장 눈에 띄는 시험은 리드 메일 100통을 뜨거움, 따뜻함, 차가움, 리드 아님으로 나누는 작업입니다. 같은 문제를 세 모델에 던진 결과는 다음과 같습니다.
| 모델 | 처리 시간 | 비용 | Jev와 같은 분류 |
|---|---|---|---|
| Jev | 23.00초 | $0.00196 | 기준 |
| Claude Haiku 4.5 | 74.65초 | $0.01959 | - |
| Claude Fable 5.1 | 218.05초 | $0.14811 | 100개 중 89개 |
Jev는 23초에 $0.002를 조금 밑도는 값으로 끝냈고, Claude Fable 5.1은 218초에 $0.148를 썼습니다. 표의 수치로 계산하면 비용 차이는 약 76배입니다. 그런데 두 모델이 같은 결론을 낸 메일은 100개 중 89개였습니다. 판단 전용 초저가 모델이 받은 편지함 정리와 리드 분류를 사실상 대신할 수 있다는 근거로 제시되는 대목입니다.
▲ 처리 시간과 비용의 격차
코드 라우팅과 다른 대량 판단
같은 성격의 시험이 여러 개 이어집니다.
- 코드 prompt 12개를 Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5, Claude Fable 5.1에 나눠 보내는 라우팅에서는 12개 중 10개를 최상위 모델로 보내지 않았습니다. 전체 비용은 $1.380에서 $0.506로 줄었습니다. 다만 최적 등급을 고른 정확도는 약 80퍼센트였고, 두 번은 Opus가 나은 상황에서 Haiku를 골랐습니다.
- 가짜 인보이스 탐지, 스팸 신고, 커뮤니티 규칙 위반 확인, 환불 자격 판정, 이탈 예측까지 다섯 가지 예·아니오 검사를 30건씩, 모두 150건 처리했습니다. 판단 1건당 지연 시간 중앙값은 219밀리초였고, 150건 전체 비용은 $0.0019였습니다.
- 이미지 파일 60개를 두고 사람 얼굴이 있는 사진, 무언가를 팔려는 사진, 웹 페이지 스크린샷 같은 자연어 질의를 던진 시험에서는 파일명 부분 검색이 4건을 찾아낸 반면 Jev는 50건을 골라냈습니다. 6.6초에 $0.00320가 들었습니다. 다만 픽셀을 읽는 것이 아니라 파일 경로와 메타데이터 텍스트를 해석하는 방식이어서, 이름이 불친절한 파일에서는 힘을 쓰지 못합니다.
- 댓글 312개에 일곱 가지 질문을 함께 던져 2,184개의 판단을 만드는 작업은 72.5초, $0.0106로 끝났습니다. 같은 일을 Claude Fable 5.1로 하면 $3.48가 들 것으로 추산됩니다. 답변이 필요한 댓글 155개, 영상 아이디어 28개, 구매 의향 97개, 스팸 5개가 걸러졌고, 분류 일치율은 90에서 96퍼센트, 스팸 판정 일치율은 98에서 100퍼센트였습니다.
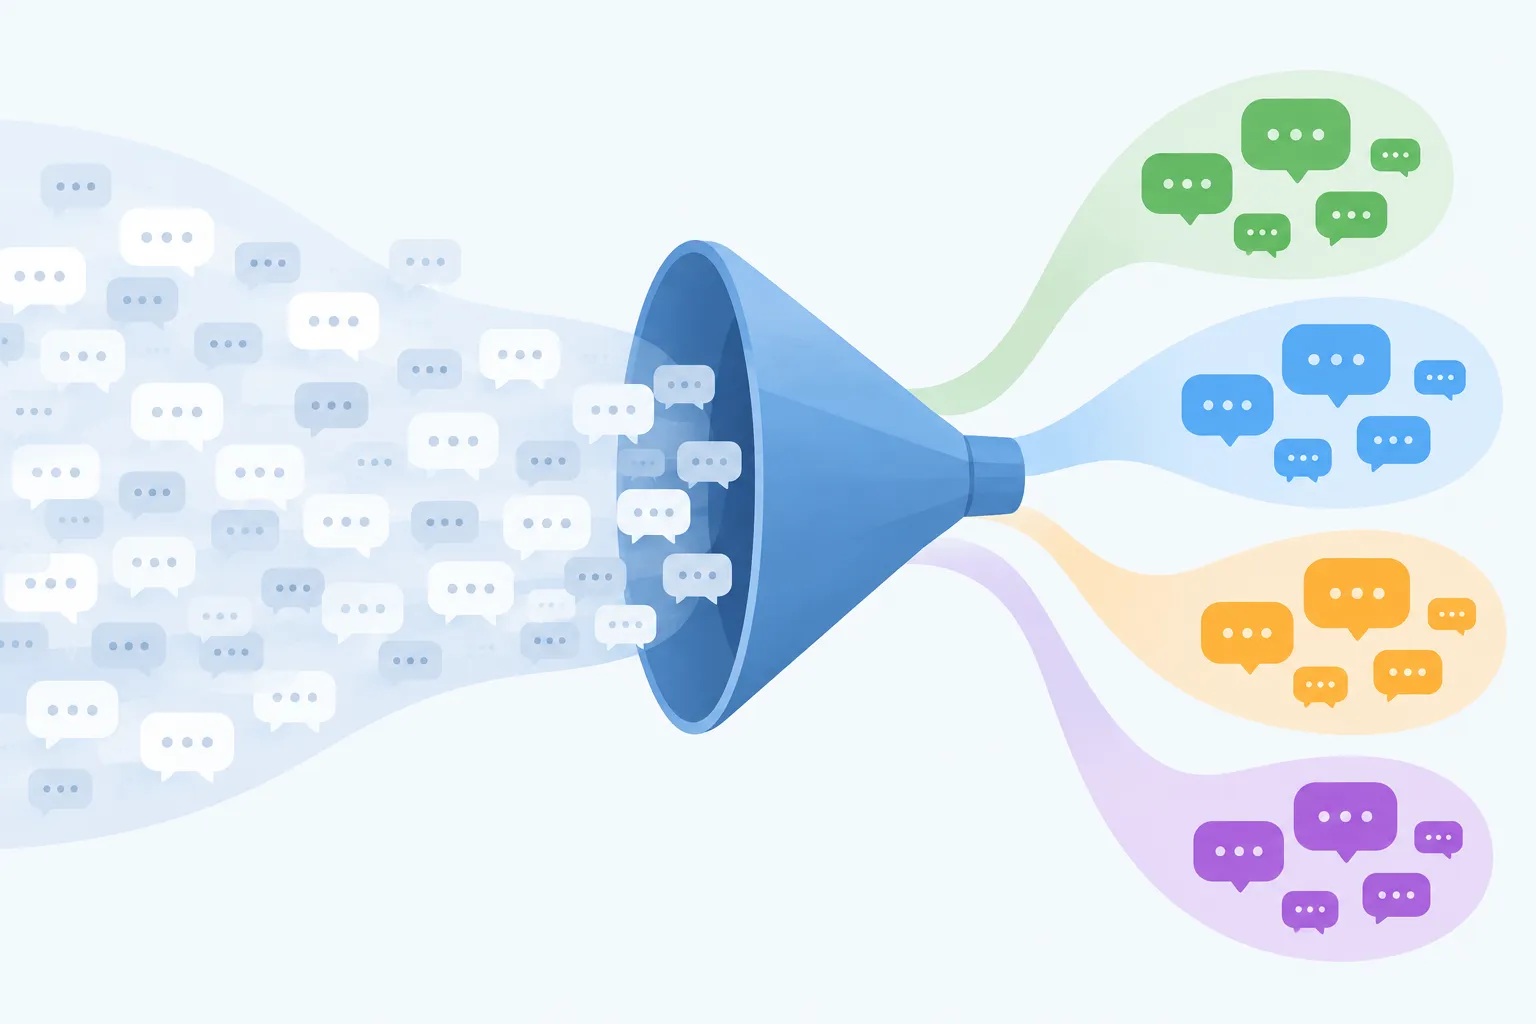
▲ 다중 문항 분류 흐름
붙이는 방법과 운영
개발사는 대기자 명단을 없애 바로 가입할 수 있게 했고, OpenRouter에서도 Jev Latest, Jev 1.13 같은 이름으로 쓸 수 있습니다. 설치는 API 키 발급, 자체 테스트 실행, settings.json에 hook(특정 시점에 자동 실행되도록 연결하는 설정) 연결, 환경 재시작의 네 단계입니다. Claude Code 안에서는 /jev on, /jev off, /jev status 세 명령으로 켜고 끄고 상태를 봅니다. /jev on을 실행하면 요청이 Claude에 닿기 전에 prompt 크기 판단과 모델 라우팅이 자동으로 돌아가고, 한 번에 약 $0.00002가 붙습니다. /jev status는 prompt 분류, 버킷 크기, 밀리초 단위 지연, 신뢰도, 누적 비용을 표로 보여줍니다.
자동화 스크립트에서는 신뢰도 임계값을 두는 구성이 권장됩니다. 스킬 라우팅 패키지에서는 신뢰도가 60퍼센트 아래로 내려가면 Jev가 결정하지 않고 작업을 Claude로 넘깁니다. 월 청구 한도에 가까워졌을 때 API 소비를 조절하는 용도로도 씁니다. 다만 금융 이체처럼 자율 실행이 따르는 거래는 맡기지 않는다는 경계는 그대로 적용됩니다.
한계와 남은 검증
속도와 비용은 실제 호출을 다시 돌려 확인된 수치입니다. 반면 절대적인 정확도는 외부 정답지와 대조한 검증을 거치지 않았습니다. 코드 라우팅 시험에서 필요 이상으로 작은 모델을 고른 사례가 약 20퍼센트 있었던 것도 같은 맥락입니다. 파일 이름이 불친절하면 이미지 검색에서 힘을 쓰지 못하는 제약도 있습니다. 도메인마다 별도의 검증을 붙여야 한다는 뜻입니다.
판단은 싸게, 작성은 제대로
Jev가 보여주는 구조는 단순합니다. 값싼 판단을 앞단에 두고, 비싼 생성은 뒤로 미루는 것입니다. 예·아니오, 목록 선택, 점수 매기기로 정리되는 작업이 생각보다 많다는 점이 이 구조의 출발점이라고 볼 수 있습니다.
독자가 지금 해볼 일은 분명합니다. 자동화 파이프라인에서 반복되는 분류·선택·점수 작업을 먼저 목록으로 뽑아냅니다. 그중 프라이버시 부담이 없는 것부터 판단 전용 모델로 옮기고, 신뢰도 임계값을 정해 낮은 건만 상위 모델로 넘깁니다. 도입 전에는 자체 테스트로 지연과 비용을 직접 확인하고, 운영 중에는 상태 명령으로 분류 결과와 누적 비용을 계속 지켜봅니다. 속도와 비용은 측정값이지만 정확도는 검증 대상이라는 점을 잊지 않아야 합니다.