Claude Code의 대화 기록은 지나간 작업을 찾아보는 용도에 그치지 않습니다. 코딩 agent(도구를 이용해 코딩 작업을 수행하는 AI)가 어떤 prompt(모델에 입력한 지시)를 받았고, 어떤 도구를 호출했으며, 어디서 실패했는지가 남아 있습니다. 이 기록을 살피는 방법은 두 가지입니다. 적은 양을 빠르게 훑어 개선점을 찾거나, 기록을 구조화해 반복되는 오류를 집계하는 것입니다. 어느 쪽이든 분석 결과를 실제 작업 규칙으로 바꿔야 다음 작업에 도움이 됩니다.
첫 번째 경로: 로컬 기록을 바로 점검합니다
Claude Code는 세션 기록을 로컬 JSONL(한 줄에 하나의 JSON 기록을 담는 형식) 파일로 저장합니다. 여기에는 사용자 지시뿐 아니라 도구 호출, 출력, 오류, 사고 과정 등이 담깁니다. 기본 설정에서는 기록이 30일 뒤 정리되므로, 장기간의 변화를 보려면 그전에 보존할 필요가 있습니다.
가장 간단한 출발점은 Claude Code에 기록 위치를 확인하게 하고, 분석 기능으로 JSONL 파일에서 반복되는 실패를 추리는 것입니다. 처음부터 전체 대화를 요약하기보다 오류 유형과 빈도, token(모델이 처리하는 텍스트 단위) 사용량이 큰 세션 등 점검 대상을 좁혀 상위 개선점만 요청하는 편이 유용합니다. 의심스러운 항목이 나오면 해당 오류가 발생한 작업을 다시 확인하고, 규칙을 어떻게 바꿀지 묻습니다.
3,967개 기록을 대상으로 한 빠른 점검에서는 PowerShell 호출 343회 중 337회가 입력을 기다릴 수 없는 실행 환경에서 권한 확인에 막힌 것으로 나타났습니다. agent 관련 실패 236건 중 225건은 하위 agent가 다른 agent를 반복 호출하면서 동시 실행 한도에 걸린 경우였습니다. 이런 수치는 막연히 ‘코딩이 잘 안 된다’고 평가하는 대신, 먼저 손볼 실행 방식과 위임 규칙을 가리킵니다.
▲ 로컬 기록 점검
다만 원본 파일을 agent에 계속 읽히는 방식은 기록이 커질수록 부담이 됩니다. 한 번의 분석에 수십만 token이 들 수 있고, 비용을 줄이려고 일부만 읽으면 드물지만 반복되는 오류를 놓칠 수 있습니다. 로컬 점검은 빠른 첫 조사에 적합하지만, 여러 프로젝트의 변화를 꾸준히 비교할 때는 구조화가 필요합니다.
두 번째 경로: 기록을 보존하고 오류를 집계합니다
기록이 많다면 파일을 보관하는 단계와 질문에 답할 데이터를 만드는 단계를 나누는 편이 좋습니다. 다음은 Databricks를 이용해 구성한 흐름입니다.
- 삭제되기 전 JSONL 기록을 모아 Unity Catalog의 Volume에 보관합니다. 클라우드로 옮기기 전에는 API 키, 세션 비밀값, 민감한 회사 정보나 코드가 섞여 있지 않은지 확인하고 필요한 부분을 제거합니다. 서비스의 데이터 보호 조건도 확인해야 합니다.
- Genie Code와 Apache Spark(대량 데이터를 처리하는 도구)로 중첩된 기록을 읽고, 세션·대화 차례·도구 호출을 각각 Delta Lake 테이블로 정리합니다. 오류 종류, 도구 이름, 실행 시간처럼 비교할 항목을 분리하면 원본을 매번 통째로 읽지 않아도 됩니다.
- Databricks CLI(명령줄 도구)로 Claude Code와 Databricks의 MCP(모델과 외부 도구를 연결하는 표준) 서버를 연결합니다. 이후 Databricks Genie에 오류 유형별 건수를 묻고 SQL(데이터베이스에서 조건에 맞는 자료를 조회하는 언어) 집계 결과를 받아볼 수 있습니다.
이 구성에서는 대용량 기록 파일 62개에서 396,404개 항목을 읽어 2,241개 세션을 식별했습니다. 이렇게 정리한 테이블 덕분에 agent가 원본 기록 텍스트를 직접 읽지 않고도 SQL로 오류를 집계할 수 있습니다. 구조화된 기록에서 집계한 도구 호출 오류는 모두 3,450건이었고, 상위 유형은 다음과 같습니다.
| 오류 유형 | 건수 | 점검할 부분 |
|---|---|---|
| exit_code | 946건 | 명령 실행 방식과 종료 상태 |
| hook_block | 506건 | 사전 검사에 막힌 이유 |
| path_not_found | 500건 | 실제 경로 확인 없이 파일을 찾은 경우 |
이 표는 어느 항목을 먼저 조사할지 정하는 출발점입니다. 예를 들어 사전 검사에 막힌 횟수가 많다고 해서 보안 설정을 바로 해제할 이유는 없습니다. 차단된 내용과 규칙을 먼저 살펴야 합니다.
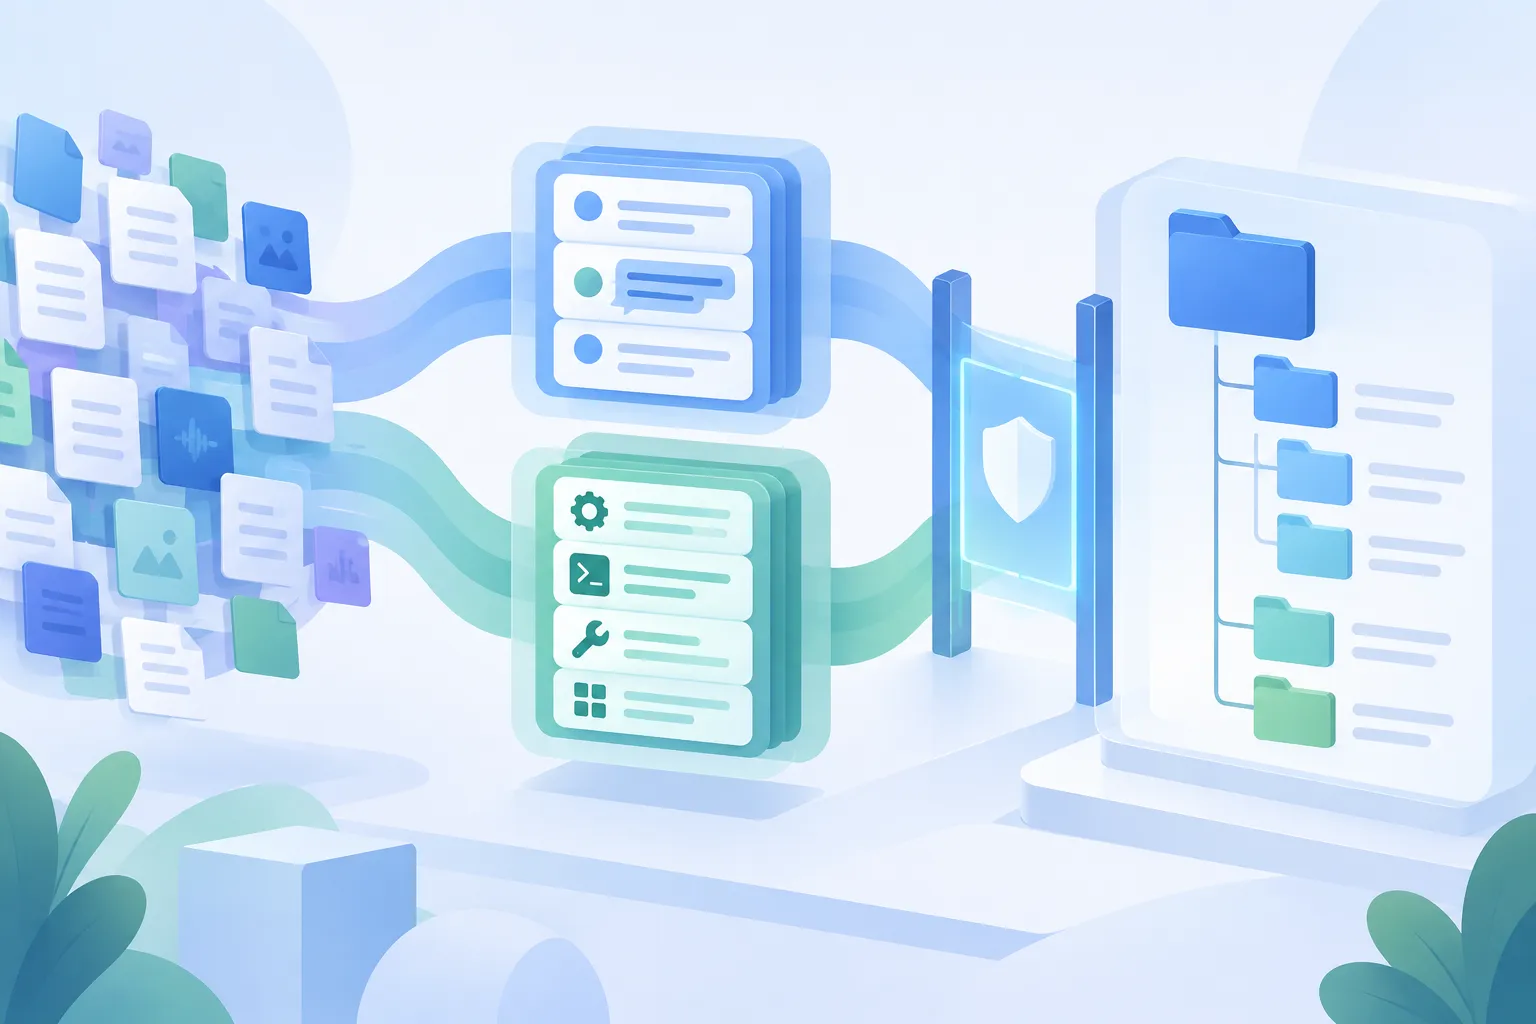
▲ 분석 결과의 규칙 반영
기록을 다음 작업의 규칙으로 바꿉니다
집계만으로는 agent의 습관이 달라지지 않습니다. 경로를 추측해 생긴 실패에는 파일을 수정하기 전 glob(이름 패턴으로 파일을 찾는 방법)이나 ls로 실제 위치를 확인하도록 CLAUDE.md에 규칙을 둘 수 있습니다. 여러 줄이거나 따옴표가 복잡한 명령에서 오류가 반복된다면, 명령을 한 줄로 전달하는 대신 임시 스크립트 파일에 작성하도록 지시할 수 있습니다.
설정도 같은 기준으로 손봅니다. settings.json에서 필요한 권한을 검토하고, 하위 agent의 동시 작업 수를 제한할 수 있습니다. 세션 시작 시 실행되는 hook(정해진 시점에 작업을 자동 실행하는 설정)으로 저장소 폴더 구조를 두 단계 깊이까지 전달한 구성도 있습니다. agent가 편집을 시작하기 전에 실제 디렉터리를 파악하도록 돕기 위한 조치입니다.
우선 자신의 기록에서 반복되는 오류 한 종류를 고르고, 관련 호출을 확인한 뒤, 이를 막을 규칙이나 시작 설정 하나를 바꾸는 것이 좋습니다. 다음 기록에서 같은 오류가 줄었는지 다시 비교하면 변경의 효과를 점검할 수 있습니다. 기록을 외부에 저장하기로 했다면 이 순서에 민감 정보 확인과 제거를 반드시 포함해야 합니다.