Apple은 M5 Ultra가 M3 Ultra보다 최대 4배 빠르다고 내세웁니다. 인터넷 연결 없이 로컬 모델만으로 두 Mac Studio를 나란히 돌려 본 결과, 이 수치는 절반만 맞는 이야기로 보입니다. 긴 prompt를 읽어 들이고 첫 단어를 내놓기까지의 시간은 모델에 따라 2.4~4.1배 줄었습니다. 반면 답변을 한 글자씩 써 내려가는 token 생성 속도는 1.5~1.7배 빨라지는 데 그쳤습니다. 두 숫자가 왜 다른지 이해하면, 내 작업에 M5 Ultra가 어느 정도의 체감 차이를 줄지 가늠할 수 있습니다.
비교 조건: 무엇이 달라졌나
두 기기는 모니터나 키보드 없이 서버 랙에 넣어 로컬 AI 서버로만 사용했습니다. 모든 테스트는 오프라인에서 진행했고, OpenAI나 Anthropic 같은 클라우드 API는 쓰지 않았습니다.
| 항목 | M3 Ultra | M5 Ultra |
|---|---|---|
| CPU 코어 | 32개 (성능 24, 효율 8) | 36개 (슈퍼 12, 성능 24) |
| GPU 코어 | 80개 | 80개 (코어마다 뉴럴 가속기 내장) |
| 메모리 대역폭 | 819GB/s | 1.2TB/s |
| 테스트 기기 메모리 | 512GB | 256GB |
| 운영체제 | macOS Tahoe 26.5.1 | macOS Golden Gate 27.0 |
눈여겨볼 변화는 두 가지입니다. 첫째, GPU 코어 수는 80개로 같지만 M5 Ultra는 각 GPU 코어 안에 뉴럴 가속기(행렬 연산을 전담하는 AI 연산 유닛)가 들어 있습니다. 둘째, 메모리 대역폭(메모리에서 데이터를 읽어 오는 속도)이 약 50% 늘었습니다. 뒤에서 보겠지만 이 두 변화가 각각 다른 성능 지표를 끌어올립니다. 참고로 테스트에 쓴 M5 Ultra는 256GB, M3 Ultra는 512GB 구성이어서 메모리 용량은 오히려 구형이 더 큽니다.
첫 token까지의 시간: 4배는 여기서 나옵니다
첫 비교는 존 스튜어트 밀의 에세이 ’자유론’을 3만 2천 token 분량의 prompt로 넣고 요약을 시키는 작업이었습니다. 모델은 Qwen3.8 27B 4비트 양자화(가중치를 4비트로 압축해 용량을 줄인 형태) 버전입니다. 이어서 크기와 구조가 다른 여러 모델로 같은 방식의 비교를 반복했습니다.
TTFT(Time To First Token)는 prompt를 모두 처리하고 첫 token을 내놓기까지 걸린 시간입니다.
| 모델 | TTFT (M5 / M3) | TTFT 배율 | 생성 속도 (M5 / M3) | 생성 배율 |
|---|---|---|---|---|
| Qwen3.8 27B 4비트 | 21.66초 / 82.85초 | 3.8배 | 43.3 / 28.1 tok/s | 1.5배 |
| Qwen3 14B 4비트 | 14.43초 / 57.25초 | 4.0배 | 55.8 / 32.6 tok/s | 1.7배 |
| Gemma 4 31B 16비트 | 26.7초 / 110.4초 | 4.1배 | 13.6 / 9.0 tok/s | 1.5배 |
| Qwen3.5 122B-A10B 4비트 | 14.58초 / 46.9초 | 3.2배 | 65.8 / 43.1 tok/s | 1.5배 |
| Qwen3.6 35B-A3B 4비트 | 7.25초 / 17.5초 | 2.4배 | 110.2 / 73.5 tok/s | 1.5배 |
표에서 두 가지 패턴이 분명하게 드러납니다. prompt 처리 속도는 모델에 따라 2.4~4.1배로 폭이 크고, 조밀한 모델일수록 Apple이 말한 4배에 가깝습니다. 반면 token 생성 속도는 모델과 상관없이 거의 1.5배로 일정합니다. 전체 소요 시간으로 보면 Qwen3 14B는 21.6초 대 67.9초로 3.1배, Qwen3.5 122B-A10B는 18.1초 대 48.5초로 2.7배 차이가 났습니다. 긴 prompt일수록 첫 token을 기다리는 시간이 전체에서 차지하는 비중이 커지므로 체감 차이도 커집니다.
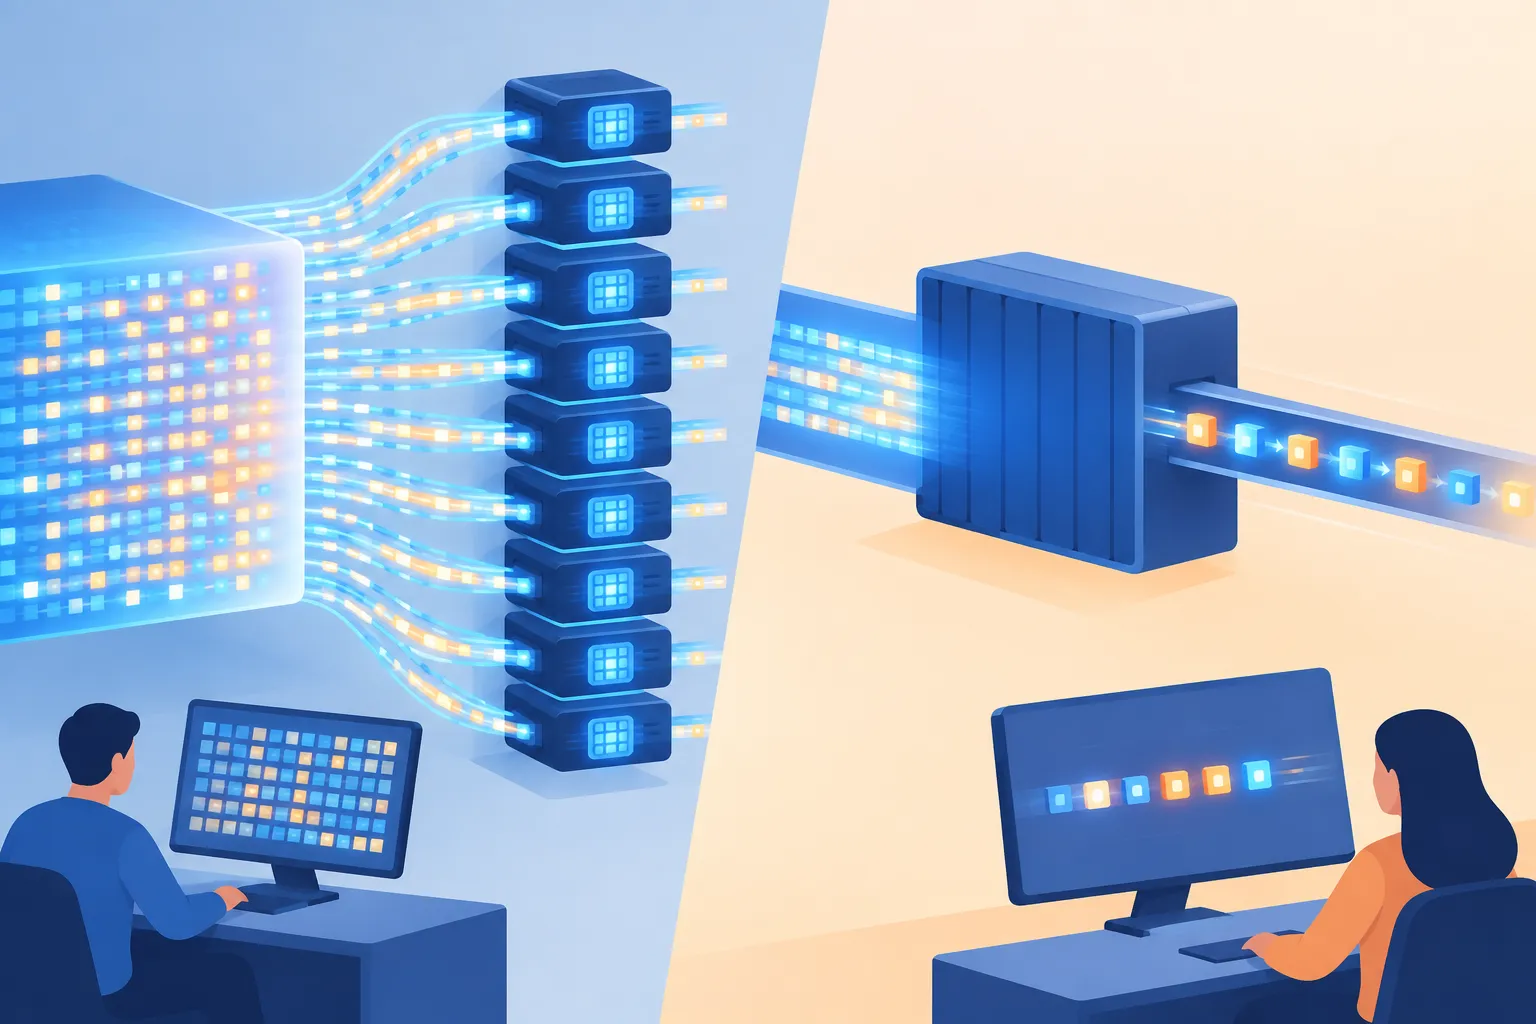
▲ prompt 처리와 token 생성의 차이
token 생성이 1.5배에 머무는 이유
LLM이 답변을 만드는 과정은 두 단계로 나뉩니다.
- prompt 처리 단계: 3만 2천 token 전체에 대해 무거운 행렬 곱셈을 한꺼번에 수행합니다. 연산량이 많아 GPU의 계산 능력이 속도를 좌우합니다.
- token 생성 단계: token을 하나씩 차례로 만듭니다. token 하나당 계산은 가볍지만, token 하나를 만들 때마다 모델 가중치 전체(27B 4비트 모델이면 약 15GB)를 통합 메모리에서 GPU로 읽어 와야 합니다.
결국 첫 단계는 연산 능력에, 둘째 단계는 메모리 대역폭에 묶여 있습니다. 각 GPU 코어에 들어간 뉴럴 가속기가 첫 단계를 최대 4배 끌어올렸고, 둘째 단계는 대역폭이 819GB/s에서 1.2TB/s로 약 50% 늘어난 만큼만 빨라졌습니다. 측정된 1.5배라는 수치가 대역폭 증가율과 거의 정확히 맞아떨어지는 것도 이 때문으로 해석됩니다.
이 원리는 모델 선택에도 그대로 적용됩니다. 4비트 양자화로 14B 모델을 약 8GB, 27B 모델을 약 15GB로 줄이면 token 하나당 옮겨야 할 데이터가 줄어 응답이 눈에 띄게 빨라집니다. Apple silicon에서는 MLX(Apple이 만든 머신러닝 프레임워크)용으로 변환한 모델을 쓰는 편이 대역폭과 가속기를 가장 잘 활용하는 방법입니다.
음성, 비전, 이미지, 영상 작업
LLM 채팅 외에 미디어 제작 작업에서도 비교가 이뤄졌습니다. 모두 로컬에서 실행했습니다.
Whisper 음성 받아쓰기
OpenAI의 음성 인식 모델 Whisper를 크기별로 돌렸습니다. 13.8분짜리 오디오 기준 결과는 다음과 같습니다.
| 모델 | M5 Ultra | M3 Ultra | 배율 |
|---|---|---|---|
| Large-v3 | 11.4초 | 20.2초 | 1.8배 |
| Turbo | 3.1초 | 7.1초 | 2.3배 |
| Medium | 7.7초 | 12.1초 | 1.6배 |
| Base | 2.1초 | 3.0초 | 1.4배 |
| Tiny | 1.7초 | 2.3초 | 1.3배 |
2시간 5분 분량의 촬영 원본 오디오에서는 Large-v3가 89.4초 대 152.6초(1.7배), Turbo가 24.4초 대 56.2초(2.3배), Tiny가 12.4초 대 16.6초였습니다. 두 시간이 넘는 녹음을 30초도 안 되어 받아쓴 셈입니다. Large-v3로 긴 오디오를 처리할 때 GPU 전력 소비는 약 28W에 불과해, 외장 GPU를 여러 장 묶은 구성과 비교하면 전력 효율이 크게 앞서는 것으로 보입니다. 긴 음성 메모나 초안 녹음이라면 Large-v3보다 훨씬 빠른 Turbo를 먼저 써 볼 만합니다.
비전 모델로 촬영 원본 분석
소리 없는 60초 카메라 원본을 초당 1프레임으로 Qwen3-VL 32B 4비트 모델에 넣어, 장면을 설명하는 기록을 자동으로 만들게 했습니다. 모델은 촬영본 속 인물의 옷차림, 외모, 팔의 문신 문구, 기계식 키보드와 도자기 머그 같은 책상 위 물건까지 정확히 짚어 냈습니다. 처리 시간은 M5 Ultra 22.9초, M3 Ultra 60.3초로 2.6배 차이였습니다. 오래된 가정용 비디오테이프를 디지털화해 목록을 만드는 일처럼, 클라우드 비디오 API 비용 없이 방대한 영상 자료를 색인하는 용도로 쓸 수 있다는 점이 핵심입니다.
이미지와 영상 생성
FLUX.2 klein 4B로 1024x1024 이미지를 만들었을 때 M5 Ultra는 2.6초(모델 로드 0.4초, 생성 2.2초), M3 Ultra는 10.2초가 걸려 4.0배 차이가 났습니다. 같은 장면을 사진처럼 사실적으로 바꾸라는 지시를 더하자 2.2초 대 7.0초(3.2배)였습니다.
MLX로 옮긴 LTX-2.5 22B 경량화(distilled) 모델로 생성한 이미지를 짧은 영상으로 움직이게 하는 작업은 17.5초 대 30.2초(1.7배), 더 큰 클립은 19.9초 대 50.5초(2.5배), 커피잔에서 괴물이 튀어나오는 다른 장면은 18.1초 대 47.7초(2.6배)였습니다.
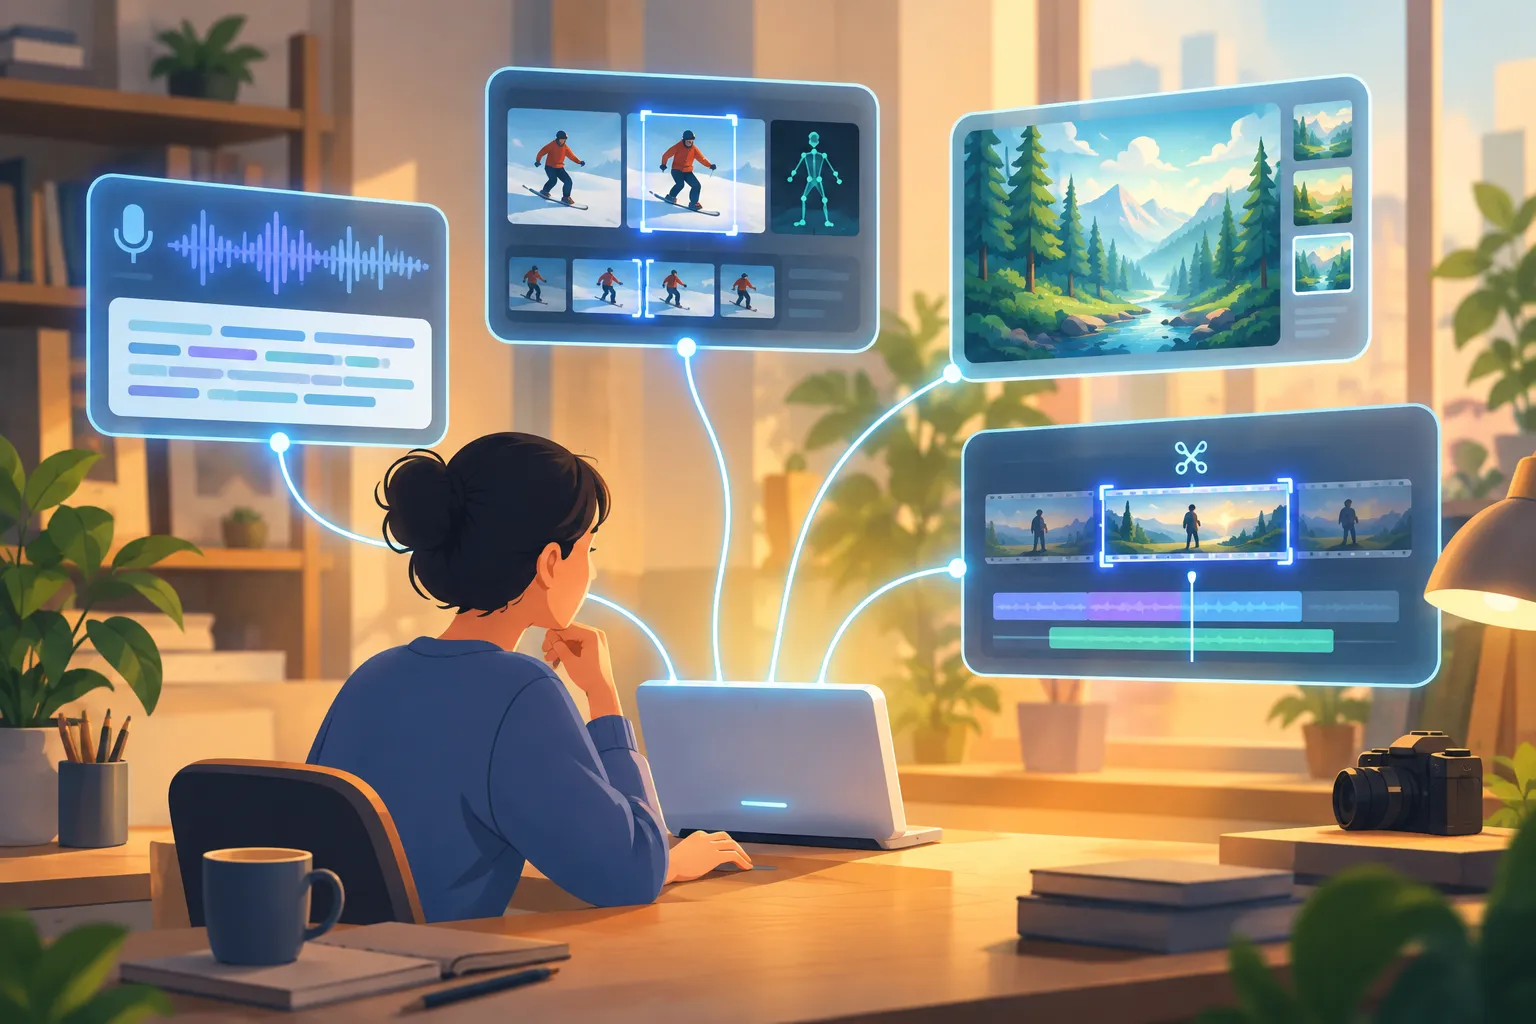
▲ 로컬 AI 기반 미디어 제작 작업
agent와 업무 자동화
로컬 모델을 agent의 두뇌로 쓰는 테스트도 진행했습니다.
- Hermes Agent v0.20.4를 M5 Ultra에서 도는 Qwen3.8 27B 4비트(컨텍스트 창 13만 1천 token)에 연결했습니다. 이전 세션의 개인 맥락이 담긴 2만 4천 token 이상의 컨텍스트를 빠르게 처리하고 사용자에 대한 질문에 정확히 답했습니다. 긴 컨텍스트를 매번 다시 읽는 agent 작업에서 prompt 처리 속도 향상이 직접 체감되는 사례로 볼 수 있습니다.
- 오픈소스 의도 분류 모델로 스팸 문자 100개, 일반 문자 100개, 은행 업무 질문 100개 등 300개 문항을 분류했습니다. 정확도는 두 기기가 똑같이 스팸 91.5%, 은행 의도 분류 66%였고, 처리 시간은 23.5초 대 33.4초(1.4배)였습니다. 하드웨어가 바뀌어도 결과 품질은 그대로이고 속도만 달라진다는 점을 보여 줍니다.
- LM Studio의 Bionic을 MCP(Model Context Protocol, AI 모델이 외부 프로그램을 조작하도록 연결하는 표준 규약)로 DaVinci Resolve Studio에 연결했습니다. Qwen3.8 27B 4비트 모델이 대본을 읽고 말 더듬기, 머뭇거림, 실수 구간을 찾아 Python API로 컷 명령을 내려 정리된 편집본을 타임라인에 만들어 냈습니다. 다만 전체 프로젝트의 컷을 계획하고 실행하는 데 약 13분이 걸려 속도 면에서는 아직 아쉬움이 남습니다.
가격과 업그레이드 판단 기준
테스트한 구성(80코어 GPU, 256GB 통합 메모리, 8TB SSD)은 Apple 온라인 스토어 기준 $14,299입니다. 12개월 할부 시 월 $1,191.50, 36개월 리스 시 월 $303.76입니다. 특히 내장 SSD 업그레이드 비용이 크게 붙습니다. 초기 비용은 월 단위 클라우드 API 요금보다 훨씬 높지만, 한 번 사면 구독료나 사용량 제한 없이 무제한으로 돌릴 수 있다는 점이 대비됩니다. 512GB 구성은 10월에 나올 예정이어서, 더 큰 오픈 웨이트 모델을 돌리거나 여러 대를 묶어 쓰려는 사용자라면 이를 기다리는 선택지도 있습니다.
지금까지의 결과를 바탕으로 업그레이드 가치를 판단하면 다음과 같이 정리할 수 있습니다.
| 사용 패턴 | 기대 체감 | 판단 |
|---|---|---|
| 긴 문서 요약, 대용량 컨텍스트 agent | 첫 token까지 3~4배 단축 | 업그레이드 효과가 큼 |
| 이미지 생성, 영상 원본 분석 | 2.6~4배 | 제작 파이프라인이 있다면 효과가 큼 |
| 음성 받아쓰기, 영상 생성 | 1.3~2.6배 | 작업량이 많을수록 유리 |
| 짧은 질문 위주의 채팅 | 생성 속도 약 1.5배 | 체감 폭이 상대적으로 작음 |
| 최고 수준의 복잡한 추론 | 로컬 모델만으로는 한계 | 클라우드 frontier 모델 병행 필요 |
로컬 기기가 아무리 빨라져도 최상위 수준의 복잡한 추론에는 클라우드 frontier 모델이 여전히 필요하다는 점은 분명히 해 둘 필요가 있습니다. 또한 이번 평가에서 코딩 작업은 다루지 않았고, 대부분의 테스트가 콘텐츠 제작과 미디어 처리에 맞춰져 있었다는 점도 감안해야 합니다.
정리: 내 작업이 어느 단계에 묶여 있는지부터 확인합니다
M5 Ultra의 ’최대 4배’는 GPU 코어마다 들어간 뉴럴 가속기 덕분에 prompt 처리 단계에서 실제로 확인됩니다. token 생성은 메모리 대역폭 증가폭만큼인 약 1.5배가 현실적인 기대치입니다. 따라서 업그레이드를 고민한다면 다음 순서로 점검해 보길 권합니다.
- 평소 작업에서 긴 prompt를 넣고 첫 응답을 기다리는 시간이 긴지, 아니면 긴 답변이 생성되는 시간이 긴지 구분합니다. 앞쪽이라면 체감 효과가 큽니다.
- 음성 받아쓰기, 영상 원본 색인, 이미지 생성처럼 반복되는 미디어 작업이 많은지 확인합니다. 작업량이 많을수록 로컬 처리의 비용 이점이 커집니다.
- 현재 쓰는 클라우드 API 비용과 $14,299의 초기 비용을 비교하고, 더 큰 모델이 필요하다면 10월 출시 예정인 512GB 구성을 기다릴지 결정합니다.
- 지금 쓰는 Apple silicon 기기에서도 MLX 변환 모델과 4비트 양자화, Whisper Turbo를 먼저 적용해 보면 하드웨어를 바꾸지 않고도 속도를 끌어올릴 수 있습니다.