どのAIモデルを使うかと同じくらい、作業をどう分けてどうまとめるかが結果を左右する可能性があります。デスクトップ向けコーディングアプリEvoX Agentを開発するEvoMapが、プログラミングと論理の問題563問で行ったベンチマークでは、1つのAIエージェントが単独で問題を解いた場合の正答率は26%でした。一方、多数のエージェントがそれぞれ独立した作業を1つずつ受け持ち、後から結果をまとめるエージェントスウォームは、同じ基盤モデルで71%を記録しました。モデルの重みやパラメーターは変えていません。変わったのは、タスクの割り振り方と、コンテキスト(モデルが一度に読み込む会話や資料)の管理方法だけです。
1つのエージェントに多くのタスクを任せると何が起きるか
1つのエージェントに複数のタスクを順番に任せると、会話履歴は増え続けます。4つ目のタスクに取りかかる時点でも、1つ目から3つ目までの履歴をすべて抱えたままです。この余分な情報が重要な細部を押しのけ、エージェントが情報を落としたり、事実でない内容を作り出したりする原因になります。作業量が増えるほど単独エージェントの精度が下がる主な理由は、このコンテキスト汚染にあります。
よくある対策は、監督役のエージェントがサブエージェント(サブタスクを1つずつ受け持つ補助エージェント)に作業を配り、その結果を要約する構成です。ところが同じベンチマークでは、サブエージェントが正解を373件見つけたにもかかわらず、言語モデルが出力を要約して統合した後に残ったのは217件だけでした。正答率に換算すると39%です。要約は情報を圧縮する作業であり、その過程で正しい答えが失われているとみられます。
| 構成 | ベンチマーク正答率 | 何が起きるか |
|---|---|---|
| 単独エージェント | 26% | 前のタスクのコンテキストが積み重なり続ける |
| サブエージェントとLLMによる要約統合 | 39% | 正解373件のうち統合後に残るのは217件のみ |
| エージェントスウォーム | 71% | タスクごとにクリーンなコンテキスト、結果はコードで統合 |
スウォームの精度を支える2つの設計
EvoX Agentのスウォームは2つの考え方に基づいています。1つ目は、各サブタスクを独立したクリーンなコンテキストで実行することです。各エージェントは自分の担当に必要な情報だけを見ます。2つ目は、言語モデルが要約を書くのではなく、決定論的なコード、つまり同じ入力から常に同じ出力を返すコードで結果を統合することです。これにより、統合の段階で正しい答えが言い換えによって失われることがありません。
独自のマルチエージェント構成を設計するなら、統合をモデルに任せる前にコードによる統合を試す価値がありそうです。ただし、上記の正答率はEvoMap自身のベンチマークによるものなので、自分の作業でも同様の差が出るかは確認しておくとよいでしょう。
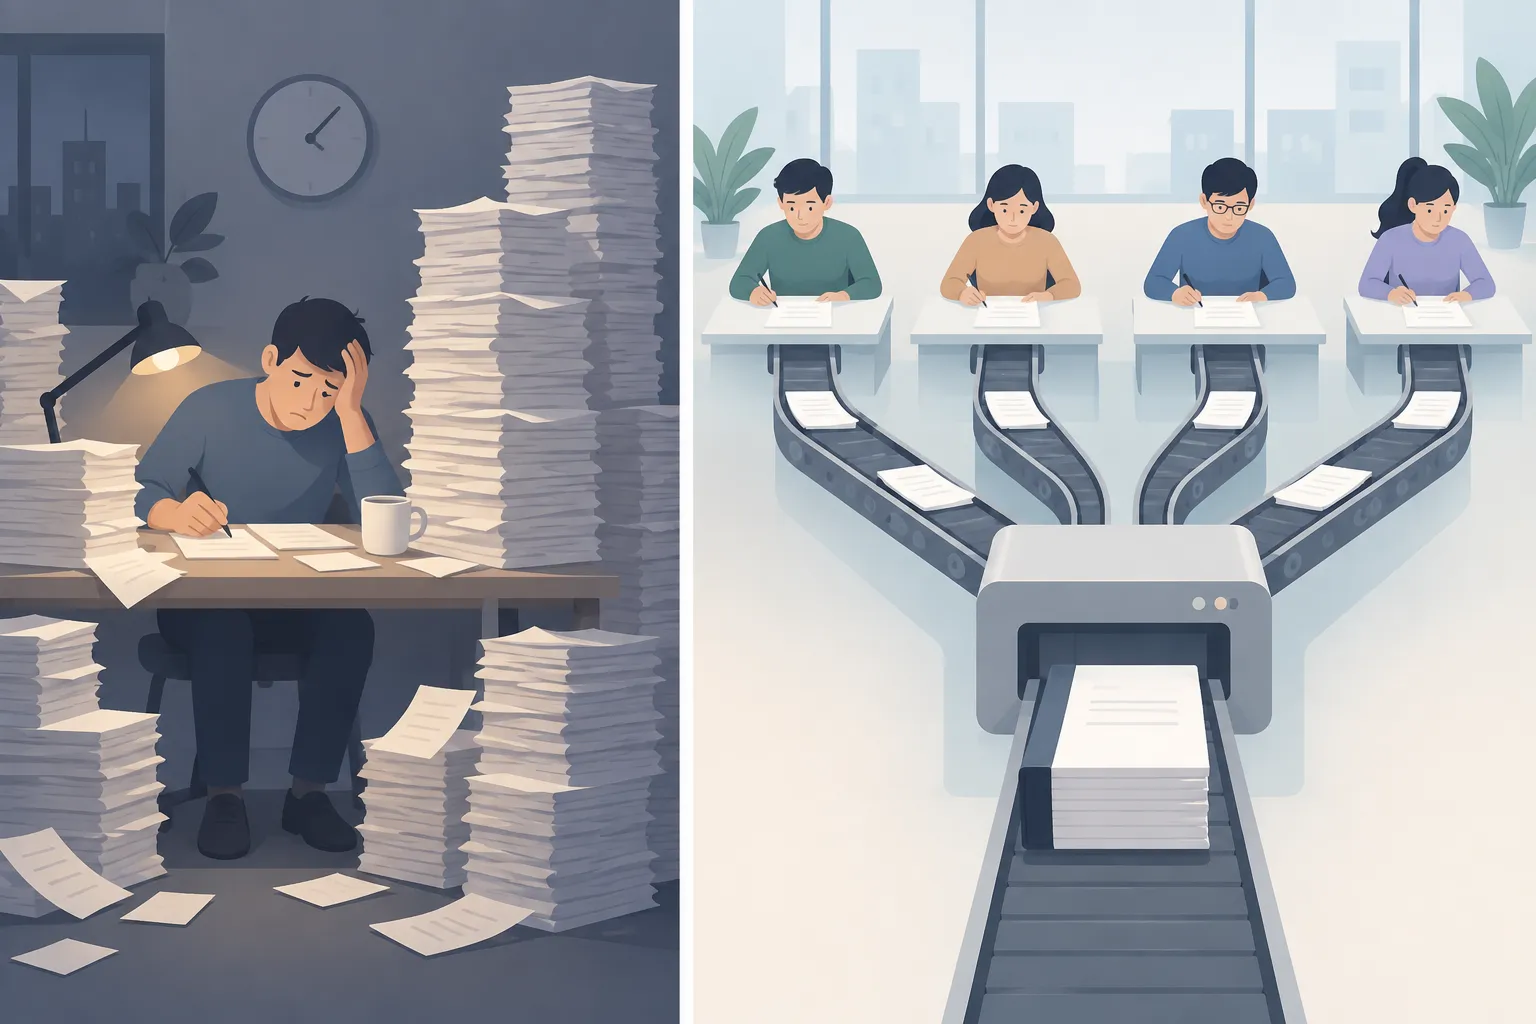
▲ 積み重なるコンテキストと分割したタスク
実際のアプリで比べたスウォームと逐次実行
日常的な開発作業でどの程度の差が出るのかを確かめるため、インドネシア語の単語を覚えるフラッシュカードWebアプリに、4つの作業を一度に割り当てました。
- node:testで単体テストを書く
- tscでリントと型チェックを実行する
- docs/API.mdにドキュメントを書く
- WCAG 2.2 AAに照らしてアクセシビリティを監査する
スウォームモードをオンにすると、EvoX Agentはまず調整計画を作成し、ファイルの担当ルールを定めました。どのエージェントがどのファイルに手を入れてよいかを決め、並行して動くワーカー同士の変更が衝突しないようにするためです。計画を承認すると、4つのエージェントが同時に作業を進め、7つのファイルを修正して約7~8分で完了しました。
続いて同じプロジェクトを複製し、スウォームモードをオフにして同じ作業を1つずつ順番に実行しました。
| 項目 | スウォーム実行 | 逐次実行 |
|---|---|---|
| 完了までの時間 | 約7~8分 | 約2.5倍長い |
| 使用したコンテキストトークン | 約8万4,000 | 約12万9,000 |
トークンはAIモデルがテキストを処理する単位で、使う量が多いほど一般にコストが上がり、応答も遅くなります。逐次実行では、完了したタスクの履歴を次のタスクへ持ち越すため、プロンプト(モデルに送る指示とコンテキスト)が膨らみ続け、推論が遅くなりました。
100のエージェントで挑むサバイバルゲーム
より大規模な実験では、スウォームを100の並列ワーカーまで広げました。題材はArenaというサバイバルゲームです。2Dのグリッド上で100の種が暮らし、食べる、移動する、繁殖する、攻撃するといった行動をとります。1つのプロンプトを100のタスクに分割し、各エージェントが自分専用のコンテキストの中で、1つの種の行動コードをJavaScriptで書きました。他のエージェントのコードや戦略は一切見ていません。100種すべてのスクリプトの生成と検証は約20分で終わりました。1つずつ処理していれば数時間かかったとみられる作業です。
| 世代 | 2,000ターン後に生き残った種 | 攻撃回数 |
|---|---|---|
| 第1世代 | 64 | 1万2,886 |
| 第2世代 | 99 | 0 |
第2世代は、成績の良かった生存種の行動原則をAIに与え、戦いを避けて食料を探す改良戦略を考えさせて作りました。前の勝者のルールから次の出力を生み出す手法を大規模な並列生成と組み合わせることは、複雑なシミュレーションや最適化の問題を効率よく改善していく方法になりそうです。
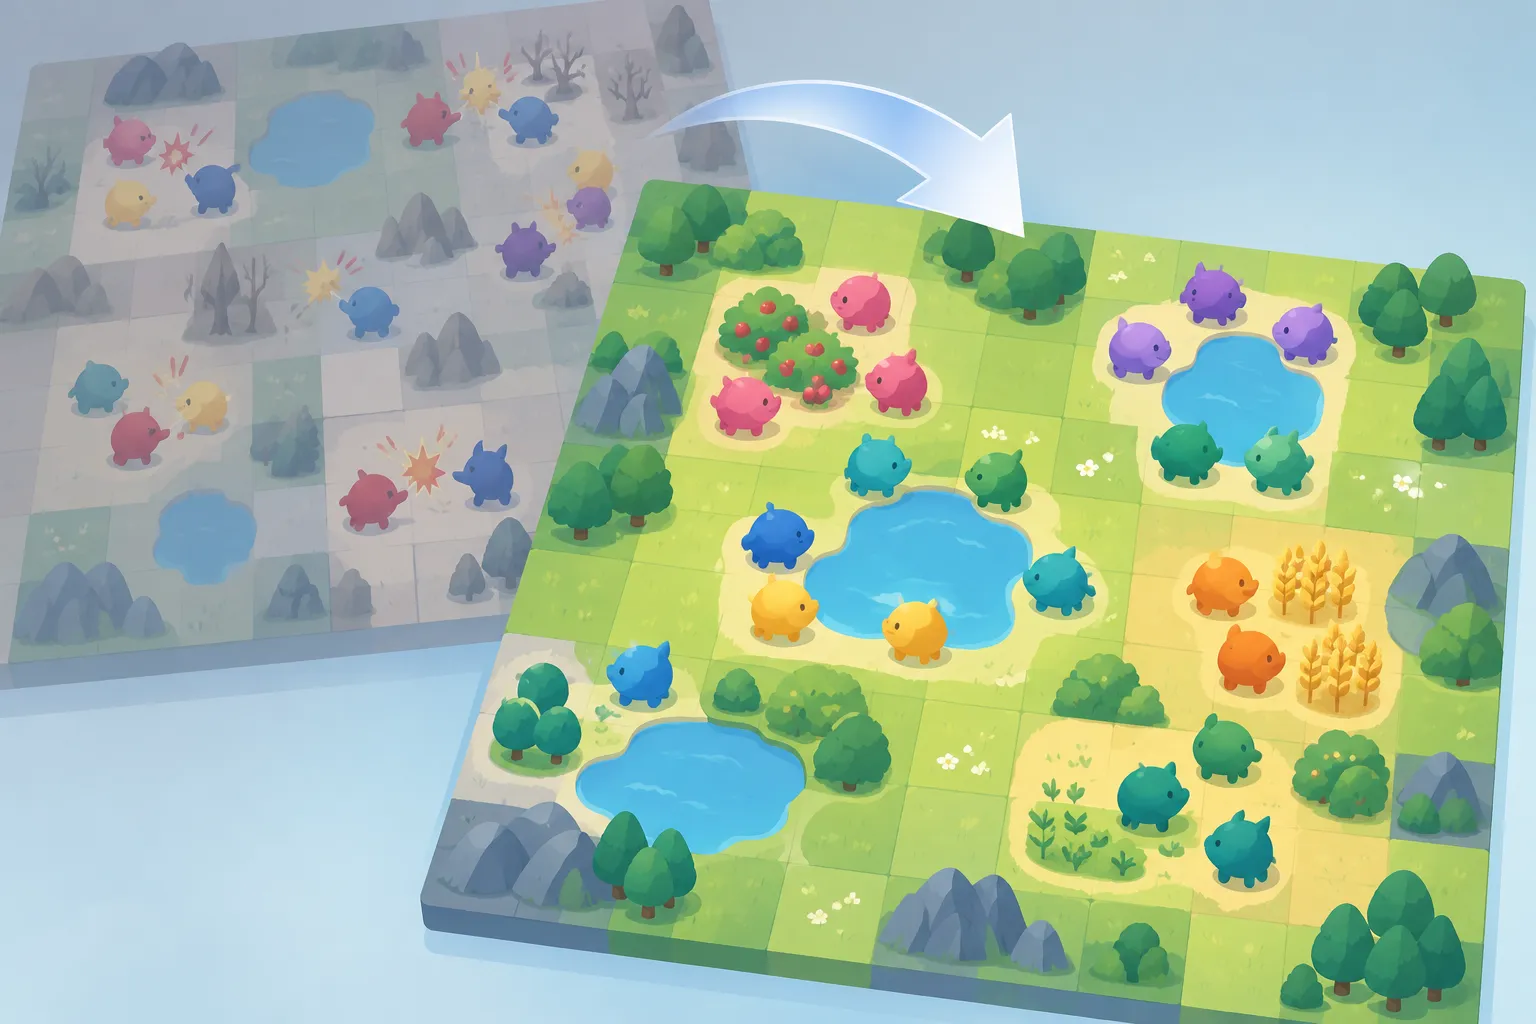
▲ 100のエージェントが作ったサバイバルゲーム
自己進化:うまくいったやり方を再利用する
EvoX Agentには、成功した作業を再利用可能な能力に変える自己進化の仕組みもあります。これは5つの段階で動きます。Observeでリクエストとターミナルの操作を記録し、Discoverで新しいシグナルを抽出し、Reuse or Improveで既存の能力を改良するかを判断し、Validateで実行結果を評価し、Solidifyで検証済みの手順を今後のために保存します。
- ジーン(gene)は、特定のSQLクエリのパターンを実行する、プロジェクトのスキーマを読むといった、小さく決定論的な手順です。
- カプセル(capsule)は、1つのタスクを最初から最後まで解いた完全な解決策で、性能指標、信頼度スコア、コスト、トークン使用量、再実行できる実行経路とともに保存されます。
- Eventsログは、エージェントが行ったすべての変更、修復、新しい能力の追加を記録する、改ざんできない記録です。
EvoMapは、システムがリポジトリや会話履歴の共通パターンを学習した後は、既知の解決策を導き直す代わりに再利用することで、トークン使用量を約31%削減できると主張しています。この数値はその場で完全には検証できませんでしたが、学習ループ自体はテストで問題なく動作しました。ジーン、カプセル、ミューテーションといった用語があるため、最初は仕組みがつかみにくく感じるかもしれません。
セットアップ
EvoX AgentはmacOSとWindows向けのデスクトップアプリです。基本機能はCodexやClaude Codeといったコーディングエージェントと同等で、コードベースのインデックス作成、コードの作成、コマンドの実行、失敗したテストの修正ができます。新規アカウントには約$15相当の無料トライアルクレジット1,500が付与されます。セットアップ時には、Claude CodeとCodexからセッション、メモリー、設定を取り込めます。
| モード | 役割 | 例 |
|---|---|---|
| Chat | 対話形式の質問と推論 | フラッシュカードアプリをライトナー方式の箱からSM-2の間隔反復アルゴリズムに切り替えるべきかを検討 |
| Cowork | 文書、計画、レポート | カードのデータを分析し、グラフと表を入れた1ページのPDF進捗レポートを作成 |
| Code | コードの変更、テスト、デプロイ | 統計APIのエンドポイントと画面の統計バーを追加し、npm testで確認してVercel CLIでデプロイ |
注目したい設定は次の通りです。
- モデルの自動切り替えでは、難易度に応じて作業を振り分けます。エコノミーのタスクはDeepSeek V4 Flashのような安価なモデルに、標準的な作業はGPT-5.6 TerraやKimi K3のようなモデルに回します。
- モデル接続は、OpenAI、Anthropic、GeminiのAPIに加え、OllamaやLM Studioといったローカルモデルサーバーにも対応しています。NVIDIA DGX Sparkで動かすローカルモデルを接続すれば、クラウドの計算料金をかけずに済みます。
- 承認モードでは、ステップごとに確認するConfirm steps、高リスクな操作だけ確認するSmart、Full autoから選べます。Full autoは、信頼できるプロジェクトや、何も削除・上書きしない作業に限るのが無難です。
- Connectionsを使うと、Slack、Discord、Telegram、WhatsApp、Microsoft Teamsなどのメッセージアプリからエージェントに指示を送れます。QRコードでスマートフォンを連携すれば、席を離れていてもタスクの状況を確認できます。
作業を複数のエージェントに分ける前に確認すること
多くのタスクを1つのエージェントに積み上げると、蓄積したコンテキストが精度と速度の両方を引き下げます。スウォームは、タスクごとにクリーンなコンテキストを与え、結果をコードで統合することでこの問題を抑えます。どのツールを使う場合でも、作業を複数のエージェントに分けるときは次の手順を取り入れる価値があります。
- 複数のファイルや関心事にまたがるプロンプトは、まず独立したタスクに分けられるかを確認する。
- 指示の中でファイルの担当を明示し、並行して動くエージェントが同じファイルを編集しないようにする。
- 結果をまとめるときは、モデルが書く要約よりもコードによる統合を優先する。
- うまくいった出力があれば、その原則を抽出して次の生成ラウンドに組み込む。
- 完全自動の実行は元に戻せる作業に限り、慎重を要する操作ではステップごとの承認を残す。
- ベンダーが示す精度やトークン削減の数値は、頼る前に自分の作業の一部で小さく試す。