Gemini 4は、GoogleのGeminiファミリーにとって久しぶりのメジャーバージョン更新です。Gemini 4 Argon Highをほかのモデルと同じ課題で比べた初期テストでは、はっきりしたトレードオフが見えました。計測された作業1件あたりのコストはGPT-6 Sol MaxやClaude Opus 5.5 Highより低い一方、インタラクティブな3D生成の結果は、説得力のある吊り橋から、形状が崩れて操作も当てにならないシーンまで幅がありました。これらの例は生成品質を確かめる最初の手がかりであり、モデルの実力を総合的に測るものではありません。
コスト比較から見えること
Gemini 4 Argon Highは、ツールを使うAIタスクのランキングで46モデル中8位です。このランキングは、タスクの完了、ツール利用の信頼性、指示に沿ってどれだけ調整しやすいかといった指標を考慮しています。Gemini 4 Argon Highのネット改善スコアは+7.92%で、首位のClaude Fable 5.1 Maxは+14.55%でした。
このモデルはランキングのパレートフロンティアにも入っています。パレートフロンティアは、計測された改善度とコストの間でそれぞれ異なるトレードオフを示すモデルの集まりです。Geminiのモデルは以前からコスト効率と価格競争力で知られており、Argon Highもコストと性能の曲線のほぼ中ほどに位置します。価格と能力を比べるチームにとって意味のある位置ですが、どのタスクでも優れた結果が出ることを意味するわけではありません。
ランキングが示す、直近14日間の作業1件あたりのコストの中央値(概算)は次のとおりです。
| モデル | 作業1件あたりのコスト中央値 |
|---|---|
| Gemini 4 Argon High | $0.80 ~ $0.90 |
| GPT-6 Sol Max | $1.30 |
| Claude Opus 5.5 High | $3.00 ~ $4.00以上 |
この比較では、Gemini 4 Argon HighのコストはGPT-6 Sol Maxよりおよそ3分の1、Claude Opus 5.5 Highより約70%低くなります。GPT-6 Lunaのように、コスト軸のさらに低い側に位置する安価な選択肢もあり、Argon Highは中価格帯の魅力的な位置にあるといえます。なお、コスト比較に載っているのはGPT-6 Sol Maxで、以下の3D比較で使われたのはGPT-6.1 Sol Maxです。
崩れなかった橋
あるテストでは、Gemini 4 Argon HighがWebGLを使ってインタラクティブなゴールデンゲートブリッジのシーンを生成しました。WebGLは、ブラウザーで3Dグラフィックスを表示する技術です。結果には、整った吊りケーブル、水面、動く船に加え、霧、交通量、波、時間帯を変える操作部が含まれていました。霧の操作は機能しましたが、最も強い設定ではシーンが隠れすぎました。
橋の構造と雰囲気は、Claude Sonnet 5.5 Highの出力と比べても遜色ありませんでした。GPT-6.1 Sol Maxは、より説得力のある水の描写と照明、洗練された操作画面を生成しました。Gemini 4 Argon Highの操作部は機能するものの、より詰め込まれた実用一辺倒の作りでした。構造が決まったシーンとしては優れた結果ですが、3Dタスク全般で安定した性能を示す証拠ではありません。
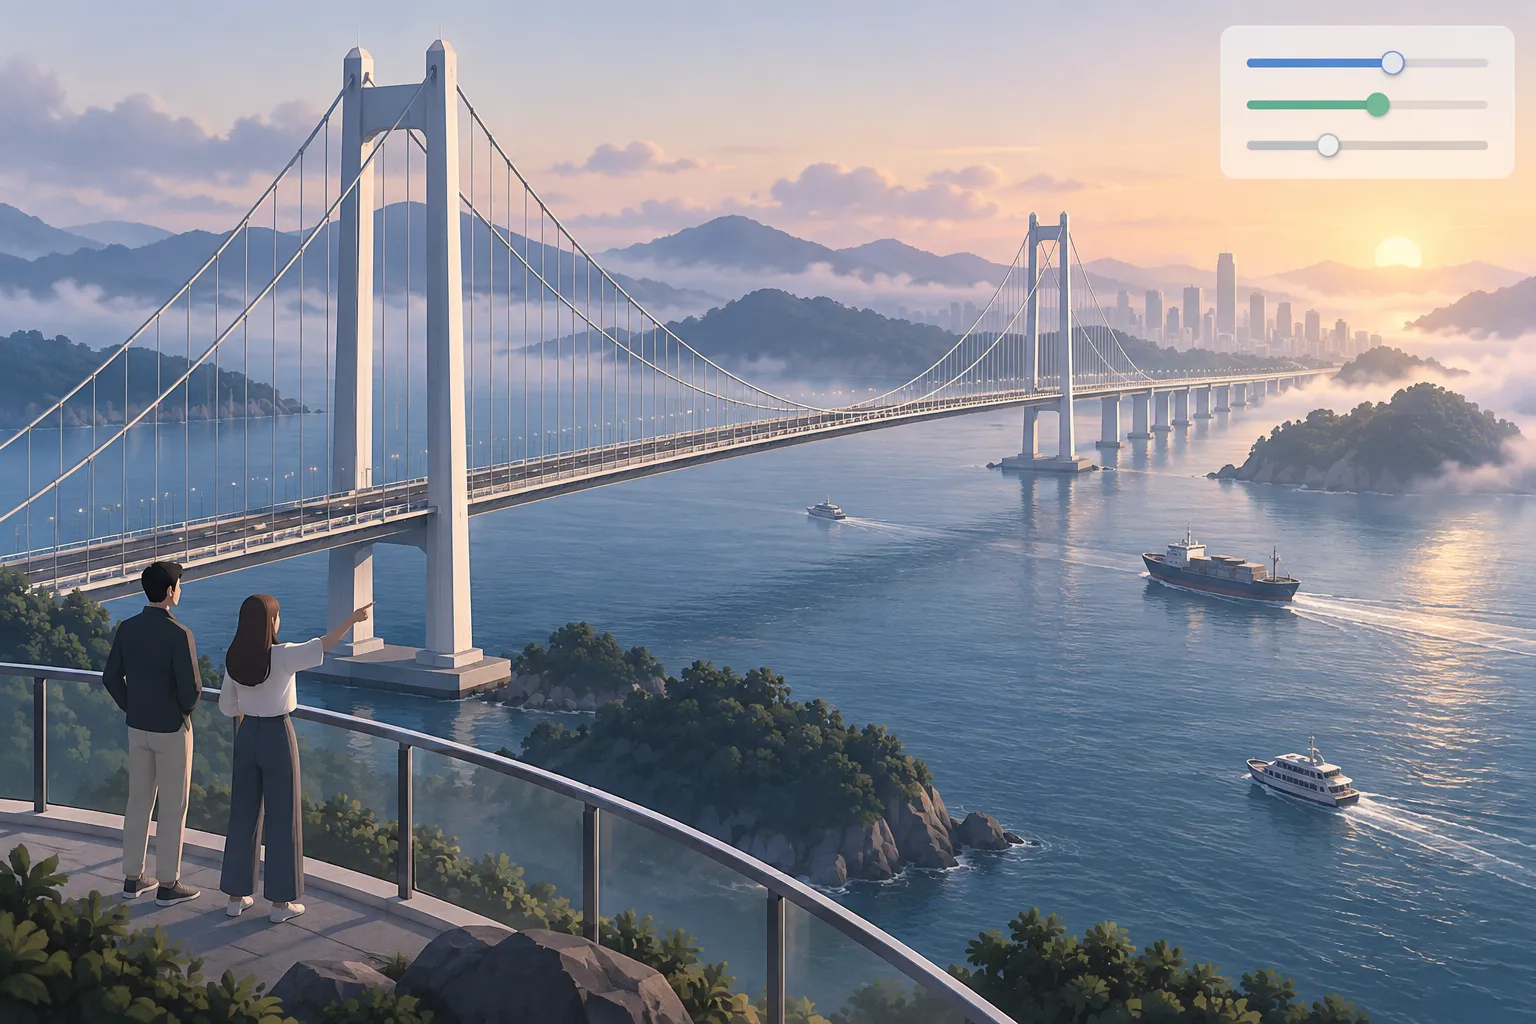
▲ 整った吊り橋のシーン
複雑なシーンで差が出る
浮島の課題では、有機的な地形、植生、滝、つながった構造物が求められました。Gemini 4 Argon Highは、断片化した地形、重なり合う木々、不自然な継ぎ目、島の下の暗い隙間を生み出しました。これに対し、Claude Sonnet 5.5 Highはまとまりのある段々畑、橋、幾重にも流れ落ちる滝を生成し、GPT-6.1 Sol Maxは湖、霧、流れる水の表現を作り出しました。その差は、島をさまざまな角度から確認すると特に明らかでした。
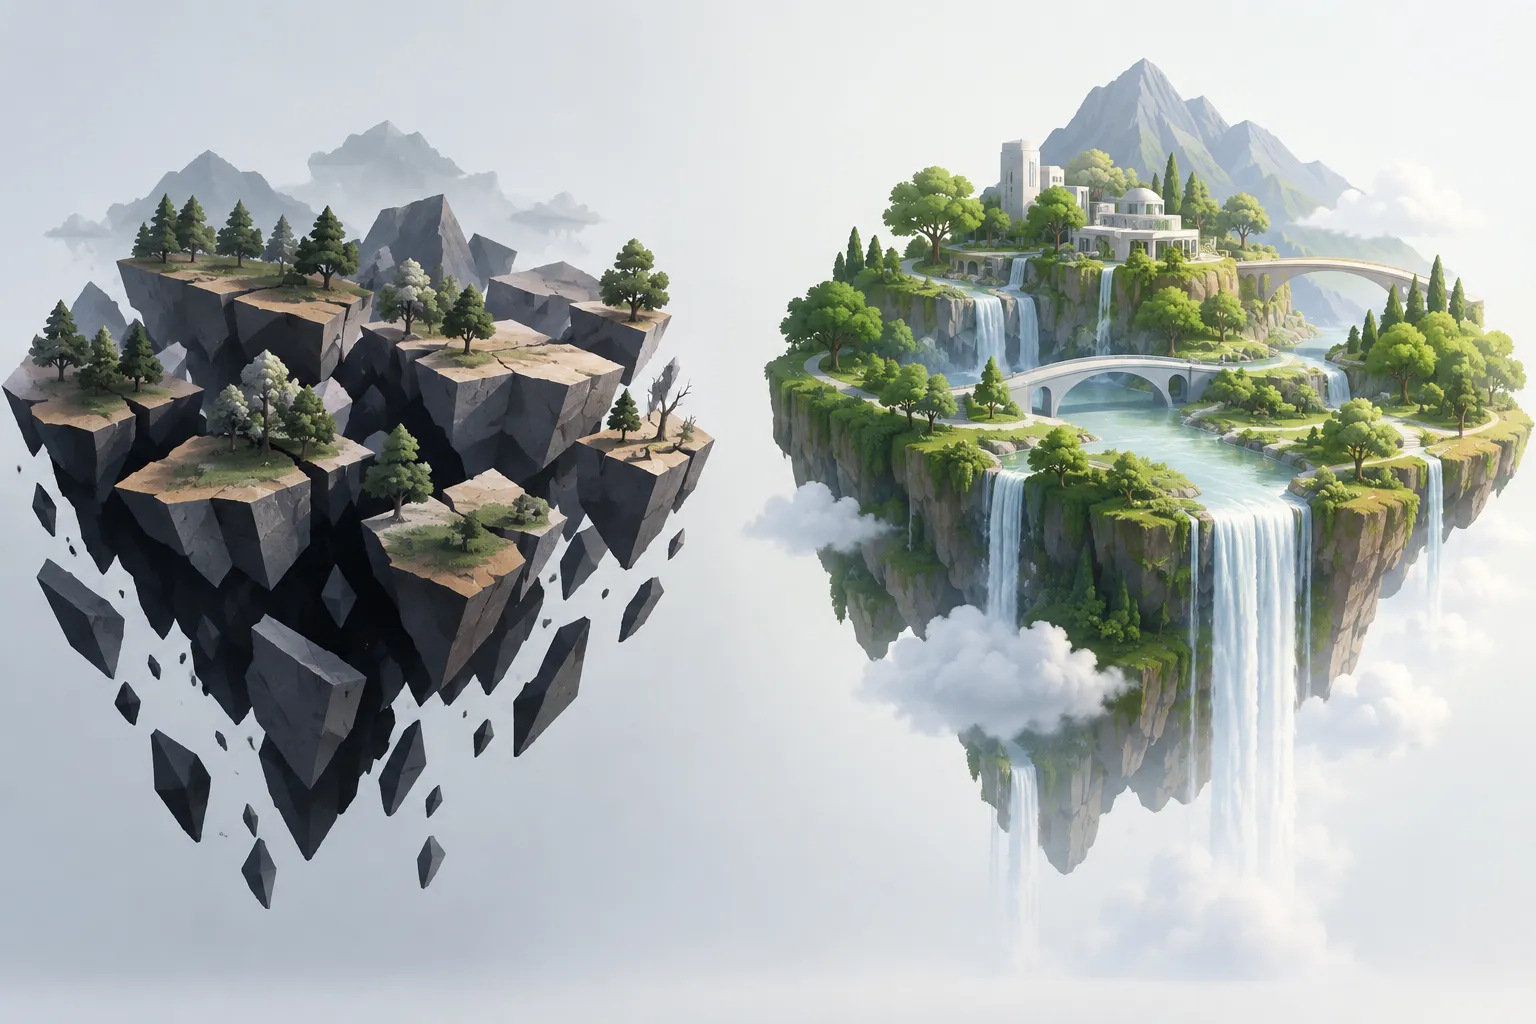
▲ 浮島のまとまりの違い
パリを舞台にしたインタラクティブな飛行ゲームでは、見た目以上のものが試されました。以前のGeminiモデルはゲーム生成で有望さを見せていましたが、Gemini 4 Argon Highが作った、飛行機でリングを集めるゲームの操縦は鈍く不安定でした。飛行機は建物に衝突し、シーンの一部をすり抜け、身動きが取れなくなりました。比較対象のGPT-6.1 Sol Maxのゲームは、旋回の反応がよく、飛行の動きも滑らかでした。ゲーム生成は言語モデルの主要な商業的指標ではありませんが、複雑な物理とゲームロジックを扱う力の弱点が表れました。操作や衝突のルールが機能しなければ、見栄えのよいシーンだけでは足りません。
建築物のプロンプトでも、全体の構図と細部の一貫性で同じような差が出ました。Gemini 4 Argon Highは船や足場を備えた段状のバベルの塔を組み上げましたが、作業員の姿は角ばっていて動かないか、地面から浮いていました。比較対象の出力では、GPT-6.1 Sol MaxとClaude Sonnet 5.5 Highが作業員により自然な動きを与え、建設現場の中にもっともらしく配置していました。
ホワイトハウスでは、Gemini 4 Argon Highは芝生、木々、噴水を描きましたが、屋根の上には正体不明の黒い塊があり、道路もきれいにつながっていませんでした。サグラダ・ファミリアのシーンでは、尖塔の先端がずれ、周囲の街路の配置も途切れていました。こうした結果は半年前なら印象的に見えたかもしれませんが、現在のフロンティアモデルと比べると見劣りするようです。
初期結果の生かし方
これらの3D課題は定性的なチェックであり、決定的なベンチマークではありません。指示への追従、構造の安定性、空間認識、一貫性といった基礎的な能力を推し量る手がかりになります。Gemini 4 Argon Highは基本的な指示にはよく従いましたが、プロンプトが複雑になるほど結果のばらつきが大きくなりました。ゲームの操作や3Dメッシュの生成で不安定な振る舞いを見せるモデルは、データベーススキーマ、コード構成、複数ステップのツール呼び出しといった業務でも、同様のばらつきを示す可能性があります。
コストを重視する作業なら、Gemini 4 Argon Highを明確に定義したタスクで試す価値はあるでしょう。モデルを比べる際は、能力の順位だけでなく、パレートフロンティアのようにコストを考慮した見方を使います。自由度の高いプロンプトに頼るのではなく、構成の要件やスキーマを明示し、目に見える結果とインタラクティブな部品の動作の両方を確認します。一貫性が重要なら、価格だけでモデルを選ぶ前に、繰り返し生成した出力を比べ、失敗例を確かめます。
実務での要点
Gemini 4 Argon Highは競争力のあるコストと優れた橋のシーンを兼ね備えていますが、浮島、ゲーム、建築物の例は、複雑さが増すにつれて一貫性が揺らぐことを示しています。計測上のコストの低さは評価する理由にはなっても、評価の代わりにはなりません。本番を代表するタスクから始め、要件を厳密に定め、細部とインタラクションが重要な箇所で結果が正しく保たれているかを確認しましょう。