Jevを使えば、Claude Codeは言語モデルに毎回回答全体を生成させずに、範囲を絞った判断を委ねられます。6つのオープンソースプロジェクトから、インターフェース、ブラウザー、ページのフィルタリング、検証、文字起こし分析での活用方法が見えてきます。7つ目の資料はリポジトリではなく、制作例を集めたディレクトリです。重要なのは、JevがClaude Codeに取って代わるかどうかではなく、どのタスクに素早く構造化された判断が必要かです。
文章生成ではなく、判断を担うレイヤー
TypeSafe AIが開発したJevは、入力をあらかじめ定められた選択肢、はい・いいえの判定、または確率に対応付けます。単語を一つずつ生成して回答するモデルとは異なります。この違いから、Jevは繰り返し行う分類や選択に適しており、広範な推論や計画は引き続きClaude Codeが担います。以下のプロジェクトは、両者の役割を分けるさまざまな方法を示しています。ただし、Claude Codeとの直接連携として紹介するのは、Model Context Protocolを使うプロジェクトだけです。
入力中や発話中に反応するインターフェース
shapeshiftリポジトリは、テキスト入力を、その意図に合うコンポーネントへと変えます。ユーザーが文字を入力している最中に、あらかじめ型を定めた14件の質問に沿って入力内容を評価します。25分のタイマーを求めると操作可能なカウントダウンになり、イベントのリクエストは編集可能なカレンダーカードになります。500/5という計算には、100を示すカードを返します。ユーザーがメニューをたどる前に、インターフェースが次に取るべき形を選ぶという発想です。
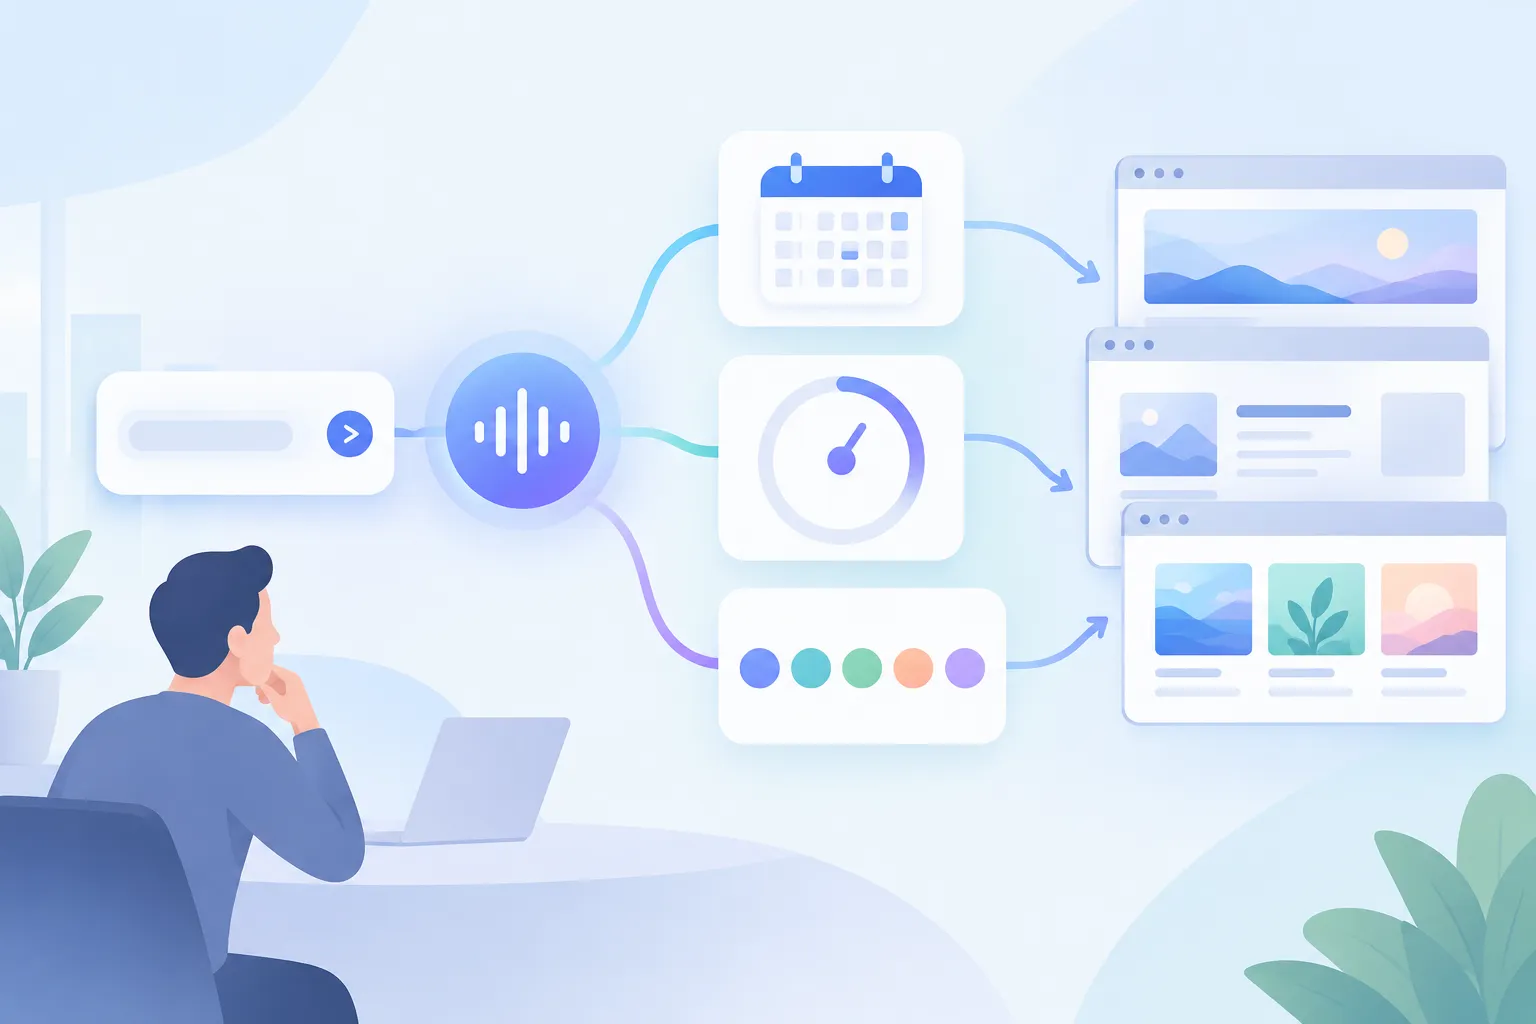
▲ 適応型入力と音声ブラウジング
jev-voice-browserリポジトリは、同様の発想を音声に応用します。逐次届く発話中の単語を評価し、ブラウザー自動操作ツールのPlaywrightを使って、推定した指示を実行します。音声による指示でWikipediaのページ間を移動する例が示されています。報告された意図判定の遅延は、発話された単語1語当たり約250~350ミリ秒で、文が終わる前にブラウザーが反応し始めます。汎用の対話アシスタントというより、音声によるナビゲーションを検討する開発者に役立つ例です。
ブラウザーでの選択とページのフィルタリング
typesafe-computer-useリポジトリは、画面内の文字を読み取るOCRと、Webページの構造を表すDOMツリーを使って、操作対象の要素を選びます。判定のたびに画面全体のスクリーンショットに頼るのではなく、そこから得た要素の位置を使います。チケット購入手続きの例では、チケットの選択肢を特定し、ページ上の操作部品を使って進みます。報告された比較結果は、このコンピューター操作テストに限ったもので、Jevを使うあらゆるアプリケーションで測定された高速化ではありません。
| 報告されたテストの指標 | Jevを使ったtypesafe-computer-use |
スクリーンショットを使うClaude Opus 5 |
|---|---|---|
| 判断またはステップの遅延 | 0.13~0.38秒 | 5.2~5.5秒 |
| 12ステップのタスクのコスト | $0.003 | $0.50 |
この種の作業では、役割分担は明快です。推論モデルがタスクに必要なことを決め、Jevが特定済みのインターフェース要素から対象を選びます。報告された数値はこのテスト事例のものであり、開発者が自身のタスクで想定すべきコストや所要時間ではありません。
▲ ブラウザー要素の選択と内容審査
typesafe-adblockリポジトリは、別のブラウザータスクを試します。このChrome拡張機能は、ページの表示に合わせてDOMブロックを調べ、それぞれが広告に見えるかをJevに判定させ、広告である確率が高いと分類されたブロックを除去します。SpeedtestとFandomのページからバナー要素を除去した例もあります。ページの表示中に分類する実験的な使い方であり、通常の広告ブロックには、既存のルールベースの広告ブロッカーのほうが依然として効率的です。
Claude Codeに小さな検証タスクを任せる
jev-mcpリポジトリは、Claude Codeとの最も明確な直接連携例です。MCP(Model Context Protocol)は、アシスタントが外部ツールを使えるようにする仕組みです。このパッケージは、スクリーニング用のjev_screen、抽出用のjev_extract、提供された資料に照らして主張を確認するjev_verifyなど、11種類のJev判断ツールを提供します。応答時間は150~500ミリ秒と報告されています。
料金ページを使ったあるテストでは、Claude Codeは外部ページの内容を判断の根拠にする前に、Jevでスクリーニングしました。スクリーニングツールは、アシスタントを別の方向へ誘導しようとする隠れた試みを確率0.99と判定し、一連の処理はその指示に従いませんでした。続いてJevは、料金に関する4件の主張を抽出済みのページ内容と照合し、「裏付けあり」または「矛盾あり」の判定を返しました。このテストでのJevの2回の呼び出しは、合わせて$0.000062でした。確率スコアはツールの出力であり、今後のあらゆるページや主張が正しく分類される保証ではありません。
この方法は、エージェントが大量の外部資料を評価しなければならない場合に役立つ可能性があります。資料をスクリーニングし、重要な情報を抽出し、範囲を絞った主張を検証したうえで、より広い推論を担うモデルにその情報を渡します。このリポジトリは、TypeSafeのAPIキーを使い、Claude CodeまたはCodex向けのMCPサーバーとして導入できます。
文字起こしを採点し、ほかの制作例を探す
jevmeterリポジトリは、音声を文字に変換するWhisperまたはFaster-Whisperと、文ごとに行うJevの判定を組み合わせます。事実に関する主張の正確性、はぐらかし、自己矛盾、感情への訴えかけ、質問への回答回避などの項目のスコアを表示します。大統領討論会を使ったテストでは、約118万の入力トークンに対してJevを1191回呼び出しました。報告されたAPIコストは$0.0497で、1回の呼び出し当たりの応答時間の中央値は0.4秒でした。これらは一つの実演で得られた数値であり、特定の話者が真実を語ったかどうかをスコアで確定できる証拠ではありません。同じ手法は商品販売の配信における発話上の手がかりの分析にも応用を検討できますが、手がかりとコンバージョンの変化との関係は慎重に解釈する必要があります。
7つ目の資料は、551件のJevを使った制作例とユースケースを掲載するコミュニティのディレクトリであり、7つ目のコードリポジトリではありません。分類には、エージェントとブラウザー、ゲームとリアルタイムシステム、コンテンツとグロース、ツールとアプリが含まれます。速度に関する主張から入るのではなく、既存のプロジェクトに合うタスクのパターンを探す手がかりになります。
委ねる判断を一つ選ぶ
まずは、すでに理解している作業の中から、ページ要素の選択、コンテンツブロックの分類、抽出したテキストに照らした主張の確認など、範囲の明確なタスクを選びます。その作業にすでにClaude Codeを使っているなら、jev-mcpが最も直接的な出発点です。ほかのリポジトリは、検討すべきインターフェースやブラウザーの設計例を示しています。広範な計画は推論モデルに任せ、Jevに委ねる判断を増やす前に、自身のタスクで精度、遅延、コストを測定することが重要です。