コーディングエージェントの会話記録は、完了した作業の記録にとどまらず、監査の手がかりにもなります。Claude Codeは、プロンプト、ツール呼び出し、出力、エラーを含むセッションの会話記録を保存します。記録を見直すと、トークンを浪費したり、作業を繰り返し中断させたりする使い方が見えてきます。開発者が記録を活用するには、ローカルファイルを調べて手早く問題を診断する方法と、記録を構造化データにして長期的に監査する方法があります。
まずローカルの記録を調べる
Claude Codeは会話記録をJSONLファイルとして保存します。JSONLは、1行に1件のJSONレコードを格納する形式です。レコードには、会話の各ターンやエージェントが使用したツールについて、深く入れ子になった情報が含まれることがあります。手作業では確認しにくいうえ、Claude Codeは標準設定で30日後にローカルの会話記録を削除します。長期的な傾向を調べたい場合は、その期限までに必要な記録を保管する必要があります。
手早く確認するなら、開発者はClaude Codeにローカルの会話記録ディレクトリを探させ、専用のスキャン用スキルを使ってファイルから件数や繰り返し起きる問題を抽出できます。役立つのは範囲を絞った調査結果の一覧であり、会話全体をモデルに流し込むことではありません。2026年8月19日から9月23日までの会話記録3,967件をローカルで調べたところ、異なる種類の問題がいくつか見つかりました。
- 対話的な確認を行わずに動作するヘッドレス実行では、権限確認に対応できず、PowerShellの呼び出し343件中337件が失敗しました。
- エージェントのエラー236件中225件は、委任を重ねる過程で同時実行できるサブエージェントの上限に達したことに関係していました。
- トークン消費量の62%は、上位1%のセッションに集中していました。トークンは、モデルがテキストを読み取り、生成する際に処理する単位です。
これらの件数から、検討すべき点はそれぞれ異なります。権限エラーについては、コマンドをどう承認するかを見直す必要があります。委任の問題については、エージェントが起動できるサブエージェントの数に上限を設けることが考えられます。トークン消費の集中については、極端に長いセッションを詳しく調べる必要があります。この調査で分かるのは調べるべき箇所であり、提案した設定変更が有効かどうかまでは、調査結果だけでは証明できません。
▲ ローカルのエージェント活動の簡易監査
直接調べる方法は、手元にあるファイルをそのまま使える点で便利です。一方、保存する記録が増えると弱点が表れます。大量の生の会話記録をコーディングエージェントに読み込ませると、入力トークンを数十万消費することがあります。逆に、数ファイルだけを抜き出して調べると、繰り返し発生するエラーを見逃すおそれがあります。単発の調査は出発点として有用ですが、複数のプロジェクトや数カ月にわたる傾向の比較にはあまり向いていません。
継続的な監査に向けて記録を構造化する
もう一つの方法では、保存、処理、分析を分けます。Claude Codeが古いローカルファイルを削除する前に、開発者は選んだ会話記録をDatabricks Unity Catalog Volumeに保管できます。ある保管例では、サイズの大きいJSONLファイルを62件使用しました。大規模データを処理するシステムであるApache Sparkでこれらのファイルから396,404件のレコードを読み取り、2,241件の異なるセッションを特定しました。
次に、PythonからApache Sparkを使うPySparkのノートブックで、入れ子になったレコードをセッション、会話のターン、ツール呼び出しという3つのDeltaテーブルに整理しました。Deltaテーブルを使えば、生の会話記録を言語モデルに繰り返し送らずに、構造化されたデータを照会できます。セッションID、タイムスタンプ、ツール名、エラーの分類、実行時間などの項目により、エージェントの活動の特定部分を比較できます。
Databricks Genie Codeは、ノートブックの準備や会話記録ごとの構造の違いへの対応に役立ちます。その後の分析では、Model Context Protocol(MCP)サーバーを介してClaude CodeをDatabricks GenieとDatabricks SQLに接続します。MCPは、AIアシスタントが外部ツールを使うための仕組みです。Claude Codeは元のファイルを会話に読み込む代わりに、集計を依頼できます。Databricksがテーブル内のレコードを選択・集計するSQLクエリを実行し、その結果を返します。
構造化データへのクエリの一つでは、ツール呼び出しのエラー3,450行を調べました。報告された件数が最も多い3分類は次のとおりです。
| エラーの分類 | 件数 | 示している内容 |
|---|---|---|
exit_code |
946 | コマンドがエラーステータスで終了した |
hook_block |
506 | 設定された保護機構が呼び出しをブロックした |
path_not_found |
500 | ツールが存在しないパスを使おうとした |
件数が多いだけで、保護機構を外すべきとは言えません。ブロックされた呼び出しには、必要な保護が働いたケースも、誤検知もあり得ます。セキュリティ設定を変更する前に、個々のケースを確認する必要があります。
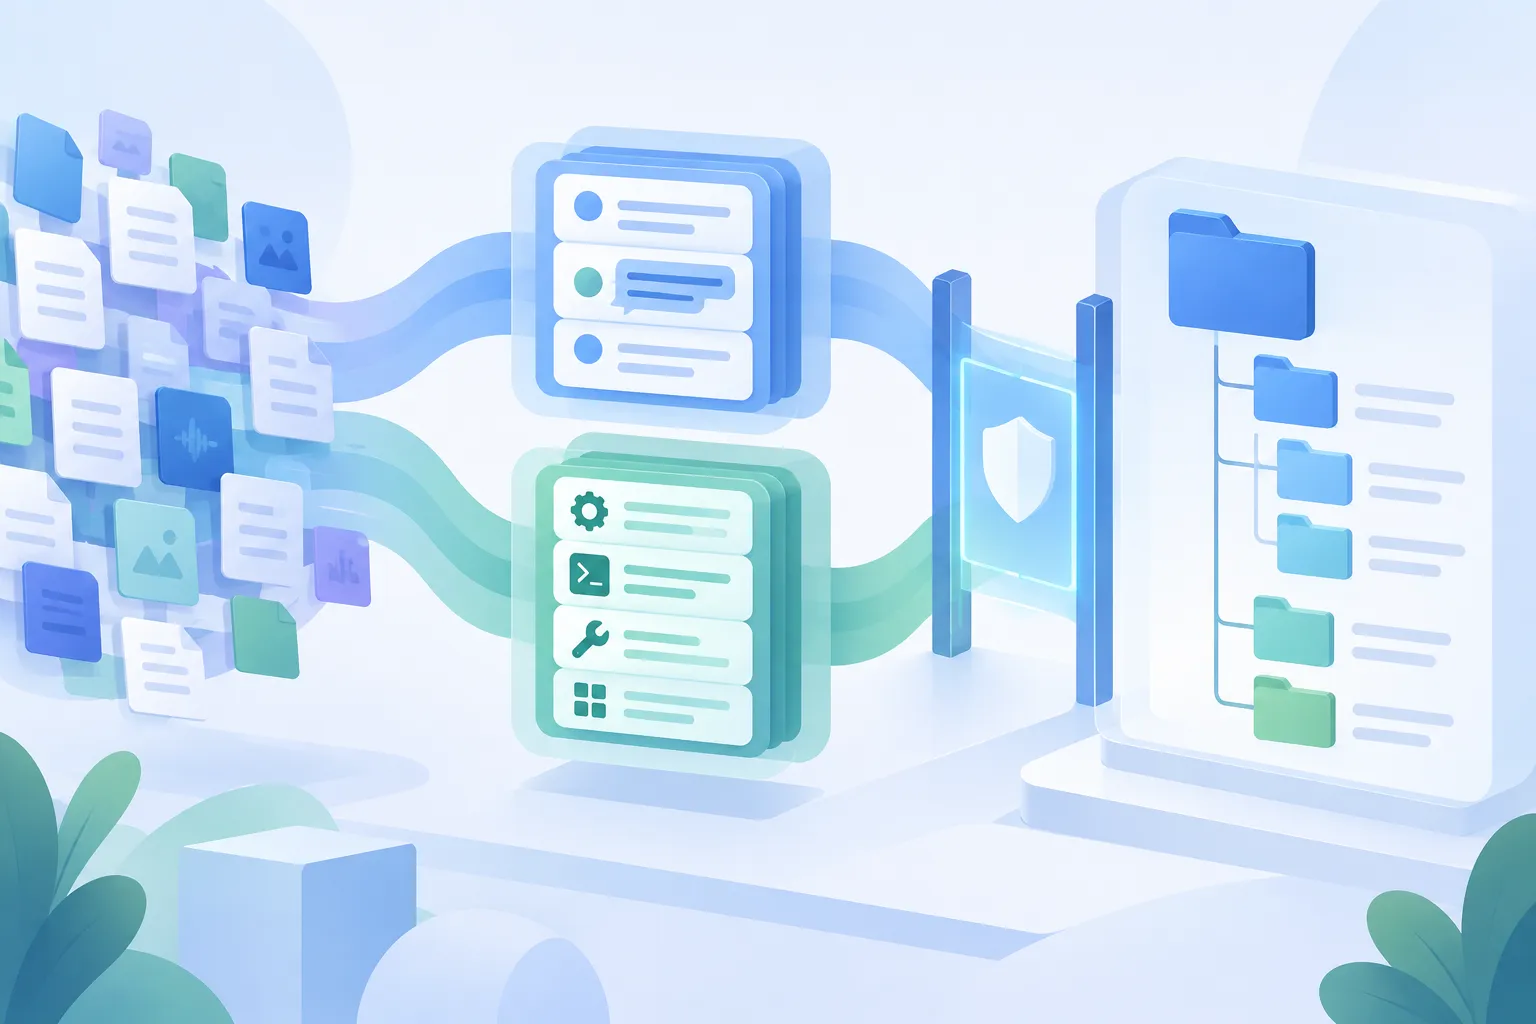
▲ 会話記録の構造化と分析
記録を保管するなら、データの取り扱いにも責任が伴います。会話記録には、コード、プロンプト、APIキー、認証情報、企業の機密情報が含まれる可能性があります。クラウドにアップロードする前に内容を確認して機密情報を除去し、保管先へのアクセスを制限したうえで、提供事業者のデータ保護条件を確認してください。Databricksは、顧客の入力と出力を第三者の基盤モデルの学習に使用しないとしていますが、その方針が会話記録の内容確認に代わるわけではありません。
調査結果を具体的な変更につなげる
監査が意味を持つのは、エージェントの次のセッションに変化をもたらすときです。調査した環境では、結果を踏まえてCLAUDE.mdにグローバル指示を38行追加し、settings.jsonの権限設定と起動時のフックも変更しました。一つの大きな修正で済ませるのではなく、異なる失敗のパターンにそれぞれ対応した変更です。
パスのエラーに対しては、ファイルの場所を推測せず、編集前にlsかglob(ファイル名のパターン検索)でディレクトリを確認するようClaude Codeに指示しました。また、SessionStartフックでPythonスクリプトを実行し、各セッションの開始時に深さ2階層までのディレクトリ構成を渡しました。これにより、エージェントは最初のファイル操作の前にリポジトリの構成を把握できます。
コマンドの書式に起因する失敗に対しては、複数行にわたる、または引用符を多く含む複雑なBashやPowerShellのコマンドを、インラインの文字列ではなく一時スクリプトに記述するようルールを設けました。監査では、エスケープ処理と複数行の引用符に関連する、予期しないファイル終端エラーが290件見つかっていました。権限設定では、破壊的な操作を伴わない一部のGitコマンドを事前承認しました。また、委任の重ねすぎに対処するため、並列実行するサブエージェントのバッチを20タスクまでに制限しました。
どの変更も、その後のセッションで効果を確かめる必要があります。エラー件数が減ればルールを維持する根拠になります。一方、作業がブロックされる新たなパターンが見つかれば、見直しが必要かもしれません。過去のログは判断材料になりますが、確認しなければ設定が自動的に改善されることはありません。
次の監査を役立てるために
まず、ローカルの会話記録に機密情報が含まれていないか、監査に必要な記録がClaude Codeの30日後の削除期限に近づいていないかを確認します。対象を絞ったローカル調査で、発生頻度やコストが最も高い問題を探します。継続的な監査のために大規模な保管先が必要なら、記録をセッション、ターン、ツール呼び出しに構造化します。そうすれば、会話全体を読み直さずにエラーを対象としたクエリを実行できます。そのうえで、ルールや作業手順を小さく具体的に変更し、今後のログで同じ失敗が再発するかを確かめます。