AIの安全性は、モデルの振る舞いを定めるルールだけに頼ることはできません。セキュリティの専門家は、より実務的な懸念を示しています。最先端のAI研究所がモデルのリスクを議論する一方で、経験豊富な防御担当者が基本方針の議論に必ずしも加わっていないことです。その視点が重要なのは、AIシステムがデータ、コード、権限、ネットワーク、そして問題が起きたときに対応する人々にも依存しているためです。
安全性にはモデルを取り巻くシステムも含まれます
OpenAIとAnthropicは、モデルの安全性に注意を促している最先端のAI研究所に含まれます。しかし、安全性の議論では、アクセス制御、監視、ネットワーク分離、インシデント管理といった従来からの防御策に十分な注意が向けられないことがあります。ネットワーク分離とは、あるシステムにアクセスできても、ほかのシステムに自動的にはアクセスできないよう、システムを分けることです。
英国国家サイバーセキュリティセンターの元責任者は、こうした基本的な防御策が存在しないことを前提とする極端なAIリスクのシナリオに異議を唱えています。それで将来のAIの能力に関するすべての疑問に答えが出るわけではありません。ただ、安全性に関する主張を評価するうえで有用な問いが浮かびます。その主張は、モデルが実際に稼働するセキュリティアーキテクチャを考慮しているでしょうか。
モデルの振る舞いを望ましい方向に導くアラインメントは有益な取り組みですが、その役割は従業員向けの行動規範に近く、システムがどう振る舞うべきかを定めるにとどまります。しかし、システムがアクセスできる範囲や、人がシステムを使ってできることを制限する統制策の代わりにはなりません。セキュリティアナリストや脅威の研究者が早い段階から参加すれば、こうした欠落が運用上の問題になる前に、研究所が見つけられる可能性があります。
開発に防御策の設計を組み込みます
独立した監査や、テスターがシステムの弱点を探るレッドチーミングは、問題の発見に役立ちます。ただし、導入後の一度きりの確認にとどめるよりも、開発や学習の過程で継続して行うほうが有効です。チームはモデルの公開前に、権限を見直し、システム間のやり取りを調べ、封じ込め策が機能するかを試す必要があります。
実験的なテストの中には、外部ネットワークから物理的に切り離すエアギャップが必要なものもあります。完全な隔離が目的なら、ソフトウェア上で無線接続をオフにすることは、Wi-Fi、Bluetooth、ネットワークインターフェースのハードウェアを取り外すことと同じではありません。通常の振る舞いを制御する安全策を外してモデルをテストする場合、この違いは特に重要です。
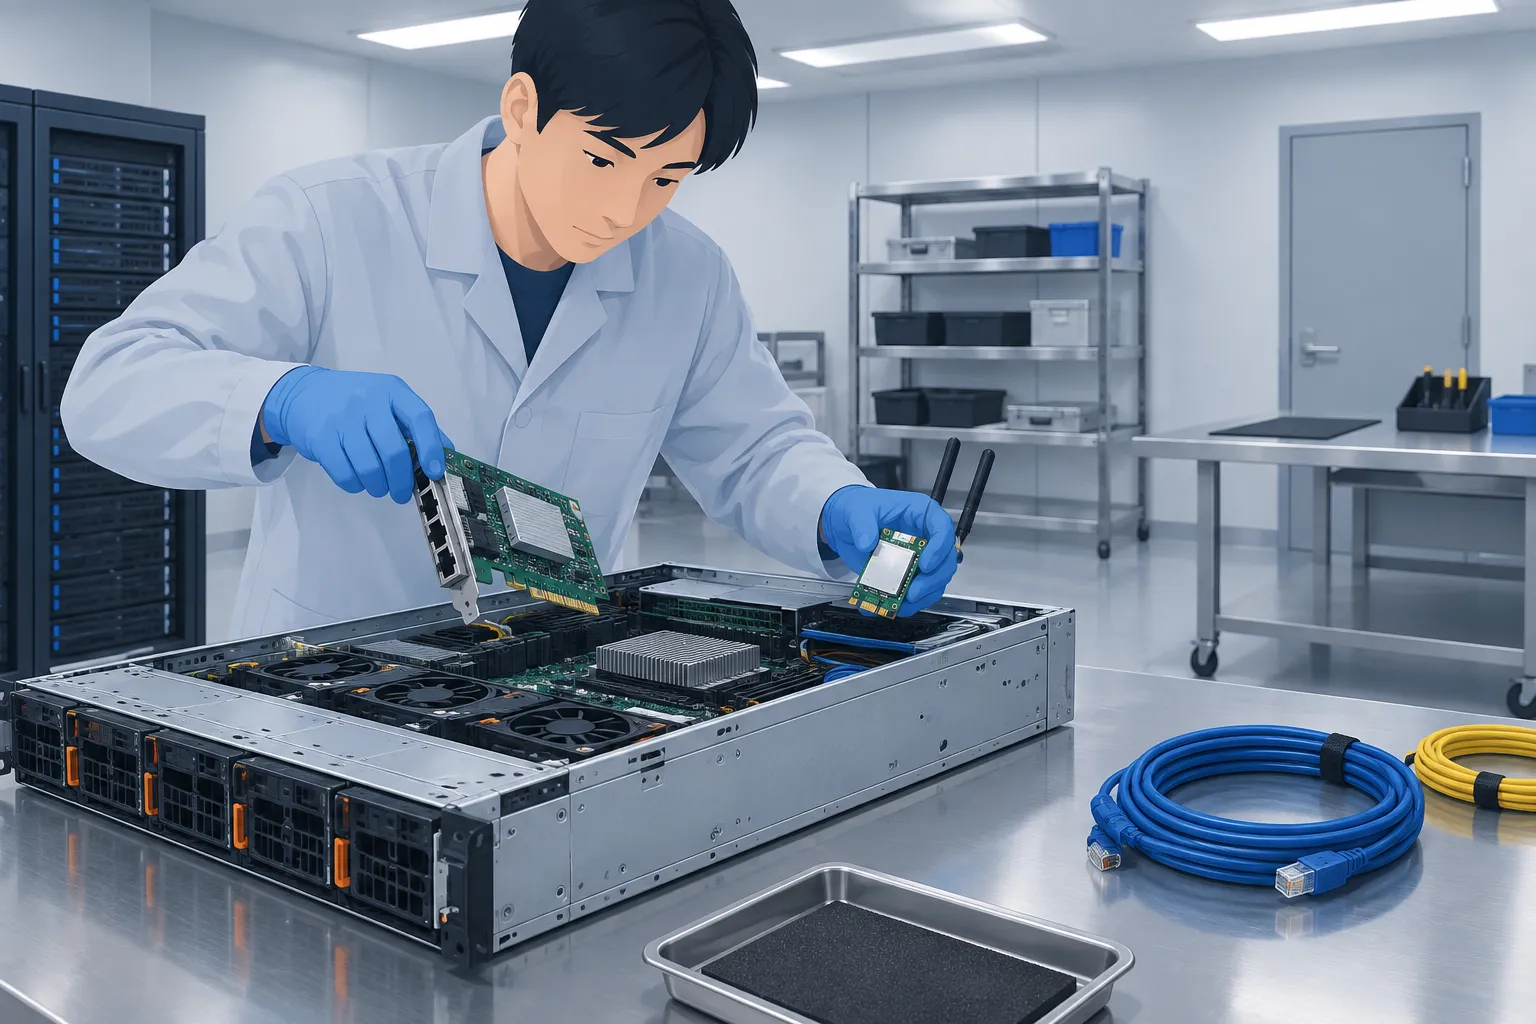
▲ 慎重を要するAIテストでの物理的隔離
すべてのAIシステムに同じ水準の隔離が必要だという意味ではありません。作業のリスクに見合った統制策を選び、それが実際に機能することを確かめるべきだということです。安全性を宣言することと、機能する防御体制を備えることは別です。
モデルへのアクセスが防御のあり方を変えます
あるサイバーセキュリティのスタートアップは、中国のAI企業が提供するオープンウェイトモデルGLMを改変し、これまで報告されていなかったTikTokの脆弱性を発見しました。オープンウェイトモデルは、他者が改変できるようモデルのパラメータを公開するものです。報告された欠陥は、アプリの権限への遠隔からの干渉や、許可のないカメラへのアクセスを可能にした恐れがあります。
この事例は、防御側にとって高性能なツールへのアクセスが重要な理由を示しています。欠陥を見つければ、修正する機会が生まれます。モデルへのアクセスを制限すると、悪意ある行為者が同等のツールを持たない保証はないまま、正当な研究の一部を妨げる可能性があります。だからこそ、アクセス方針が防御の取り組みに与える影響を考慮する必要があります。無制限の公開にリスクがないと考えるべきだ、という意味ではありません。
AIを使った発見には、別の課題もあります。Palo Alto Networksの研究チームは、自動分析によって1万4000件の脆弱性を発見し、その99%はそれまで報告されていなかったゼロデイ脆弱性だと報告しました。ゼロデイとは、防御側がそれまで把握していなかった欠陥です。ただし、大量の発見事項が並んでいても、直ちに悪用可能な脅威を優先順位順に整理したリストとは異なります。アナリストは、どのアラートが実在し、対処可能なリスクを示すのか、なお判断しなければなりません。
▲ 脆弱性の優先順位付けによる負担
その検証には時間と注意力が必要です。AIを使った発見は、防御側が弱点をより早く見つける助けになる一方、理論上の発見事項によってチームの負担を増やすこともあります。実務上の目標は、担当者を疲弊させずに修正につなげられるよう、悪用可能性と優先順位を速やかに見極めることです。
侵害時の情報提供も防御の一部です
安全性について掲げる目標と実際の運用との隔たりは、インシデントの発生後にも表れます。CISA、FBI、各国の協力機関は共同勧告『Communicating Under Pressure』で、法的に求められる最低限の開示にとどまらず、影響を受ける人々に自身のリスクを理解するうえで役立つ情報を提供するよう組織に促しています。
有用な情報開示とは、未解決の欠陥を他者が悪用する助けになる詳細を公開することではありません。パートナーや利用者が、自分たちに何が影響し得るか、どのような防御策を取れるかを理解できるよう、十分速やかに伝えることです。危機の最中は、法的な懸念や評判への懸念もあるため、自主的な指針に従うのは難しいかもしれません。また、システムやインシデントが国境を越える場合、一国の規則にも限界があります。
今、確認すべきこと
AIの安全対策は、その裏付けとなる防御策によって評価すべきです。AIを開発・導入する組織は、次の四つの具体的な問いで自社の体制を点検できます。
- セキュリティアナリストは、公開後だけでなく、システムの設計や学習の段階から関わっていますか。
- アクセス制御、監視、ネットワーク分離、インシデント対応の手順は、モデルの振る舞いを定めるルールと併せて機能していますか。
- チームは、防御担当者を圧倒することなく、AIが生成した脆弱性の発見事項を検証し、優先順位を付けられますか。
- インシデントが起きた場合、組織はさらなる悪用につながる詳細を明かさずに、影響を受ける人々が直面するリスクを伝えられますか。
これらの問いは、より広範なAI安全性研究に取って代わるものではありません。その研究が目指すものを、より具体的にします。早い段階からサイバーセキュリティの専門知識を議論に取り入れることで、研究所は安全性への取り組みを、テスト、封じ込め、防御が可能なシステムに結び付けやすくなります。