AppleはM5 UltraがM3 Ultraより最大4倍高速と主張していますが、ローカルAIのテストにもそれと明確に対応する結果が出ています。大規模言語モデルの中には、旧チップと比べて約4倍早く応答を始めるものがあります。ただし、すべての回答が4倍速く届くわけではありません。モデルが文章を書き始めた後の速度向上は、測定値では通常1.5~1.7倍程度です。Mac Studioの買い替えを検討するなら、単一の速度値より、この二つの段階の違いが重要です。
2台のMac Studioの実行環境
比較には、ディスプレイやキーボードを直接接続しないヘッドレス構成のローカルAIサーバーとして、Mac Studioを使用しました。モデルはインターネット接続やクラウドAPIの呼び出しを使わず、オフラインで動作しました。ユニファイドメモリはM3 Ultraが512GB、M5 Ultraが256GBで、メモリ構成は同一ではありません。
両機ともGPUコアは80基です。M5 Ultraでは各GPUコアにNeural Acceleratorが追加され、メモリとプロセッサーの間でデータが移動する速度を示すメモリ帯域幅も、819 GB/sから1.2 TB/sに高まりました。CPUコアはM3 Ultraの32基に対し、M5 Ultraは36基です。こうしたハードウェアの変更は結果を理解する手がかりになりますが、テストで見られた性能向上はAIタスクの段階によって異なります。
最初のトークンが早くても、文章全体が同じ割合で速くなるわけではない
最初のトークンまでの時間、すなわちTTFTは、モデルがプロンプトを受け取ってから応答を始めるまでの時間です。トークン生成速度は、その後の文章の断片をどれだけ速く出力するかを示します。主要な言語モデルの比較には32,000トークンのプロンプトを使いました。トークンはモデルが処理する文章の単位です。Qwenの各モデルには、重みをコンパクトに保存する4ビット版を使用しました。
| ローカルモデル | 最初のトークン:M5 Ultra対M3 Ultra | 生成速度:M5 Ultra対M3 Ultra |
|---|---|---|
| Qwen3.8 27B、4ビット | 21.66秒 対 82.85秒 | 43.3対28.1トークン/秒 |
| Qwen3 14B、4ビット | 14.43秒 対 57.25秒 | 55.8対32.6トークン/秒 |
| Qwen3.6 35B-A3B、4ビット | 7.25秒 対 17.5秒 | 110.2対73.5トークン/秒 |
| Qwen3.5 122B-A10B、4ビット | 14.58秒 対 46.9秒 | 65.8対43.1トークン/秒 |
| Gemma 4 31B、16ビット | 26.7秒 対 110.4秒 | 13.6対9.0トークン/秒 |
Qwen3 14BのテストはAppleが掲げる4倍という数字に最も近く、最初のトークンまでの待ち時間が57.25秒から14.43秒に短縮されました。ジョン・スチュアート・ミルの*『自由論』*を要約したQwen3.8 27Bのテストでは、この段階が約3.8倍速くなりました。Gemma 4 31Bは最初のトークンの結果で4倍を超えましたが、残りの文章を書く速度の向上は約1.5倍にとどまりました。
長いプロンプトは、最初のトークンが出るまでに多くの処理を要します。一方、応答の生成はより逐次的です。新しいトークンを一つ生成するたびに、システムはユニファイドメモリからモデルの重みを繰り返し読み出す必要があります。このテストでQwen3.8 27Bの重みが占める容量は約15GBです。生成速度の向上が約1.5倍で、最初のトークンの改善幅よりもメモリ帯域幅の増加に近い理由は、これで説明できます。
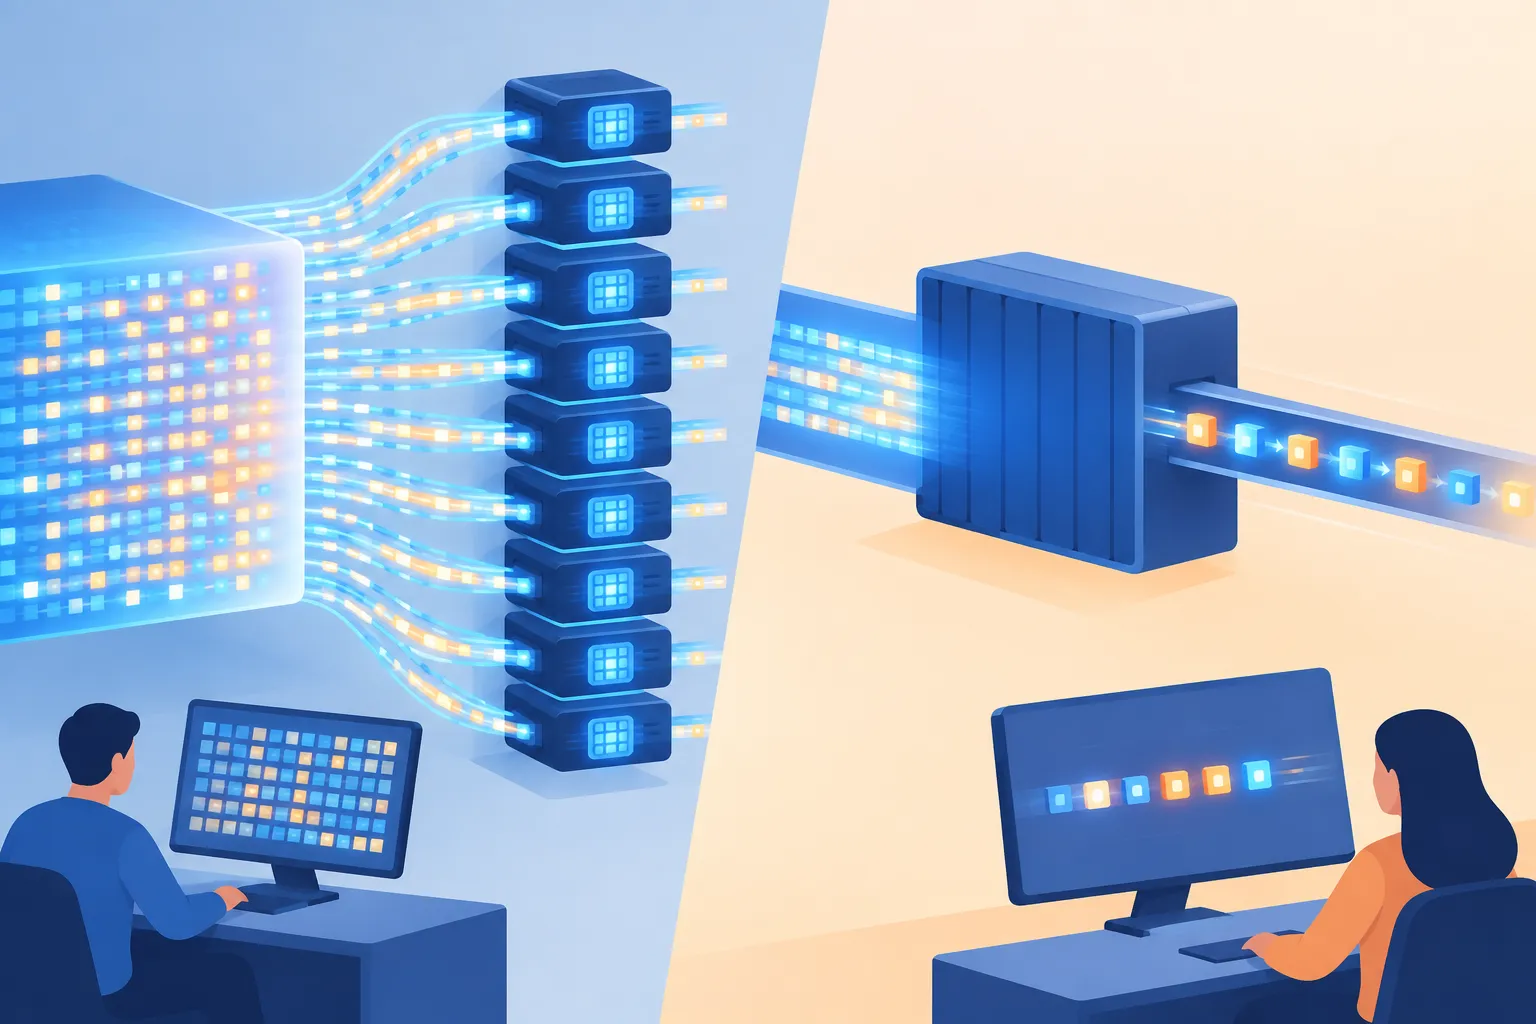
▲ プロンプト処理とトークン生成
実際の使い勝手を左右するのは、出力の長さです。大きな文書を入力して短い答えを求める場合、最初の待ち時間の短縮が体感上の差を大きく左右します。長い回答を求める場合は、継続的な生成速度の比較的小さな改善が重要になります。Qwen3 14Bのテストでは、合計時間が67.9秒から21.6秒に短縮されました。これは両方の段階を合わせた結果であり、タスクのすべての部分が4倍速くなったわけではありません。
音声やメディアの処理では異なる伸び
オフラインで実行したのは言語モデルだけではありません。ローカルでの文字起こし、映像分析、画像生成、動画生成も、伸び幅は異なるものの、すべてM5 Ultraで高速化しました。制作ワークフローを評価するうえでは、単一のLLMベンチマークよりも、こうしたテストのほうが具体的な判断材料になります。
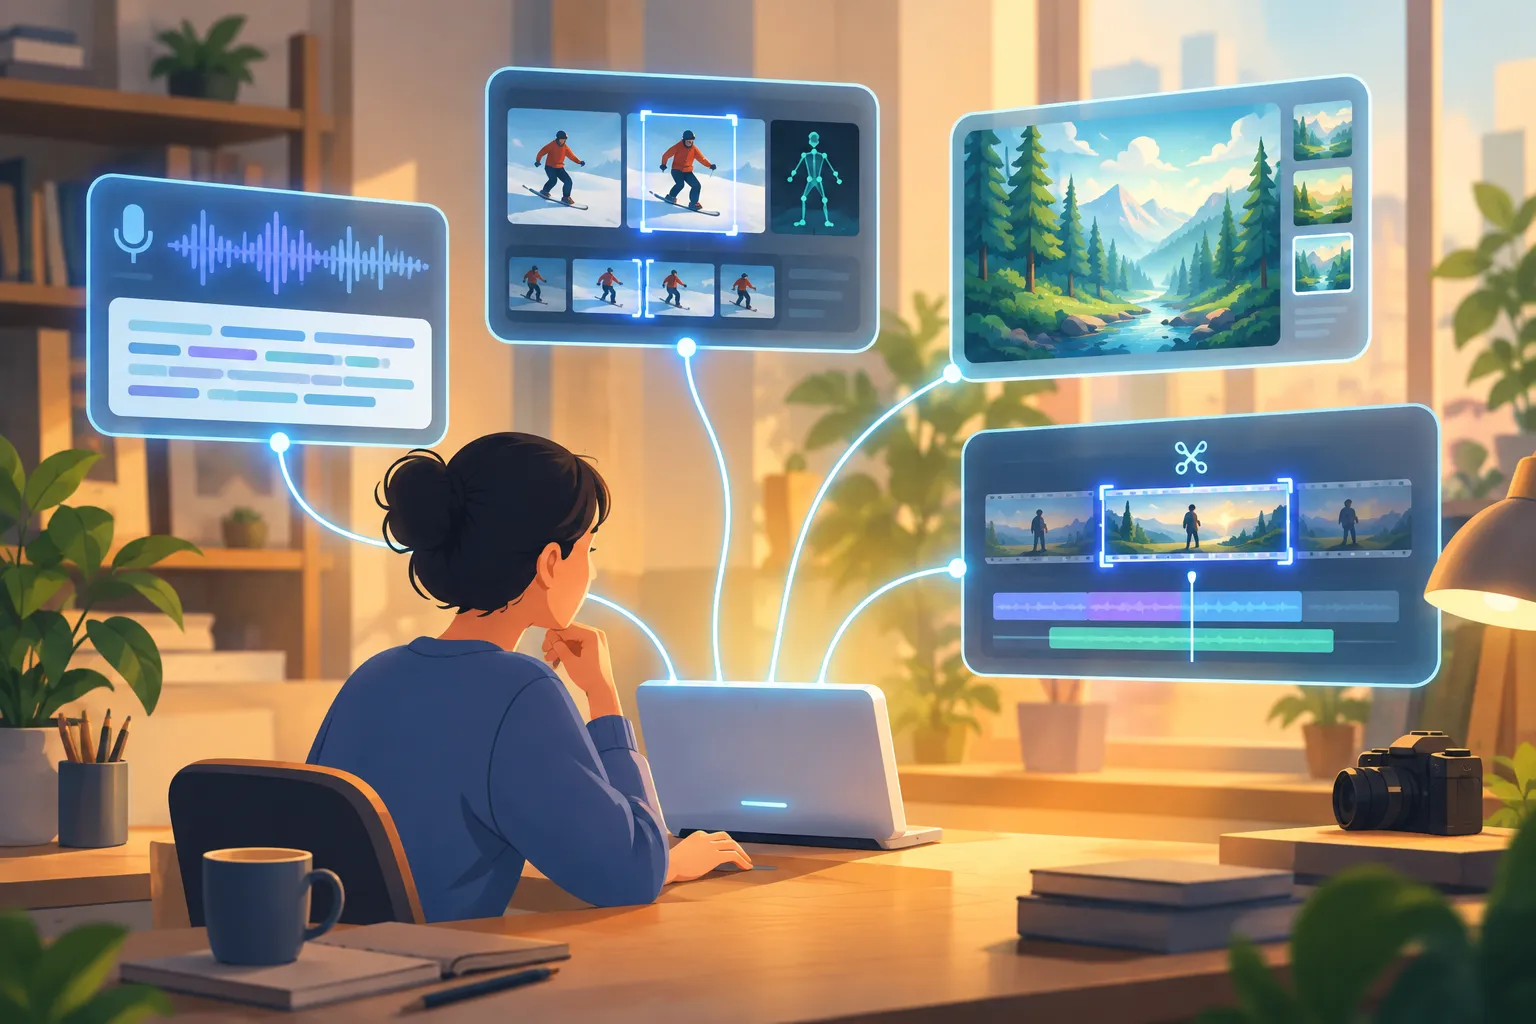
▲ ローカルメディア制作の作業工程
音声の文字起こしでは、Apple Silicon上でモデルを動かすために使用したフレームワーク、MLXを通じてWhisperを実行しました。13.8分の音声サンプルで、Whisper Large-v3の処理時間はM5 Ultraが11.4秒、M3 Ultraが20.2秒でした。Whisper Turboはそれぞれ3.1秒と7.1秒でした。より長い2時間5分の録音でも、同じ傾向が見られました。
| 文字起こしモデル | M5 Ultra | M3 Ultra |
|---|---|---|
| Whisper Large-v3 | 89.4秒 | 152.6秒 |
| Whisper Turbo | 24.4秒 | 56.2秒 |
Turboの速度は、長時間の録音から文字起こしの下書きを作る際に役立つ可能性があります。ただし、これらの処理時間のテストは、どの録音でも文字起こしの品質がLarge-v3と同等であることを示すものではありません。速度と出力品質は別々に検討する必要があります。
映像分析では、Qwen3-VL 32Bが無音の60秒の動画を毎秒1フレームの間隔で処理しました。人物や机の上の物など、映っている細部を特定するまでにかかった時間は、M5 Ultraが22.9秒、M3 Ultraが60.3秒でした。このローカルでの動画ログ作成タスクでは、2.6倍の速度差です。
画像生成では、FLUX.2 klein 4Bが1024×1024ピクセルの森のイラストを生成するのに、M5 Ultraで2.6秒、M3 Ultraで10.2秒かかりました。修正版の写実的な画像では、それぞれ2.2秒と7.0秒でした。LTX-2.5 22Bは画像を入力に使い、短いアニメーション動画をそれぞれ17.5秒と30.2秒で生成しました。より大きな動画では19.9秒と50.5秒でした。結果のばらつきは、あるタスクでの4倍の性能向上が、すべてのローカルAI処理に当てはまるわけではないことを改めて示しています。
自動化と価格の判断
M5 Ultraは、モデルの応答を1回生成するだけではないワークフローにも対応しました。ローカルエージェントはQwen3.8 27Bを使用し、131,131トークンのコンテキストウィンドウ(モデルが一度に参照できる情報量)を設定しました。以前のセッションから得た24,000トークンを超えるパーソナライズされたコンテキストを使い、質問に素早く答えました。これとは別に、300件のテキスト質問を分類するテストでは、M5 Ultraが23.5秒、M3 Ultraが33.4秒で処理を終えました。報告された精度は両機で同じで、スパム検出が91.5%、銀行関連の意図の判定が66%でした。
編集エージェントは、AIシステムが外部ツールを利用するための仕組みであるModel Context Protocol(MCP)を介して、ローカルモデルをDaVinci Resolve Studioに接続しました。文字起こしを読み、言い直しや言いよどみを取り除くため、タイムラインにカットを入れました。自動化によって編集済みの映像はできましたが、プロジェクト全体でカットを計画し、実行するまでには約13分かかりました。モデルの推論が速くなっても、編集ワークフロー全体が瞬時に終わるわけではありません。
テストしたM5 Ultraの構成は、80コアGPU、256GBのユニファイドメモリ、8TBのSSDを備え、価格は$14,299でした。対応できるタスクはオフラインで実行できるため、クラウドAPIの呼び出しは不要です。ただし、この価格はあくまでテストした構成の費用であり、すべてのユーザーがコストを節約できる証拠ではありません。メモリ容量の違いも重要です。特に大きなモデルを動かす購入希望者は、自分に必要な容量をテスト機の256GBと比較すべきであり、速度だけで選択が決まると考えるべきではありません。
買い替えをどう判断するか
M5 Ultraが最も力を発揮するのは、長いプロンプトを使うローカル処理や、メディアを繰り返し処理する作業を頻繁に行う場合です。最初のトークンまでの時間が短くなることで、LLMが応答を始めるまでの待ち時間を大幅に減らせます。また、文字起こしや映像分析の結果からは、大量の処理で時間を節約できる可能性があります。主に長い回答の出力速度を高めたい人は、ここで示した比較的控えめな生成速度の向上を見込むべきです。買い替える前に、必要なメモリ容量に収まるモデルを確認し、自分の作業でプロンプト処理とトークン生成がそれぞれどれだけの時間を占めるかを測定して、短縮できる時間と実際に購入する構成の費用を比べることが重要です。