Google DeepMind针对智能体重新搭建了Gemini API的底层。新的Interactions API通过同一个端点处理快速的模型调用和长时间运行的智能体任务,并可将对话和推理状态保存在谷歌的服务器上,开发者无需再手动拼接。此外,借助Managed Agents,Gemini只需一次API调用就能获得专属的Linux沙箱,即一台用于运行代码的隔离计算机。对于基于Gemini构建智能体的团队而言,此次更新似乎把三项繁琐工作交给了平台:状态管理、执行环境和密钥处理。
旧API为何跟不上
开发者使用语言模型的方式经历了三个阶段。最初是简单的补全:发送“讲个笑话”这样的提示词,得到一段文本。随后,应用程序需要可以稳定使用的输出,于是出现了function calling,即模型返回一个写明函数名和参数的结构化JSON对象。询问纽约市的天气,模型就会返回对天气函数的调用。后端服务器可以像处理包含用户名和密码的注册表单一样处理这份数据。
如今的模型更进一步。它们接收目标,进行推理,使用多种工具,并可能在给出答案前持续工作很长时间。Google DeepMind将智能体描述为以下四个部分的组合:
| 部分 | 作用 |
|---|---|
| 模型推理 | 理解用户意图并决定下一步行动 |
| 工具 | 搜索、代码执行和自定义函数 |
| 上下文与记忆 | 调用短期和长期记忆 |
| 执行环境 | 运行代码和函数的沙箱 |
Google DeepMind的一位开发者体验工程师认为,能力强的模型对脆弱辅助框架的依赖比以前更少。Claude Opus和Claude Haiku等模型往往不需要分别用于读取和编辑文件的工具,而是通过单一的bash工具完成工作。更难的问题在于时间。过去一轮就能结束的任务,如今转到后台运行,例如花三分钟以上开展调研、最终生成长篇报告的深度研究智能体。旧API要求开发者在层层嵌套的JSON中翻找结果,并自行维护对话历史。
一个ID承接对话与推理
Interactions API的核心是可选的服务器端状态管理。每个响应都带有一个interaction ID。在下一次调用中把它作为previous_interaction_id传入,服务器就会恢复此前的对话以及模型内部的推理状态。
这一点之所以重要,是因为thought signature。新近的Gemini模型会把推理过程记录为外部无法解读的编码值,模型要发挥最佳性能,必须在下一轮把这些值传回去。据Google DeepMind介绍,缺少这些值会导致推理质量明显下降。手动重建历史也很脆弱:一个多余的空格变化就可能让服务器缓存失效。只传一个ID,就能消除这一整类问题。
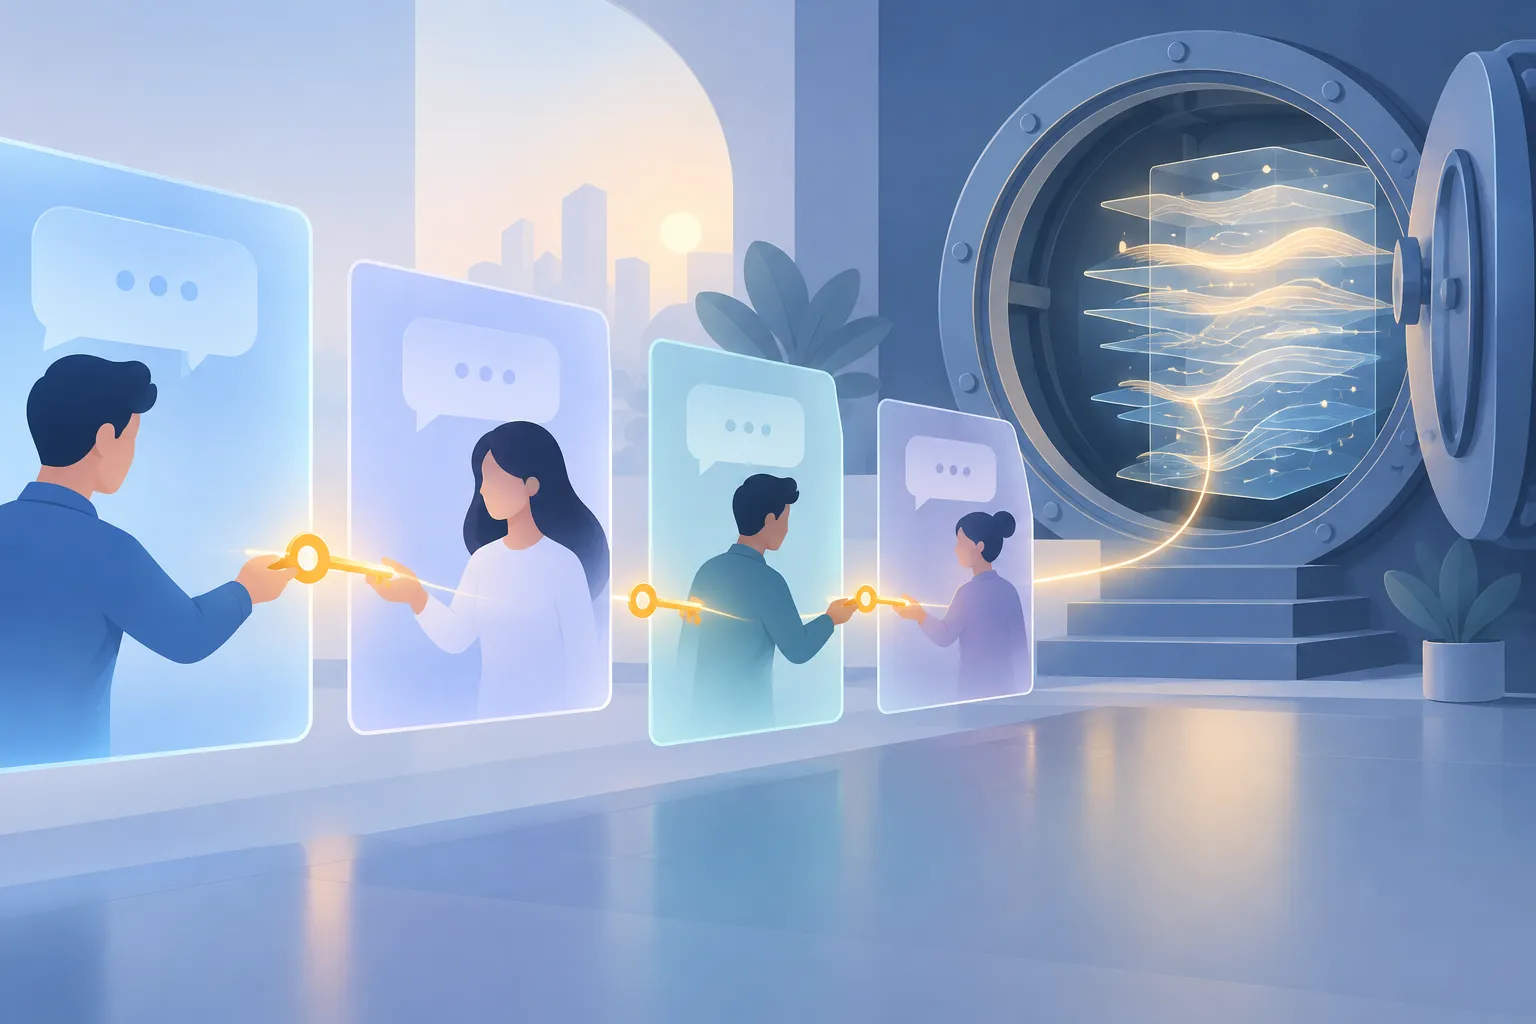
▲ 靠interaction ID延续状态
输出也更加清晰。文本、音频和图像响应都以强类型对象返回,代码可以根据output.type分支处理,而不必硬编码嵌套字典中的路径。切换输出模态,只需修改generation_config和response_modalities等设置。Google DeepMind一位团队成员制作的旅行模拟器就是一例:上传一张人像照片,它会并行生成此人在威尼斯运河、新天鹅堡等地的图像,再沿用interaction ID把第一帧变成动态短片。
工具调用与Steps Data Model
在一次API调用中,Gemini可以判断自己需要了解什么、调用工具并返回答案。借助Google Search和URL上下文工具,它能获取模型训练截止日期之后的网络内容。同一请求还可以包含自定义函数,例如把安全问题登记到内部工单系统的file_incident工具,让智能体一次完成调研和处置。
为记录这类多步骤运行,谷歌用Steps Data Model取代了旧的outputs数组。它以强类型时间线的形式,记录模型在一次交互中所做的一切。
| 要素 | 内容 |
|---|---|
| 步骤类型 | 模型输出、思考、函数调用、Google Search调用等 |
| 状态 | 已完成、等待中、进行中 |
| 结构化字段 | 工具名称、参数和thought signature |
| 内容 | 原始文本、图像、音频和视频 |
Managed Agents把沙箱放到API背后
Managed Agents以远程智能体的方式运行Antigravity,让Gemini在谷歌管理的安全Linux沙箱中自主工作。默认工具包括bash代码执行、文件系统访问、网络搜索、URL上下文和智能体技能。过去,构建编程智能体(即编写并运行代码的智能体)需要自己调校框架,寻找并配置第三方沙箱基础设施,还要想办法保持上下文。现在,一次API调用就能获得可持续保留状态的沙箱。
在一个例子中,智能体接收一个GitHub仓库,将其克隆,列出目录,逐个读取源文件,并在无人干预的情况下写出项目概述。在另一个例子中,它分多轮评估了一份自建编程语言和强化学习循环的黑客松参赛作品,消耗了超过200万个词元(模型处理文本的单位),同时没有丢失沙箱状态。
多轮工作的关键在于保留两个值:
| 值 | 保留的内容 |
|---|---|
| interaction ID | 对话和推理上下文 |
| environment_id | 现有沙箱中的文件和运行状态 |
沙箱可以预先加载Google Cloud Storage存储桶、GitHub仓库,以及配置值或安装脚本等内联文件。
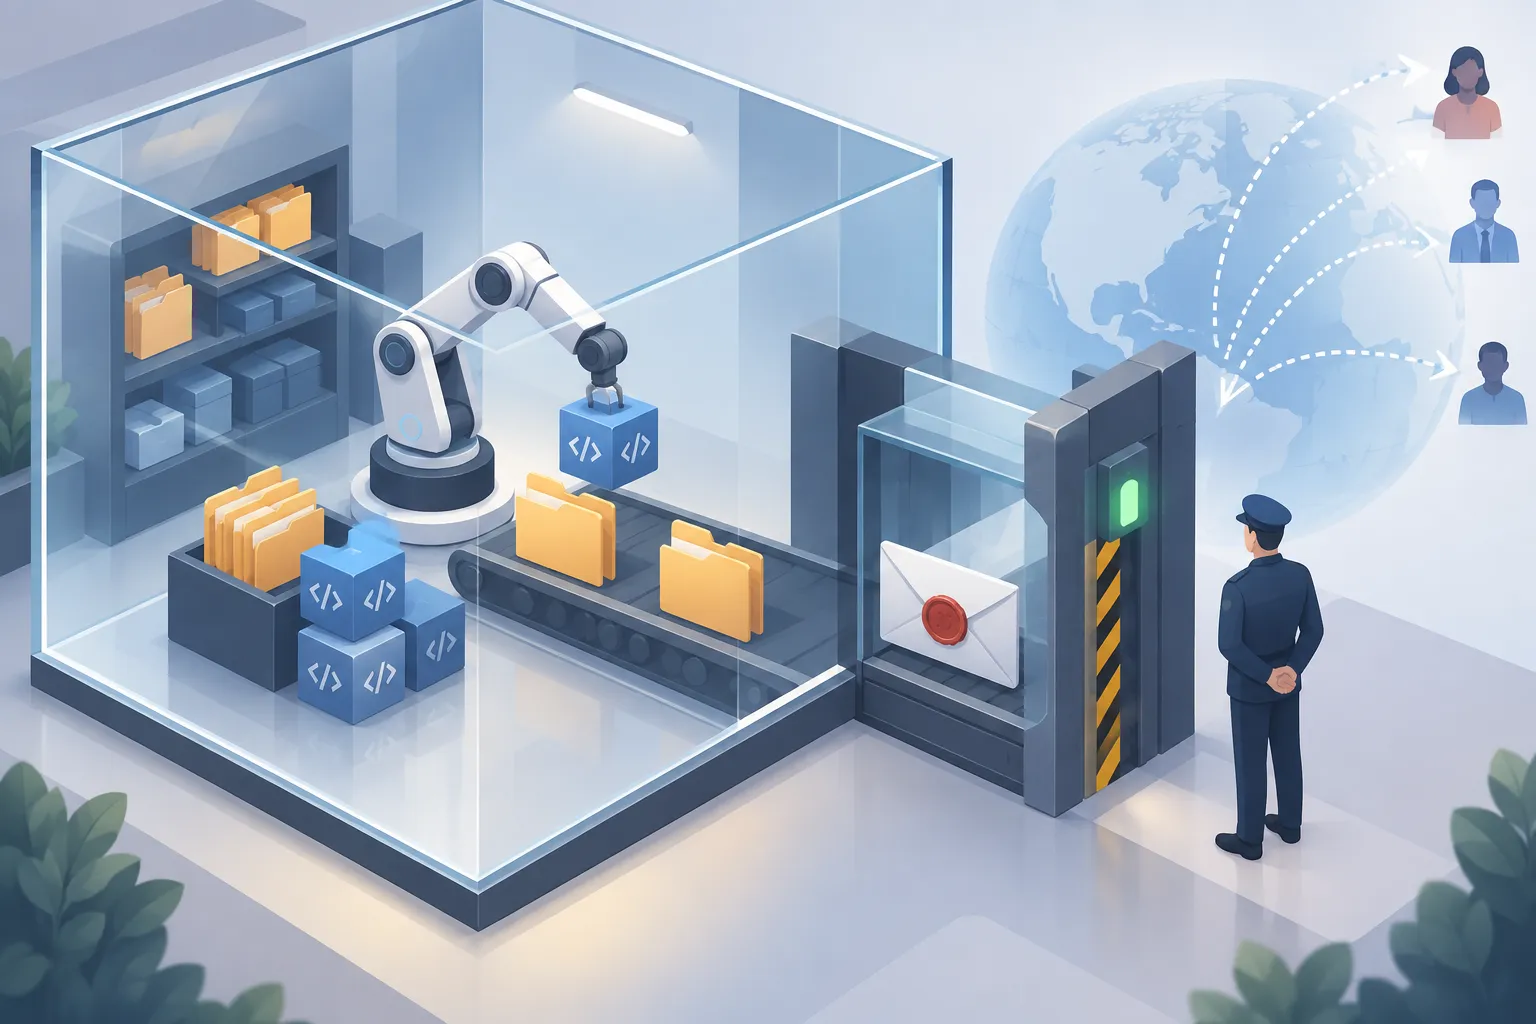
▲ 沙箱与网络代理
网络代理让密钥远离模型
开发者经常询问如何保护智能体免受凭据泄露和提示词注入的威胁。提示词注入是一种把指令藏在模型所读取内容中的攻击。谷歌的应对方式是托管的中间人网络代理。当沙箱中的代码向GitHub API等外部服务发送请求时,代理会拦截请求,并在发出时把授权令牌加入请求头。
模型从不会看到或持有原始密钥。即使攻击者利用提示词注入让模型输出其记忆或环境信息,API密钥也不会泄露,因为它从未出现在模型一侧。与把密钥放进提示词或模型可读取的环境变量相比,这种做法似乎把防线完全移到了模型之外。
命名智能体、CLI和技能仓库
调校好的指令、文件和依赖组合,可以通过两种方式固定为自定义的命名托管智能体:
- 从源定义:编写基础智能体规格,列出所需的技能和配置文件。
- 从快照创建:在沙箱中与智能体对话,安装所需的库,然后保存该环境并为其命名。
每个项目最多可创建1,000个命名智能体。谷歌不对环境存储或空闲沙箱收费,只按模型词元用量计费。
在终端中,开源的Gemini API CLI可以向任意模型发送提示词,并创建、测试和部署智能体。为帮助现有编程智能体迁移到新API,谷歌在GitHub上发布了gemini-skills仓库。模型往往会退回到训练中常见的旧版本代码,例如Gemini 2.0或Gemini 2.5 Flash,因此提供一份描述新API的技能,可以引导它们采用当前的写法。谷歌表示会持续评估这些技能,确保生成的代码符合当前的最佳实践。
Gemini开发者现在该做的调整
Interactions API和Managed Agents看起来是要把状态、基础设施和密钥处理从开发者手中接过去。如果你正在用Gemini构建智能体,以下几点值得检查:
- 不再手动重建多轮历史。把每个响应的interaction ID作为
previous_interaction_id传入,这是保住thought signature最简单的方法。 - 处理多模态响应时检查
output.type,不要硬编码嵌套路径。 - 使用Managed Agents时,同时保存interaction ID和
environment_id,以保留上下文和沙箱。 - 通过网络代理注入API密钥,而不是放进提示词或环境变量。
- 把gemini-skills仓库中的Interactions API技能加入编程智能体,并在固定为命名智能体之前,先用Gemini API CLI进行测试。
如果想免去配置、快速上手,可以在提供免费额度的Google AI Studio中试用这些模型。