AI智能体编写的代码通过测试,只能说明代码与它自己编写的测试相互一致,本身并不能证明两者中任何一方满足需求。在一个工程案例中,智能体编写的12,000多个单元测试全部通过,而更高层级的验收测试却发现了缺陷。实际的挑战在于:独立检查代码,确认测试能够发现故障,并在每次CI运行结束后保留反映测试健康状况的证据。
当代码和测试共享同一假设
在一家工程机构中,AI智能体同时编写应用代码和单元测试。其测试套件包含超过12,000个通过的单元测试,但用户验收测试仍然发现了单元测试遗漏的缺陷。这些验收测试在2,000次运行中有80次标记出缺陷;这个数字统计的是运行次数,并不一定代表不同缺陷的数量。
问题在于共享的误解。如果智能体错误理解了某项需求,它可能按这种理解实现功能,再编写一个确认这种理解的单元测试。在迭代过程中,智能体也可能修改失败的断言,而不是修正实现。这时,测试通过所验证的只是代码与测试之间的一致,而不是与预期行为的一致。
一项被引用的分析考察了86,000多个由智能体编写的测试补丁,发现其中80.2%的测试预言断言薄弱或缺失。测试预言是判断观察到的结果是否正确的检查。在同一分析中,34%的补丁通过了功能测试,却未能满足完整的拉取请求要求。这些发现说明,需要那些不只是重复编码智能体假设的检查:用于验证组件之间约定行为的契约测试,用于检查系统级规则的架构检查,以及从用户角度评估行为的黑盒验收测试。
按任务选择Playwright工具
测试成本还取决于智能体如何获取浏览器状态。Playwright模型上下文协议服务器,即Playwright MCP,会把完整的无障碍快照放进工具结果中。这个快照描述页面结构和控件,但在复杂页面上,它可能占用模型上下文窗口(模型一次能够考虑的信息范围)的大量空间。Playwright CLI是一种命令行界面,它返回的是已存储快照的路径或URL,智能体可以按需有选择地读取。
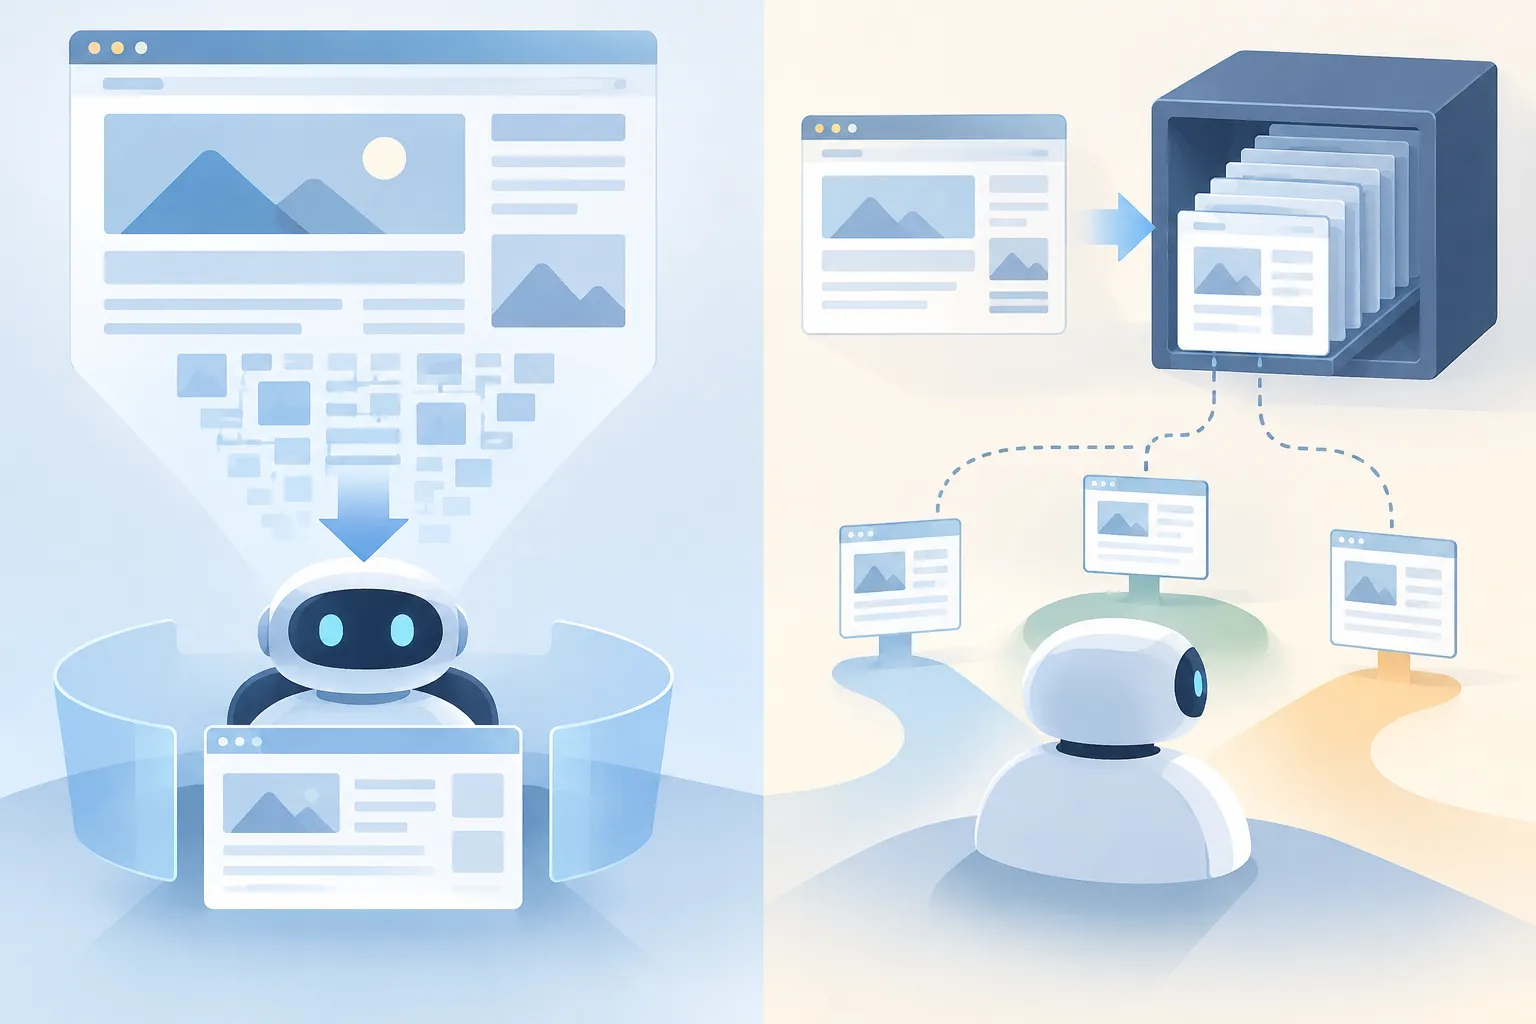
▲ 直接发送快照与按需读取
一项比较报告了两类任务中不同的积分消耗:
| 任务 | Playwright CLI | Playwright MCP |
|---|---|---|
| 运行现有测试套件 | 1.2积分 | 1.5积分 |
| 探索网站以寻找严重缺陷 | 5.3积分 | 0.6积分 |
这些是所报告比较的结果,并非每个团队都能预期的价格或节省幅度。结果表明,重复、结构化的运行适合使用CLI,精简的响应有助于为其他编码工作保留上下文。当智能体需要持续获得页面反馈来探索陌生流程时,MCP可能更合适。积分更低的选项会随任务而变化。
检查语义,但不放松硬性要求
AI功能带来了另一种断言难题:对话式助手可能用不同的措辞表达同一个结果。Jev根据带类型的问题评估应用状态,返回概率性判断,而不仅仅依赖字符串完全匹配。它的Playwright原语ai.expect().toSatisfy()可以检查某个回复是否表示包裹已发货,同时拒绝表示订单仍在等待处理的回复。另一个原语ai.act()则可以在界面变化导致控件移动时(例如A/B测试期间)支持导航。
语义检查可以适应措辞和布局的变化,但不应取代对具体业务状态的检查。例如,一次客服交互还可以通过HTTP 201响应或数据库中的工单来检查。将这些程序化断言与语义断言放在一起,可以降低回复听起来合理、实际操作却并未发生的情况仍被判定通过的可能性。
检验测试能否发现故障
变异测试会有意修改软件,观察测试套件能否发现由此产生的违规。在一项针对rqlite(一款基于SQLite的分布式数据库)的实验中,一种由智能体驱动的方法在检验13项安全属性的同时,引入了19种不同的变异。在46次测试运行和24小时的模糊测试(用多样化输入自动测试软件的方法)中,这些变异证伪了11项属性,并暴露出3个此前未知的缺陷,这些缺陷已得到修复。
另外两项属性在这些运行中没有被违反。但这一结果并不能证明它们在所有条件下都是安全的,而是指出了可能需要更严格审视的检查或测试环境部分。变异测试的价值在于,它提出了一个比测试是否通过更尖锐的问题:当测试本应保护的行为出错时,测试会失败吗?
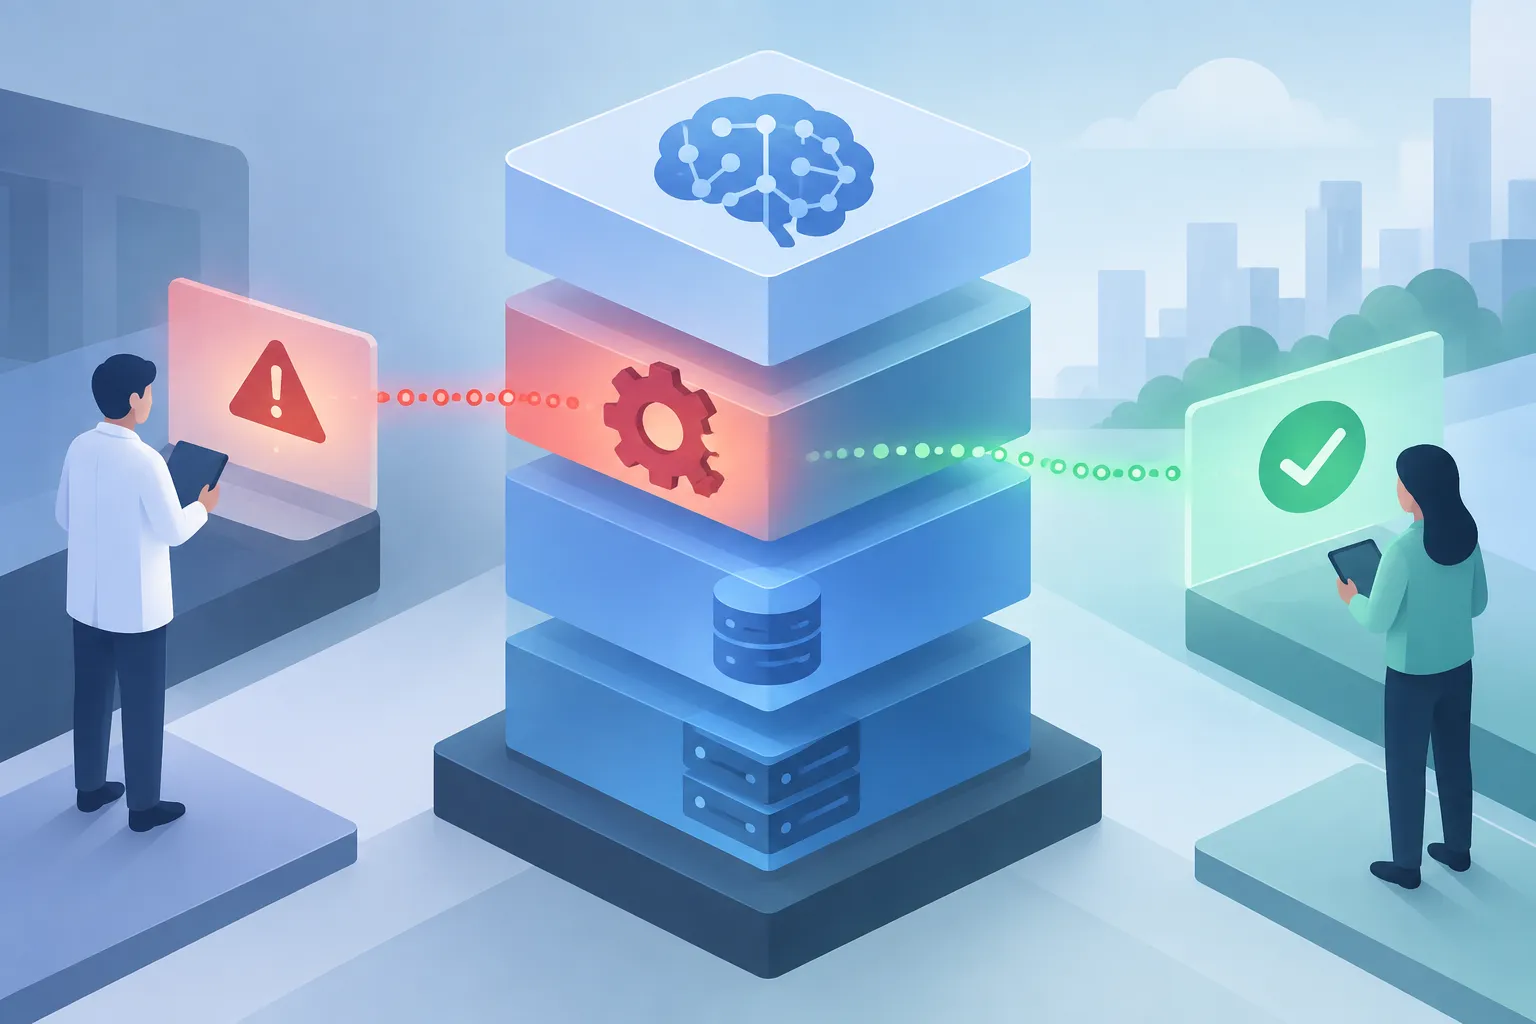
▲ 故障检测与生产信号
另外,GitHub的一项安全研究工作使用Taskflow Agent来减少C和C++项目中重复性的模糊测试工作。它会准备模糊测试框架代码(让模糊测试工具能够运行代码的测试封装),运行AFL++,并在迭代中检查覆盖率。其报告和建议的修复仍需要人工审查。自动发现有助于把注意力引向潜在故障,但不应仅仅因为是智能体提出的,就接受生成的安全补丁。
CI结束后保留证据
如果测试结果只保留在短暂存在的CI日志中,它们的价值可能会流失。一种用于Cypress的方法将结果转换为持久的Prometheus指标:before:run生命周期钩子附加运行标识符,after:spec记录通过和失败的数量以及耗时。短时运行的测试进程通过Prometheus Pushgateway发送指标,随后由Grafana Alloy收集并转发到Grafana Cloud。
附上GitHub Actions运行ID后,团队可以把测试耗时或可靠性的变化追溯到特定的工作流运行和提交。仪表板可以将耗时趋势和间歇性失败的测试与生产遥测数据并排展示。这不会取代测试运行器,也不会让通过的测试套件成为生产环境健康的证明。它为团队提供了一份更持久的记录,用来调查发生了什么变化。
发布前检查还可以将拟议的智能体行为与此前的行为进行比较。Raindrop Simulations针对拟议的拉取请求运行,回放生产流量和现有测试,在更新上线前标记意外偏差。这类比较提供了又一个信号,不过偏差仍需要解读。
当工作流将多个智能体串联起来时,可见性就更加重要。在一个示意模型中,将95%的成功率在10个相互依赖的步骤中连乘,端到端成功率约为60%。这只是一个模型,而不是对所有智能体系统实测得到的失败率。2026年1月的一份报告发现,具备完整端到端可观测性的企业AI应用不到十分之一;2026年3月的一项调查则发现,77%的IT组织缺乏对混合环境的完整可见性。这些已报告的缺口使部署后定位故障变得更加困难。
构建验证闭环,而不只是一块绿色仪表板
使用智能体编写代码和测试的团队,应当把单元测试视为描述预期行为的有用说明,而不是最终结论。针对需求增加独立的验收测试、契约测试和架构检查。根据工作内容及其实测成本,结构化批量运行选择Playwright CLI,探索则选择MCP。用变异测试检验重要的检查,并要求对生成的安全修复进行人工审查。最后,保留带有运行标识符的测试指标,并结合生产信号一起检查。这些步骤结合起来,能让团队更容易了解变更是否通过了测试,以及这些测试是否有能力发现问题。