一家为客户运营基础设施的平台工程初创公司,借助AI智能体把两项常被割裂的工作连接起来:调查运维数据,以及修改产生这些数据的基础设施。智能体可以检索Elasticsearch日志,查看指标和集群配置,再通过拉取请求提出修复方案。这一设计旨在降低可观测性成本,同时不放弃工程师理解故障所需的信息,并让提出的变更始终接受审查。
数据分开存放,调查不被割裂
该公司为客户运行专用的Kubernetes集群;Kubernetes是管理容器化应用的平台。若用一体化的商业服务监控大量相互隔离的集群,据该公司估算,每年费用将达到$30万以上。这一数字描述的是其自身的预估情况,并非通用的节省估算。
因此,该公司将遥测数据的采集、存储和可视化拆分开来。遥测数据指日志和性能测量值等运维信号。VictoriaMetrics负责存储指标,Elasticsearch提供可检索的日志存储。指标采集使用vmagent,日志汇聚使用Filebeat和Logstash,OpenTelemetry则是另一种采集选择。Grafana负责可视化和告警。在云端和内部环境中,该公司共管理约12个Elasticsearch集群,以及数量相当的VictoriaMetrics部署。
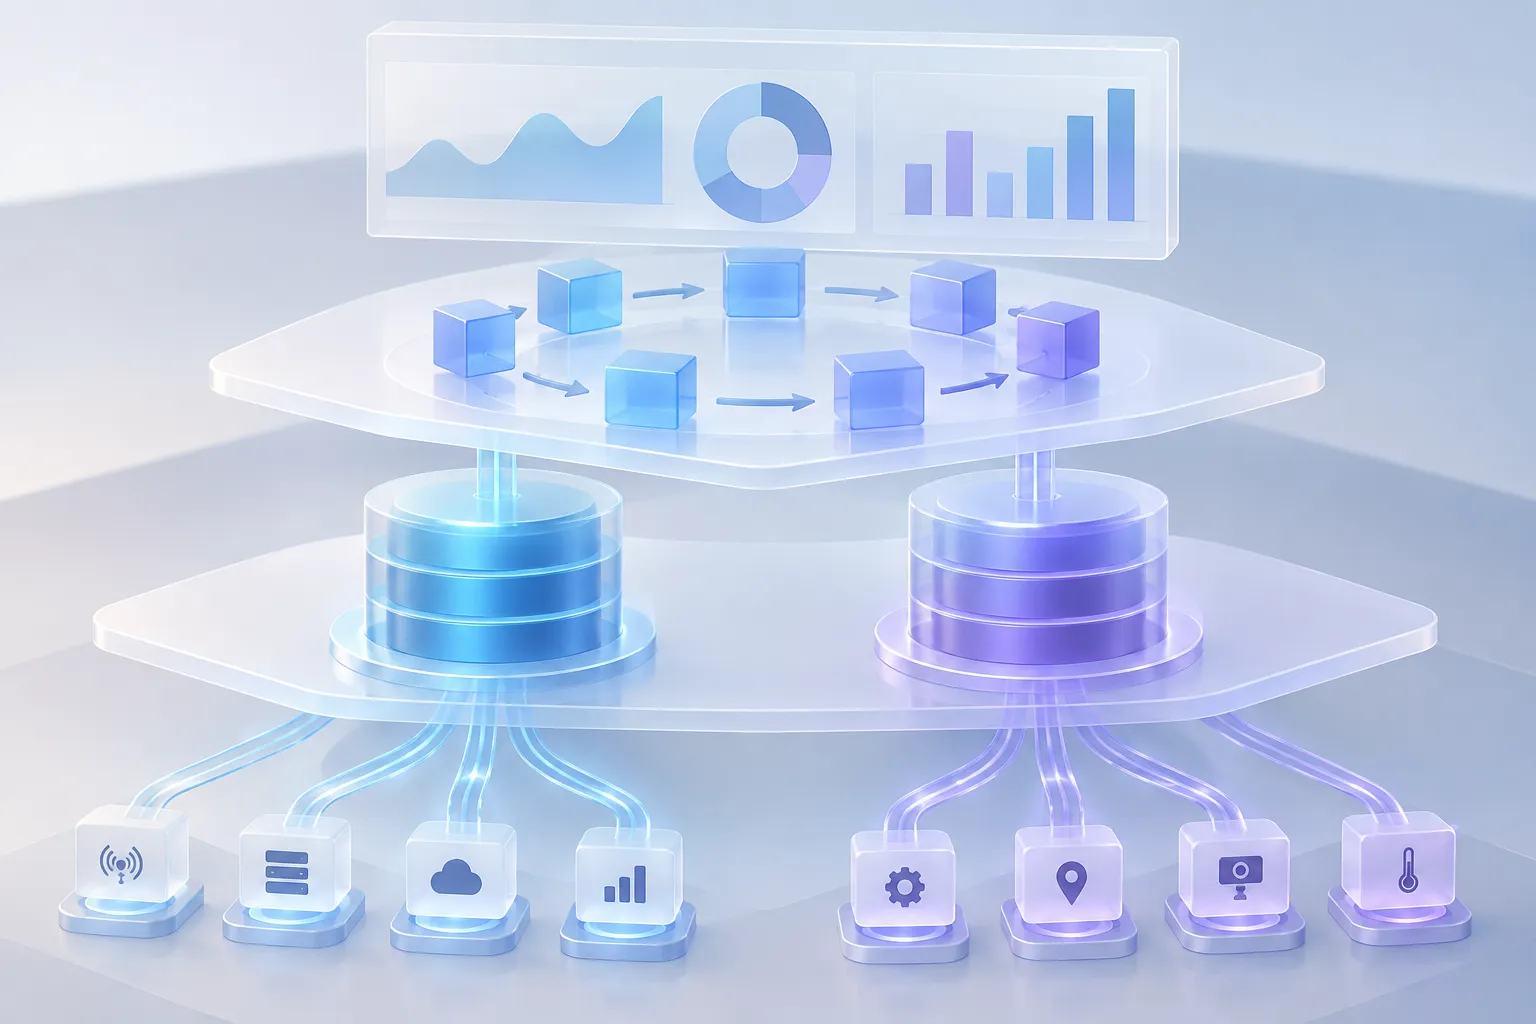
▲ 分离的数据存储与均衡索引
拆分这些组件,并不意味着每位工程师都不再需要仪表盘。界面不够完善,也可能让团队更难用好数据。该公司的做法是让智能体直接查询底层数据存储并给出结论,同时保留供人查看的图表。潜在的成本优势取决于能否保留有用的日志和指标,而不仅仅是替换仪表盘。
在智能体改动之前,先让Elasticsearch保持可预期
自动化管理需要Elasticsearch具备稳定的基础。索引是一组可检索的记录,分片则是分布在集群中的索引片段。该公司使用Index Lifecycle Management(ILM),在分片过大或过旧之前把日志滚动到新索引。在一个示例策略中,主分片最大达到50GB或索引存在满7天时即触发滚动,超过30天的旧索引会被删除。这些是该案例中的策略设置,并非通用目标。保持分片大小可预期,有助于避免负载不均和紧急重建索引。
集群本身则使用Elastic Cloud on Kubernetes(ECK),这是一个自动化管理Elasticsearch的Operator。Kubernetes的Custom Resource Definition(CRD)以Operator可以执行的形式,描述节点组、存储、版本和配置。ECK负责滚动升级、证书生成、节点扩缩容和存储扩容等任务。
CRD也为智能体提供了一个明确的变更提议位置。在GitOps模式下,基础设施配置存放在Git中,每次修改在生效前都可以通过拉取请求留下记录并接受审查。这对有状态的数据存储尤为重要:增加节点或重启节点可能导致分片迁移,进而影响服务。简单、频繁的基于阈值的扩缩容,无法替代对容量和集群状态的审视。
从容量信号到存储变更提议
该公司的智能体工作平台可以定期执行集群审计。在一个工作流中,每周运行的任务分别指派可观测性智能体和基础设施智能体检查Elasticsearch容量。可观测性智能体查询Prometheus指标,包括CPU使用量和文件系统可用空间,并展示相应趋势。基础设施智能体则检查Kubernetes资源和GitOps配置。两方面信息结合后,智能体就能对比集群的实际运行情况与配置所申请的资源。
该工作流分为四个阶段:
- 执行定期审计,收集指标和集群状态。
- 将容量趋势与当前的Elasticsearch配置进行对比。
- 如确有必要变更,准备GitOps拉取请求。
- 经批准并应用后,由ECK使集群与更新后的定义保持一致。
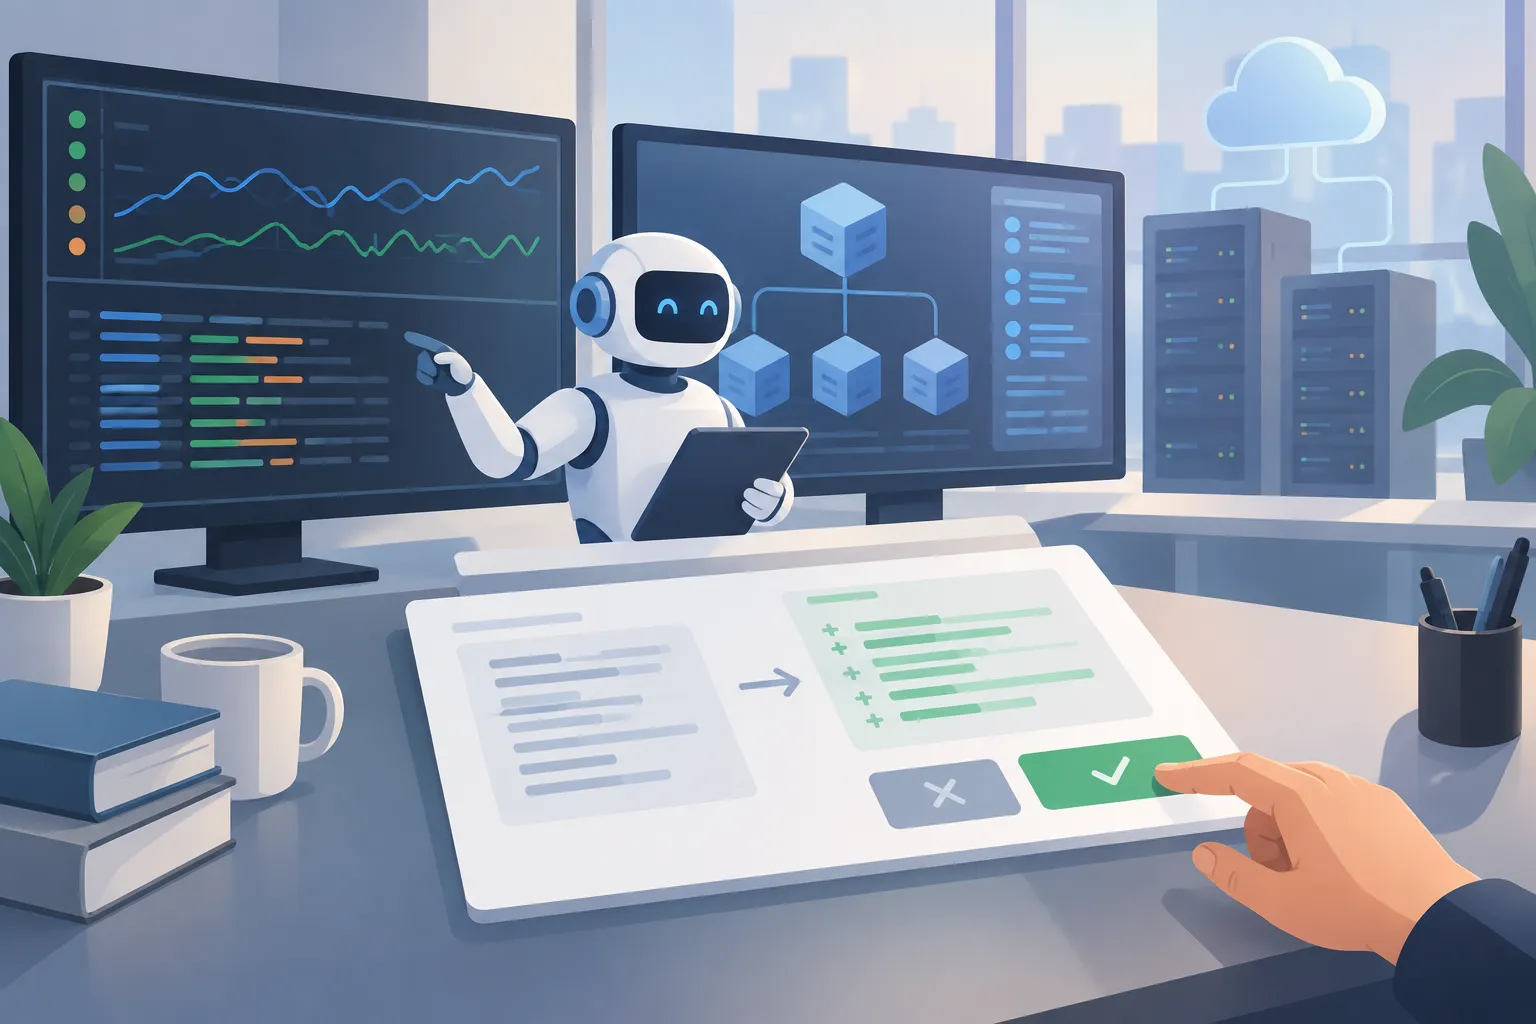
▲ 等待人工审查的智能体提议
其中一个结果说明,提出建议与自动修改是两回事。尽管图表显示可用磁盘空间在下降,智能体最初仍判断磁盘容量和分片数量不足以支持扩容,因此没有创建拉取请求。随后,一条明确的指令推翻了这一评估。智能体据此在GitHub拉取请求中提出,将3个Elasticsearch节点各自申请的存储从500Gi提高到550Gi,合计增加150Gi。这一变更是在指令推翻原判断后提出的,并不表明最初的评估认为需要扩容。
故障处理沿用同一条证据路径
日志与基础设施之间的这种关联,同样适用于应用故障。针对一条HTTP 500错误增多的告警,智能体检查了指标和Kubernetes状态,检索了Elasticsearch日志,并审查了应用代码。它将错误追溯到一个FastAPI端点中间歇出现的异常,随后准备了包含代码修复和回归测试的GitHub拉取请求。整个调查从症状出发,找到相关日志,再到提出修复方案,无需有人逐条手动编写查询。
告警可以通过Webhook触发这类任务,调查结果可以在专门的Slack故障频道中共享。这让工作流不再局限于定期的集群维护,但检查证据、审查拟议变更的必要性并不会因此消失。
智能体的权限应比任务清单更窄
即使编排服务托管在云端,该公司也会让编码智能体在客户Kubernetes集群内隔离的Pod中运行。这一安排旨在把内部日志、遥测数据和凭证留在客户环境之内。智能体的操作还会继承发起请求的用户身份,并经过一个执行基于角色的访问控制(RBAC)的Kubernetes代理。
部分可观测性工具无法对每项指标进行细粒度的权限检查。因此,该公司使用以策略语言Rego编写的Open Policy Agent(OPA)规则,逐一检查工具调用。规则可以拒绝调用,也可以要求人工批准。默认情况下,读取操作可以自主进行,而写入操作需要通过拉取请求或平台上的确认获得签批。SOC 2等合规框架同样要求代码变更在进入生产环境前获得人工批准。
要点总结
这一做法把采集、可检索数据、智能体分析和集群管理串联起来,而不是把日志检索当作调查的终点。考虑采用类似工作流的团队,应先确保索引滚动和集群配置可靠,再让智能体同时访问遥测数据和相关的基础设施定义。要让每项建议背后的依据清晰可见,并确保拟议的写入操作在进入生产环境前都经过人工审查。