RunPod Flashを使うと、独自のDockerfileを書かずにPythonのモデルコードをデプロイでき、アイドル状態のGPUワーカーを停止できるため、画像生成サービスの運用コストを下げられる可能性があります。ただし、「$1で画像3,000枚」という目立つ試算は、ウォーム状態のワーカーが途切れないトラフィックを処理する場合の数字です。リクエストの間隔が大きく空くサービスでは画像1枚あたりのGPU時間が増えることがあり、さらにストレージやアプリケーションのロジック、2枚の画像を生成するユーザー体験には、画像1枚のベンチマークでは捉えられないコストがかかります。
画像1枚あたりの試算が示すもの
比較対象の商用ホスト型画像APIは、画像1枚あたり約$0.03 ~ $0.04、$1でおよそ25枚という価格です。RunPod Serverlessの試算は、NVIDIA RTX 4090またはAda Generationのカードを使う24GBのGPU区分で、フレックス料金はGPU1時間あたり$1.10です。この料金を3,600で割ると、課金1秒あたり約$0.0003になります。
6回のベンチマークで、SDXL-Turboは512×512の画像を推論ステップ2回で生成し、ウォーム状態のリクエスト全体の時間は1.10秒でした。推論ステップとは、モデルが画像を生成する過程の1回分の処理を指します。実際のGPU実行は297ミリ秒で、キューイング、ディスパッチ、画像のBase64シリアライズに約800ミリ秒かかりました。Base64シリアライズとは、画像データをテキストベースのレスポンスで送れる形式に変換する処理です。
| トラフィックのシナリオ | 試算に使う時間 | 画像1枚あたりのGPUコスト(概算) | $1あたりの画像数(概算) |
|---|---|---|---|
| ウォーム状態のワーカーへの途切れないリクエスト | 課金1.1秒 | $0.00033 | 3,000 |
| 後続のアイドル時間を伴うまばらなリクエスト | 課金7秒 | $0.002 | 500 |
| 商用ホスト型API | 画像1枚ごとのAPI料金 | $0.03 ~ $0.04 | 25 |
ウォーム時の数字は、1.1秒に1秒あたり約$0.0003を掛けたものです。まばらな場合の数字は、単発のリクエストの前後で6〜7秒の後続アイドル時間が課金されると想定しています。どちらの数字も、SaaS製品を運用するための総コストではありません。
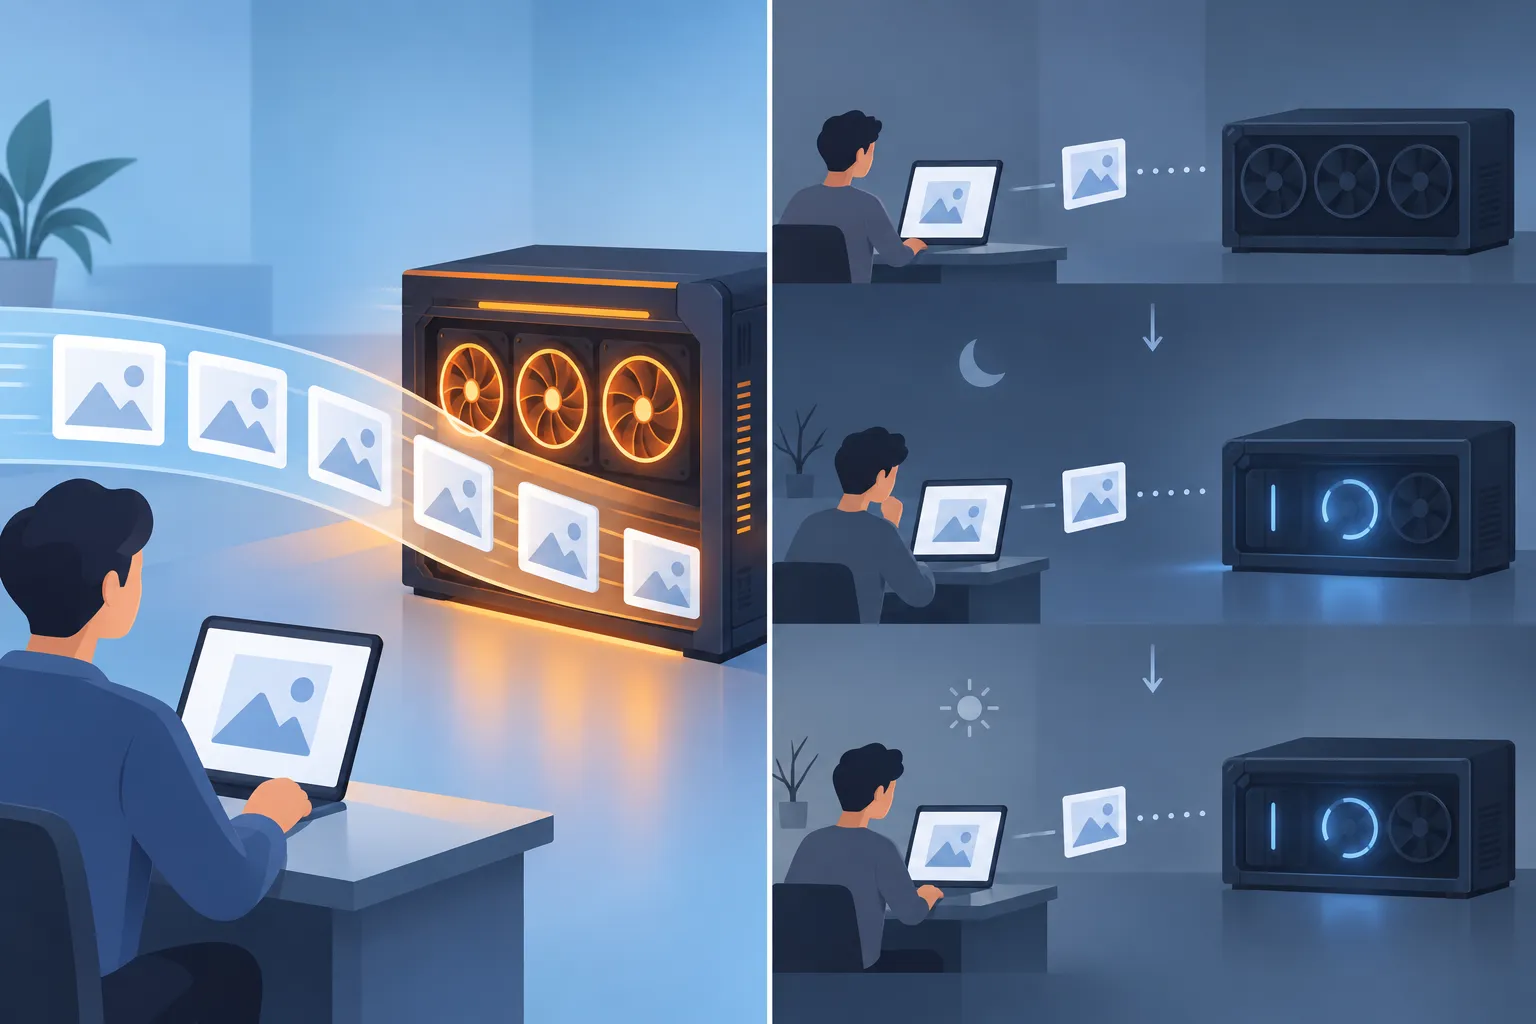
▲ ウォーム時と単発の画像リクエスト
ウォーム時とコールド時の挙動の差は、GPU料金と同じくらい重要です。計測したコールドスタートは、モデルの重みをメモリに読み込む15秒を含めて全体で67秒かかり、GPU実行時間は297ミリ秒のままでした。モデルの重みとは、システムが画像を生成する前に必要とする保存済みのパラメーターです。例に挙げたワーカー設定では、ワーカーが停止するまでウォーム状態を保つ時間を決めるアイドルタイムアウトも300秒に設定されています。そのため、7秒というまばらなトラフィックの計算は料金のシナリオとして読むべきであり、この設定での各リクエストの実測請求額ではありません。
Dockerイメージを管理せずにモデルをデプロイする
RunPod Flashは、Pythonのクラスをサーバーレスのエンドポイント、つまり生成リクエストを受け付けるサービスのアドレスとしてGPU上にパッケージ化します。コード上でクラスに付ける目印である@endpointデコレーターで、GPUの選択肢、依存関係、スケーリングの上限、アイドルタイムアウトを指定します。開発者がDockerfileを書き、CUDAのコンポーネントを合わせ、大きなコンテナイメージを繰り返しプッシュしなくても、コンテナのパッケージ化はRunPodが担います。
この例のSDXL-Turboワーカーは、40行に満たないPythonコードです。ワーカー数は0から5の範囲で動きます。最小値を0にすると、サービスをゼロまでスケールダウンでき、不要になったGPUワーカーを停止できます。最大値の5は同時に動くワーカー数の上限です。この設定により、アイドル状態のまま動き続ける24GBのGPUにかかる月額$800近くと試算されるコストを避けられます。一方で、後から来たリクエストは、ワーカーが起動してモデルを読み込む間のコールドスタートに直面する可能性があります。
モデルのパイプラインは、リクエストごとのハンドラーではなく、ワーカーの起動時に実行されるクラスの__init__メソッドで読み込みます。これにより、約15秒かかる重みの読み込みは、生成のたびではなくワーカーの起動時に一度だけ行われます。アプリケーションのセットアップでは、uvで環境を作って依存関係を同期し、flash loginで認証し、flash devでローカルの開発用プロキシをリモートのGPUに接続し、flash deployでエンドポイントを公開します。開発時の呼び出しはコールドスタートとして扱われるため、ウォーム時のベンチマークの根拠には向きません。
ハードウェアの選択はトレードオフのままです。互換性のあるGPUのリストを指定すると割り当ての遅れを減らせますが、テストでは、Blackwell MIGスライス(GPUの一部を独立したインスタンスとして割り当てたもの)での推論がNVIDIA RTX 4090より1.8倍遅いことがわかりました。特定のGPUに固定すればレイテンシーの予測しやすさが優先され、代替を許せば可用性が優先されます。
WebサービスにはGPU以外も必要
このアプリケーションは、画像のプロンプトごとに2つのオープンウェイトモデルへ同時にリクエストを送ります。24GBのGPUで2ステップのSDXL-Turboと、48GBのGPUで4ステップのFLUX.1-schnellです。先に完成した画像が早めのプレビューとなり、もう一方のリクエストは処理を続けます。Cloudflare WorkerがHono APIと、ViteでビルドしたシングルページアプリケーションのReactを配信し、画像生成はGPUエンドポイントが担います。
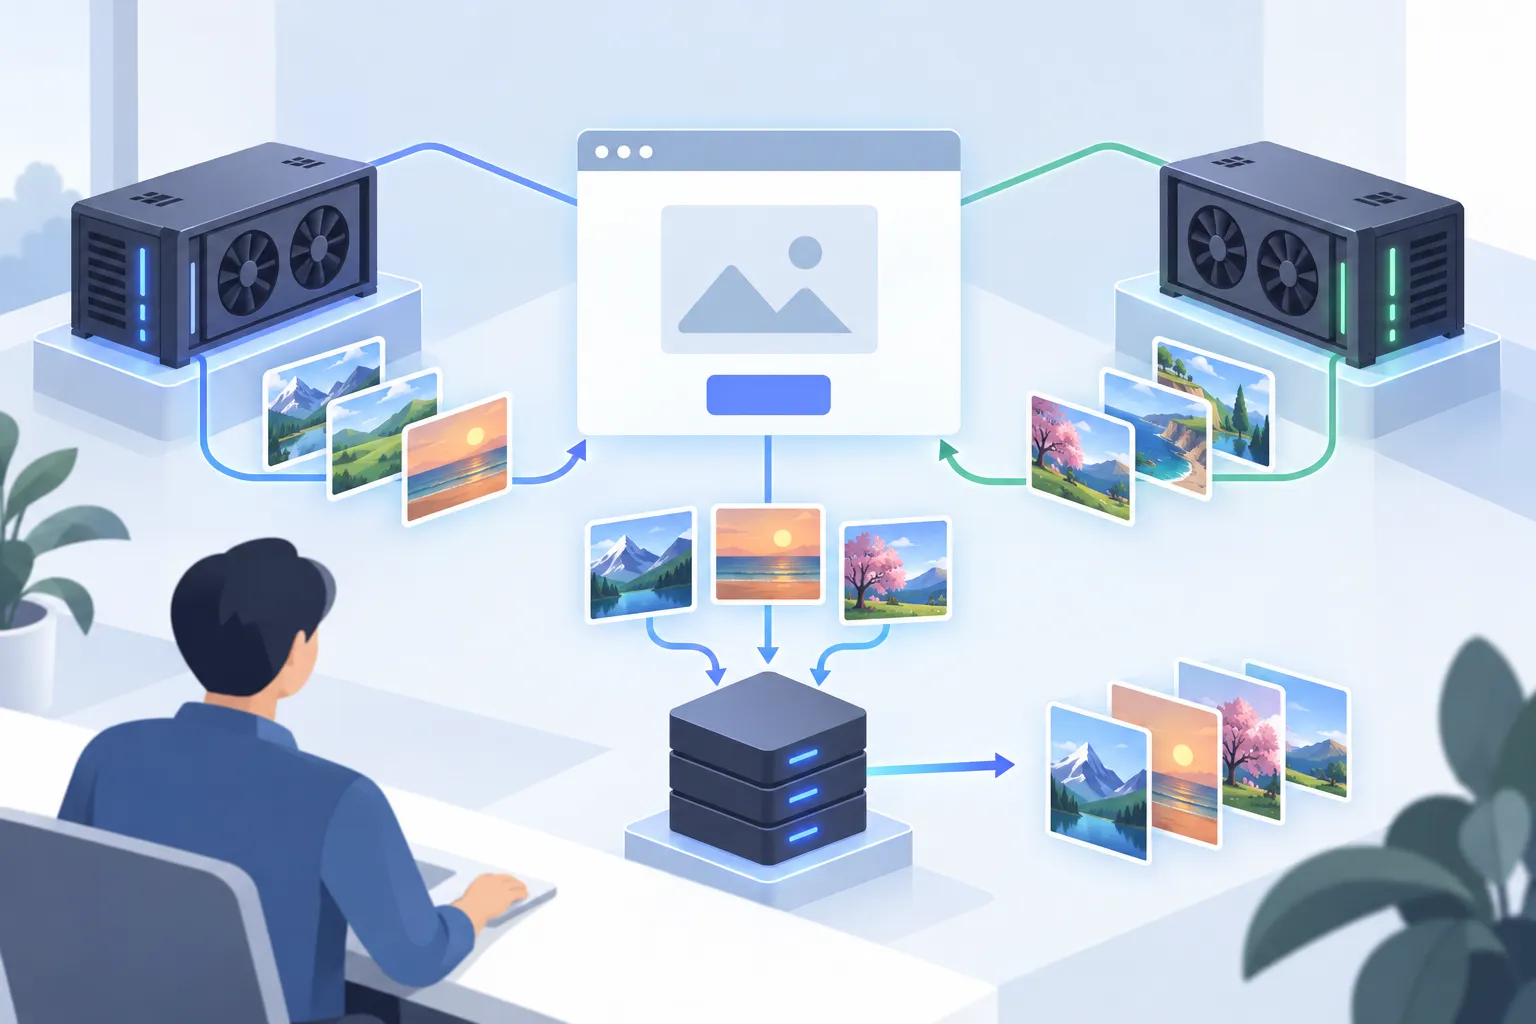
▲ 2モデル構成の画像サービス
生成した画像はCloudflare R2のオブジェクトストレージに保存され、この構成ではデータ転送(egress)料金がかかりません。サーバーレスのSQLiteデータベースであるCloudflare D1には、アカウント、セッション、対戦履歴、クレジットの記録を保存します。ユーザーが投票するまでモデルの名前はサーバー側で保持するため、最初のレスポンスではどちらの選択肢をどのモデルが生成したかはわかりません。
画像1枚あたりのGPU計算に含まれないコストや信頼性の課題には、バックエンドのいくつかの設計で対処しています。
- 長時間かかるジョブ: バックエンドは、60秒でタイムアウトする同期レスポンスを待つのではなく、非同期でリクエストを送ってステータスをポーリングします。コールドスタートで約7GBのモデルの重みをダウンロードしなければならない場合に重要です。
- クレジット: 残高を繰り返し読み込んで上書きするのではなく、追記専用の台帳に変動を記録します。アトミックなデータベース操作で十分なクレジットが残っているかを確認してから課金を記録し、Stripeの一意のイベントIDによって、重複して届いたWebhookでクレジットが二重に付与されるのを防ぎます。
- 転送: ウォーム時のベンチマークでGPU実行が300ミリ秒を下回っているため、ディスパッチや画像のシリアライズにかかる時間を減らすほうが、モデルをさらに調整するより応答速度の改善につながる可能性があります。
このサービスは登録時に5トークンを付与し、対戦1回につき1トークンを消費します。アップグレードでは500トークンを$9で提供します。対戦1回で画像を2枚リクエストするため、画像1枚の生成コストは対戦1回を提供するコストと同じではありません。GPU実行の試算にはアプリケーション運用の他の部分も含まれていないため、トークン価格と画像1枚あたりのベンチマークを完全な利益計算として扱うべきではありません。
サーバーレスGPUを選ぶ前に確認すること
RunPod Flashはデプロイ作業の多くを取り除き、ワーカーをゼロまでスケールダウンすればアイドル時のGPU料金をなくせます。最も有利なコスト結果は、ウォーム状態のトラフィック、高速な少ステップモデル、そして各リクエスト前後の課金時間に左右されます。すべてのリクエストでコールドスタートを避ける必要がある場合や、比較で挙げた月50枚で約$2のように、GPUインフラを構成する利点がほとんどない少量の場合には、ホスト型APIが引き続き現実的な選択肢です。
この方式を導入する前に、ウォーム時とコールド時のリクエストを分けて計測し、実際にデプロイするワーカー設定でアイドル時にどう課金されるかを確認し、ユーザーの1回の操作に含まれる2つのモデル呼び出しをどちらも数えましょう。そのうえで、$1あたり3,000枚という試算をサービス全体の予算として使うのではなく、得られたGPUの請求額をストレージやアプリケーションのコストと合わせて比較することが大切です。