YutoriのNavigator n2は、コンピューター操作エージェントを評価する際に、コストと信頼性を併せて見るべき理由を示しています。270億パラメータのこのモデルは、コンピューター操作のベンチマーク5件中4件で首位となり、OSWorld-v2ではタスク当たりのAPIコストが約$1.46でした。視覚情報に基づくコンピューター操作、コード実行、サービスへの直接呼び出しを組み合わせた設計を採用し、再帰的な学習パイプラインでエージェントの失敗を新たなタスクに変えています。
ベンチマークの数値が示すもの
OSWorld-v2では、Navigator n2の部分正解率は65.2%で、僅差の2位でした。このベンチマークには、人間なら1〜2時間かかると見積もられるデスクトップ作業が含まれます。報告されたコスト比較では、Claude 3.5 Sonnet、Claude Opus、GPT-4oなどの最先端モデルとn2を比べています。
| OSWorld-v2での比較 | 報告された結果 |
|---|---|
| Navigator n2 | タスク当たりのAPIコストは約$1.46、部分正解率は65.2% |
| 比較対象の最先端モデル | タスク当たりのAPIコストは約$15から$40超 |
同程度の正解率では、比較対象の最先端モデルはn2の約10倍のコストがかかりました。同じコスト予算では、n2のタスク完了精度は比較対象モデルの3倍を超えました。これらはベンチマーク上の比較であり、あらゆる導入環境でのコストや成功率を保証するものではありません。特に、$1.46という数値はタスク当たりのAPIコストであり、モデルの学習に必要な計算資源の費用ではありません。
Yutoriが示すNavigator n2のAPI料金は、入力100万トークン当たり$0.50、キャッシュ済みの入力100万トークン当たり$0.05、出力100万トークン当たり$4.00です。トークンはモデルが処理するテキストの単位です。これらの料金も作業のコストを見積もる材料になりますが、多くの操作を伴うエージェントを比較するには、ベンチマークのタスク当たりの数値のほうが直接的です。
コンピューター操作の方法を使い分ける
Navigator n2はコンピューター操作エージェントで、ウェブページの閲覧だけでなく、デスクトップソフトウェアやブラウザーをまたいで作業できます。設計上の中心は、タスクの途中で操作方法を切り替えることです。グラフィカルユーザーインターフェース(GUI)を確認・操作するほか、構造化された作業にはPythonやシェルのコマンドを作成・実行し、サービスがソフトウェアから直接接続できる手段を提供している場合はアプリケーション・プログラミング・インターフェース(API)を使います。
この使い分けは、有用なAPIがないサイトや、情報が画面上のピクセルとしてしか存在しない場合に重要です。50〜60ページのスキャンされた年次報告書を扱うタスクの実行例からは、それぞれの役割が分かります。PDFにはテキストレイヤーがなかったため、Navigator n2はまずGUIを通じて画像形式の財務表を確認しました。次にターミナルとPythonスクリプトを使い、数値と計算結果をExcelブックにまとめました。最後にLibreOffice Calcでファイルを開き、スプレッドシートとスキャンされた報告書を目視で照合しました。
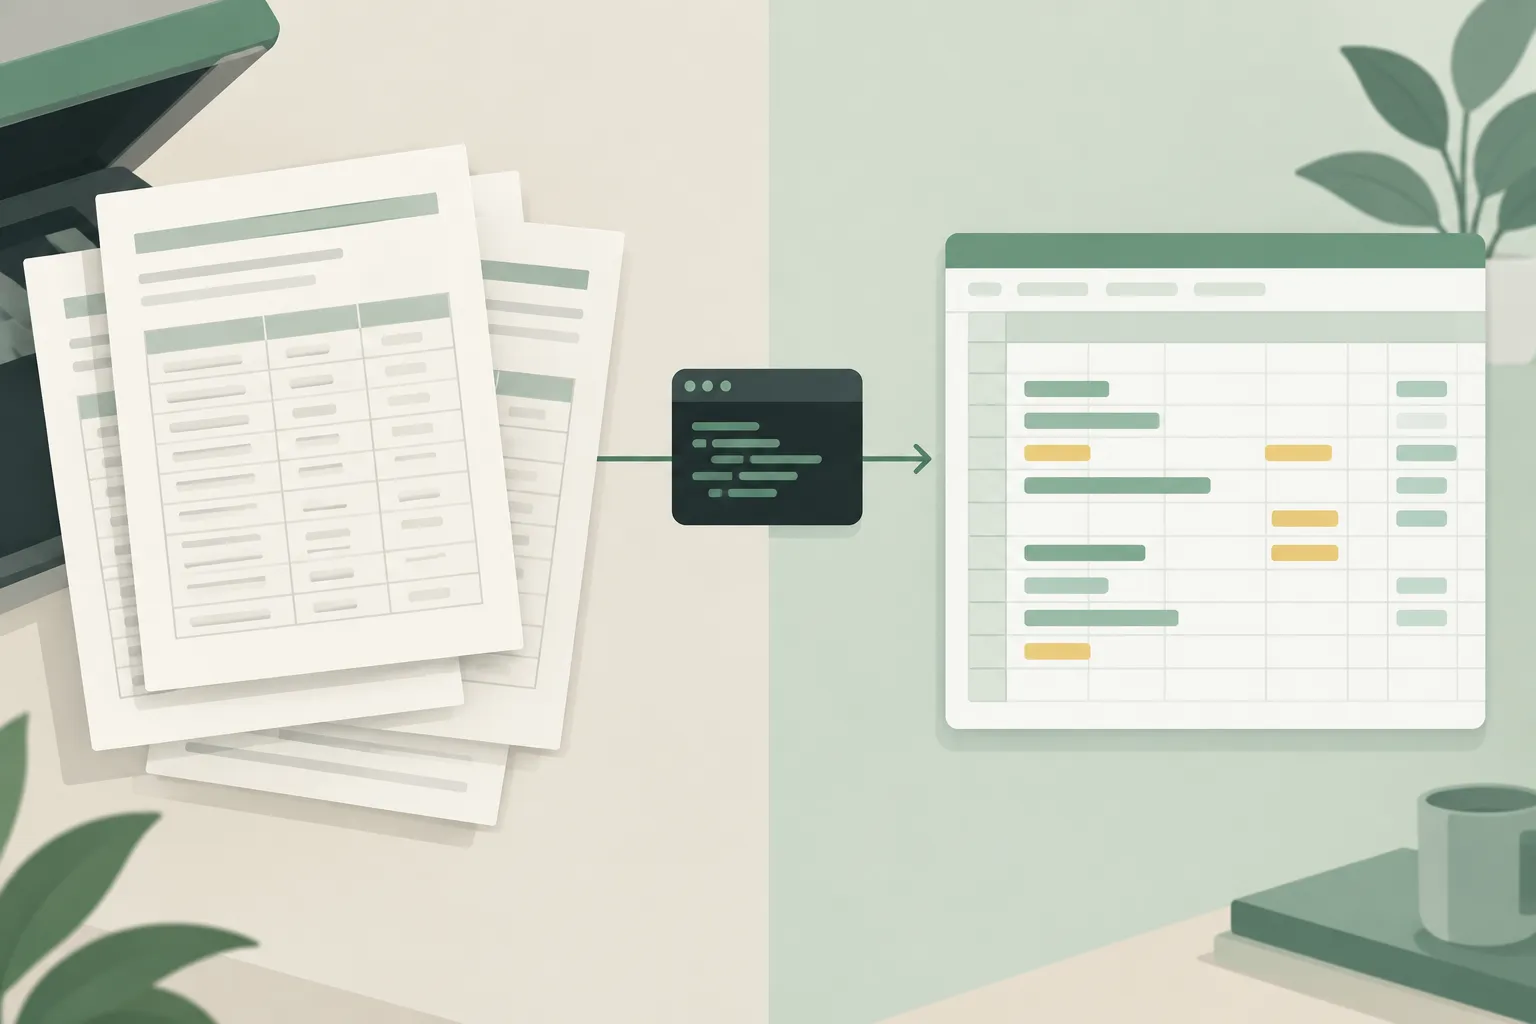
▲ スキャン報告書から表計算へ
ブックの作成にコードを使うことで、GUI上でセルを一つずつ入力する作業を避けられました。一方、作業の最初と最後には目視での確認が必要でした。同じ柔軟性はウェブインターフェースにも当てはまります。Navigator n2は画面のピクセルとページの構造化データの両方を使うため、ページのアクセシビリティ情報に役立つ項目がなくても、画面上に見える操作要素を特定できます。目的はクリック操作をなくすことではなく、必要な部分に限って使うことです。
実際の失敗を起点にした学習ループ
報告されたコストと性能の結果は、実行時の戦略だけによるものではありません。Yutoriは、完成したモデルの実行時だけでなく、再帰的なデータパイプラインの全工程でコンピューター操作エージェントとコーディングエージェントを使っています。このパイプラインは数週間で、数百のデスクトップアプリとブラウザーアプリにわたる、検証済みのタスクと環境を1万件以上生成しました。
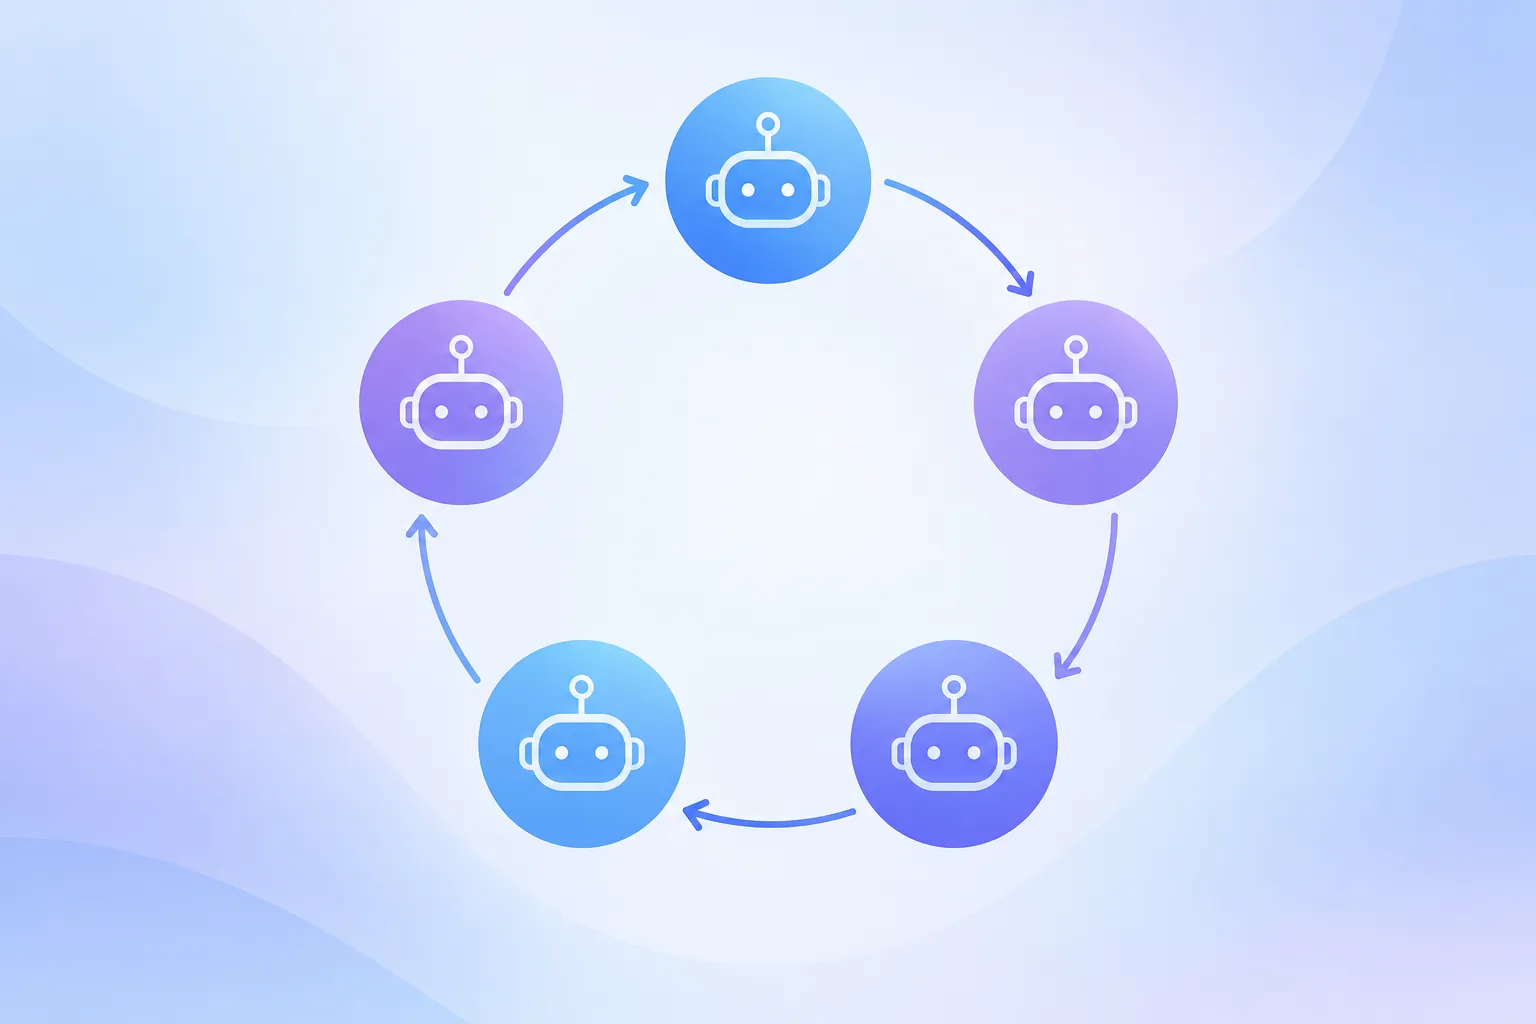
▲ タスク生成と学習の再帰ループ
このループは、つながり合う5つの段階で構成されます。
- タスク作成: エージェントが実際の仮想マシン環境を探索し、意図した結果が得られたかを確認するスクリプトとともにタスクを作成します。仮想マシンはソフトウェア上で動くコンピューターで、ここではタスク環境として使います。
- ストレステスト: 複数回の試行を通じて、判定を誤って通過するケースや誤って失敗とされるケース、環境の不備、タスクの意図を達成せずにテストを通過する方法がないかを調べます。
- モデルの学習: 成功したタスクの実行結果をファインチューニング用の事例とし、強化学習ではさらに試行を重ねて動作を検証・改善します。
- 失敗の分析: エージェントが終了した試行のエラーを分類し、スプレッドシート用スクリプトの作成やスライドの書式設定が苦手といった、繰り返し現れる弱点を見つけます。
- 次のラウンドの生成: そうした弱点を、次のタスクと判定方法の作成に反映します。
判定方法は特に重要です。不備のあるテストが未完了の結果を評価してしまえば、学習によって誤った動作が強まるおそれがあります。そのため、事例の数を最大化するよりも、成功と判定された実行結果を監査し、疑わしい事例を除外することのほうが重要かもしれません。
時々の成功を、安定した試行へ
Yutoriは2つの学習手法を交互に使います。棄却サンプリングによるファインチューニング(RFT)は、多数の実行結果から選んだ成功例を使って学習します。基本的な能力を育て、複数回試行したときの成功確率を示すpass@kを高めます。初期のタスクが難しすぎて成功例を得られない場合は、プロンプトに小さなヒントを加えて事例を生成することもできますが、その事例は慎重に監査する必要があります。
強化学習(RL)は、その潜在的な能力を、初回の試行での成功を示すpass@1の向上につなげることを目指します。また、想定外のダイアログ表示、クラッシュ、遅延にエージェントを直面させ、復旧の動作を学習できるようにします。Yutoriはこの段階で中程度の難易度のタスクを残し、モデルが必ず完了できるものと、まったく完了できないものを除外します。両極端の間にあるタスクのほうが、学習に役立つフィードバックを得られます。
RLの段階では、YutoriはMilesフレームワークを用いた非同期のGroup Relative Policy Optimization(GRPO)を使います。この構成では、モデルの更新と並行してタスクの試行を実行し、学習に利用できる試行の古さに上限を設けます。動的サンプリングによって、モデルの改善に応じてタスクの構成を調整します。また、推論時の設定に合わせて16ビットの数値形式であるfp16で学習し、学習時と導入後の推論時で数値精度が食い違うのを避けています。
エージェント導入前に確認すべきこと
有用な評価には、単一のベンチマークスコア以上の情報が必要です。開発者や企業は、求める品質水準で完了したタスクのコストを比較したうえで、エージェントが適切なツールを選び、エラーから復旧できるかを確認できます。トークン単価が低いだけでは、作業全体のコストは分かりません。
タスクの内容も重要です。直接のAPI呼び出しはAPIを提供するサービスに、スクリプトはデータの変換に適している場合があります。一方、スキャンされた資料やAPIのないサイトでは、GUI操作を避けられない場合があります。購入やフォームの送信ができるエージェントでは、支出の上限と明確な承認の範囲にも注意が必要です。意図しない自律的な購入が発生した場合に誰が責任を負うかは、なお未解決の問題です。また、ウェブサイト側のボット対策によって、自動化された作業を実行できるかどうかも左右されます。
要点
Navigator n2の結果は、特化型モデルが難度の高いコンピューター操作タスクで競争力を持ちながら、報告されたベンチマークのタスク当たりコストを下げられる可能性を示しています。学習ループは多様で検証済みのタスクを供給し、実行時にはGUI、コード、APIをそれぞれ適した場面で使えます。導入前にはベンチマークの順位だけで判断せず、実際に必要な業務でこの組み合わせを試し、タスク当たりのコスト、タスクの結果、ツールの選択、エラーからの復旧を測定することが重要です。