ローカルAI用のハードウェアは、読み込めるモデルの大きさと、応答の速さという二つの要素を決めます。比較的安価なNVIDIA RTX 3060でも、80億パラメータのモデルを毎秒40〜50トークンで動かせます。一方、高価なシステムなら、はるかに大きなモデルを載せられます。適切な予算は、小さめのモデルで素早い回答を得たいのか、複雑なタスクでより高い性能が必要なのか、あるいは非常に大きなモデルを自分のマシン上で動かしたいのかによって変わります。
メモリ容量が上限を決め、帯域幅が速度を決める
ローカルAIモデルは、数値で表された重みを保存したものです。推論ランタイムは、その重みを読み込んで応答を生成するソフトウェアで、計算を手元のデバイス上で行います。完全にローカルな構成なら、モデルも、それを使うソフトウェアもオフラインで動作します。ただし、見た目はローカルで動くアプリでも、必ずしもすべての処理がローカルで完結するわけではありません。例えばCursorやClaude Codeは、PC上で動作しながら、プロンプトやプロジェクトのコンテキストをクラウド上のモデルに送ることがあります。
ハードウェアを選ぶ前に、高速なメモリの容量を確認しましょう。専用GPUならグラフィックスカード上のメモリであるVRAM、Apple Silicon搭載Macなら共有メモリであるユニファイドメモリです。モデルは、そのメモリに余裕を持って収まる必要があります。つまり、容量がモデルの大きさの上限を決めます。一方、メモリ帯域幅は、システムがメモリからデータを転送する速度で、生成速度を大きく左右します。トークンはモデルが生成する文章の小さな単位なので、毎秒何トークンを生成できるかは応答速度の目安になります。
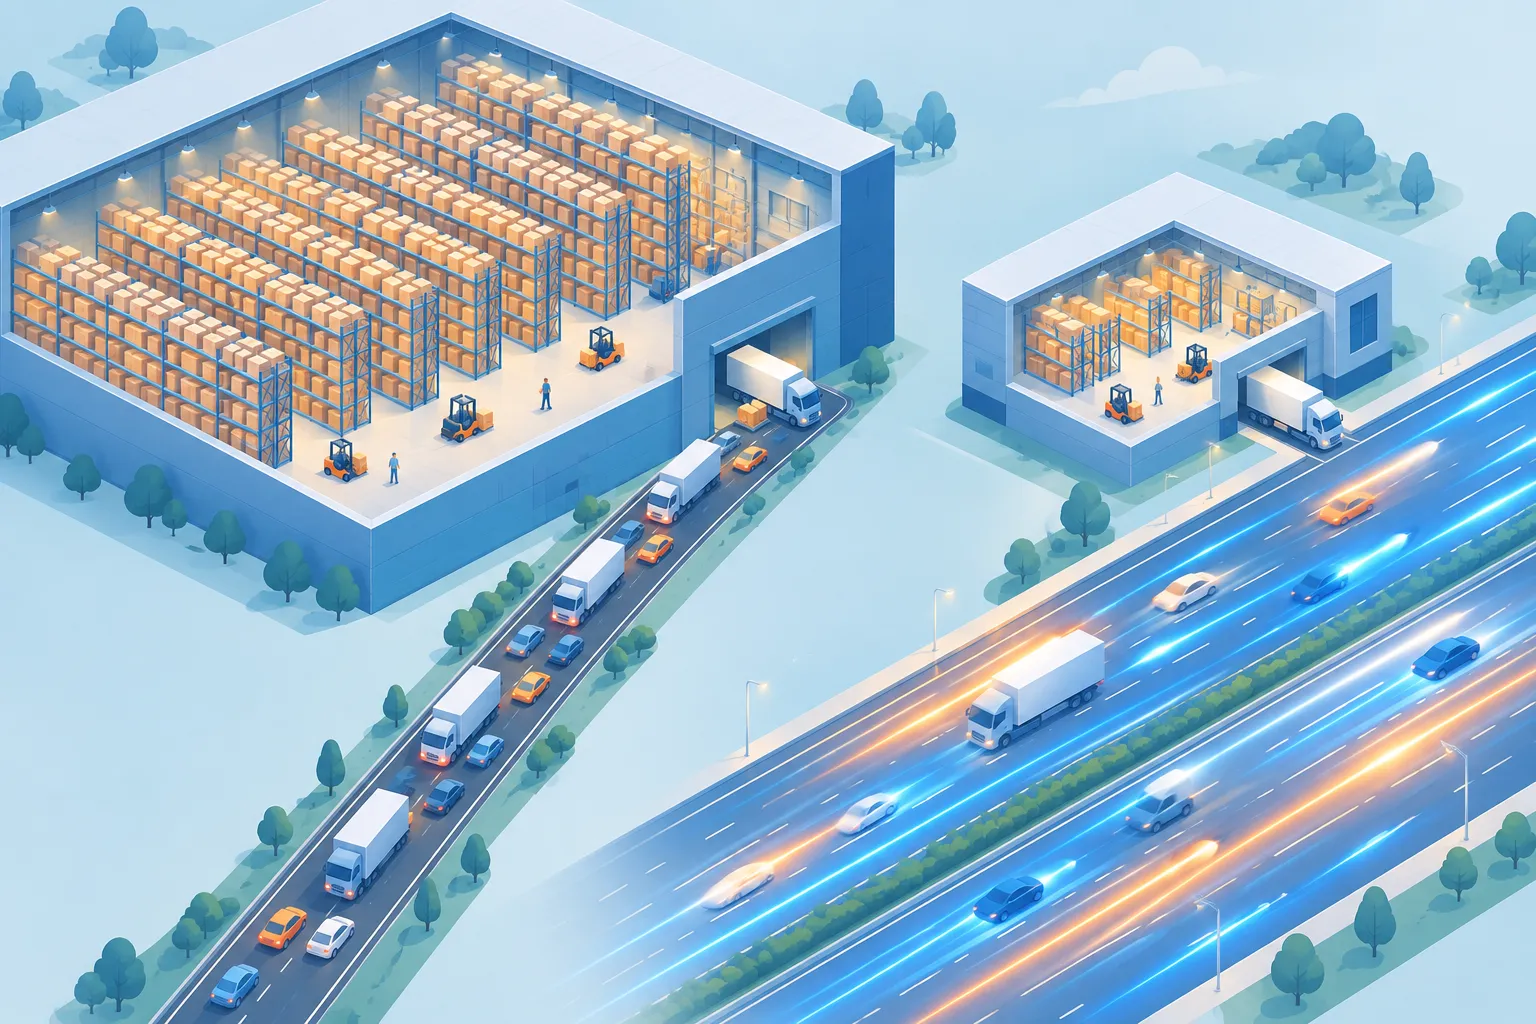
▲ メモリ容量と帯域幅の対比
この二つの制約によって、有利なマシンは変わります。NVIDIA RTX 4090は24GBのVRAMを備え、メモリ帯域幅は毎秒1テラバイトを超えます。Apple Silicon搭載Macには64GBまたは128GBのユニファイドメモリを備えた構成もあり、より大きなモデルを収められます。ただし、標準構成の帯域幅は上位の専用GPUの約20〜30%です。容量が大きくても、文章を速く生成できるとは限りません。
マシンに収まるモデルを選ぶ
モデル名を見れば、必要なハードウェアの目安が分かります。Qwen 3.8 27B Q4では、Qwenがモデルファミリー、3.8がリリース、27Bが270億個のパラメータ、つまり保存された重みの値を表します。Q4は4ビット量子化を意味し、重みを低精度で保存してファイルサイズとメモリ使用量を減らします。Q4による圧縮では、出力品質をほとんど損なわずに、モデルを非圧縮時の約4分の1のサイズにできます。
Qwen 3.5 4Bのような小規模モデルに必要な保存容量は約1〜2GBで、手軽な出発点になります。より高性能なローカル環境を目指すなら、一般に80億〜350億パラメータが現実的な目標です。量子化しても、パラメータ数が増えれば通常はより多くのメモリと計算能力が必要になります。
もう一つ知っておきたいモデルの設計がMixture of Experts(MoE)です。専門分野ごとに分かれた重みの一式をメモリに保持しながら、各トークンの計算にはその一部だけを使います。そのため、総パラメータ数から想像されるよりも生成が速い場合がありますが、モデル全体をメモリに収める必要がなくなるわけではありません。Qwen 3.5 122B MoEは、入門用PCよりもはるかに大きなメモリ容量を持つハードウェア向けの一例です。
予算を3段階に分けて見る性能の目安
以下の価格は記載したハードウェアのもので、PC一式を組む費用を保証するものではありません。2026年のRAM不足のなか、価格も変動しています。固定的な価格より、メモリの仕様と動かせるモデルを重視すべきです。
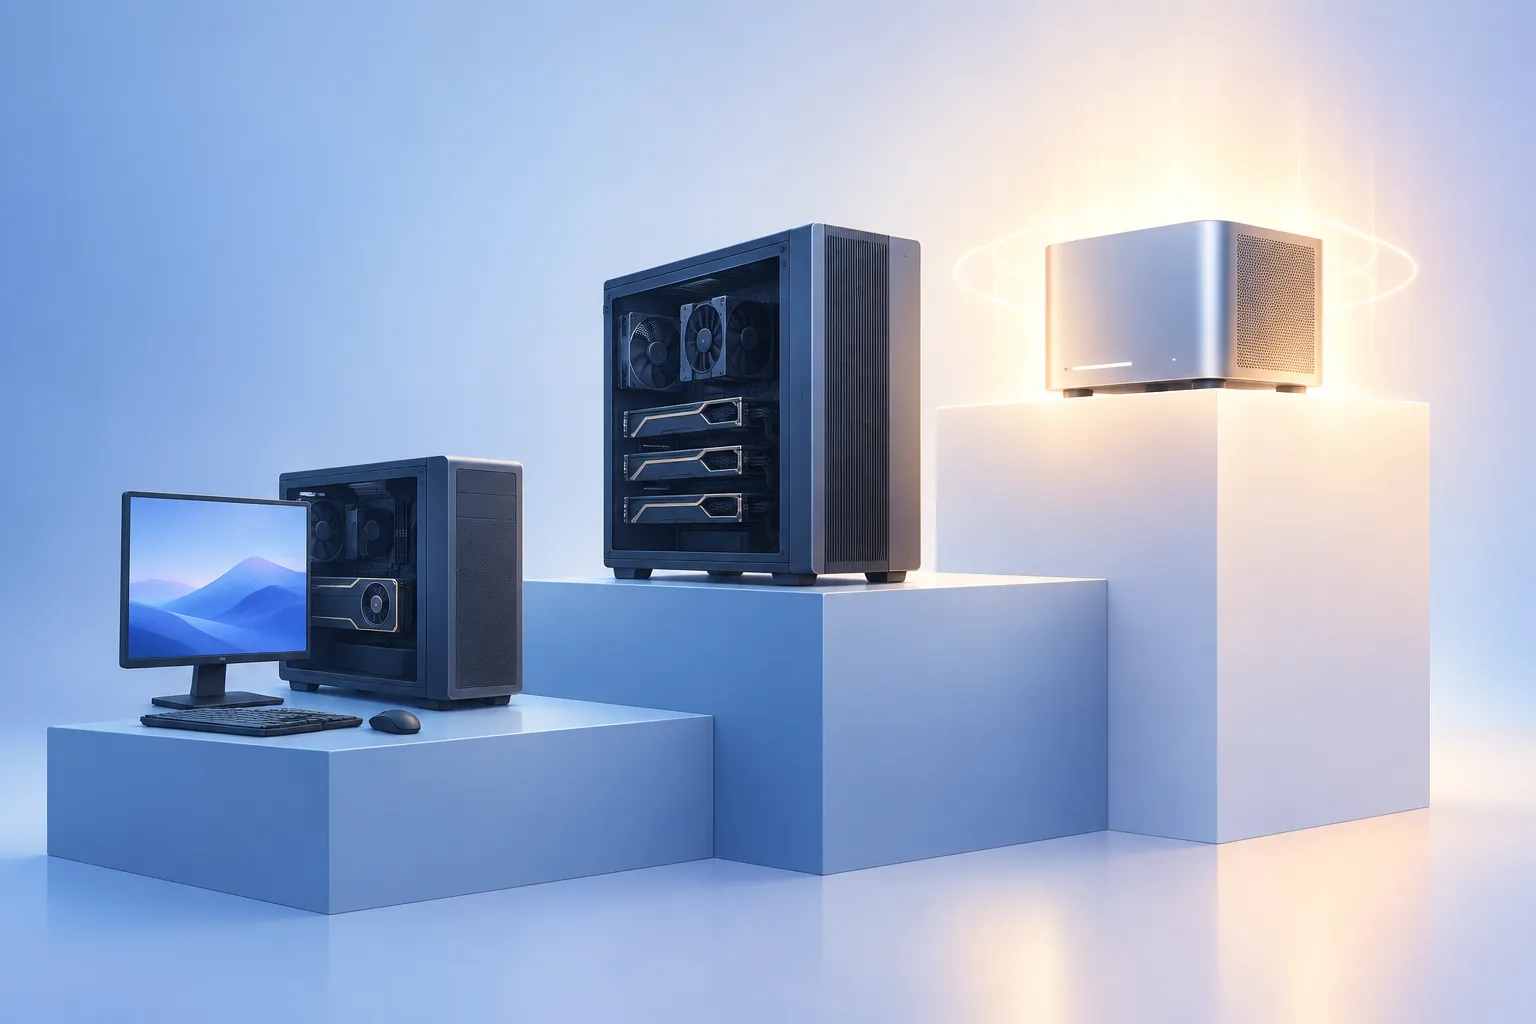
▲ ローカルAI用ハードウェアの3段階
ここで示す具体的な速度の数値は、RTX 3060で80億パラメータのモデルを動かした場合と、NVIDIA DGX Sparkでより大きなモデルを動かした場合に限られます。中価格帯は実用的な応答速度とされていますが、毎秒のトークン数は示されていません。他の価格帯の数値から速度を推測すべきではありません。
| 価格帯 | ハードウェアと記載価格 | メモリと実際に期待できる動作 |
|---|---|---|
| 低価格帯 | NVIDIA RTX 3060:中古で約$300 ~ $400。新たに製造されたカードの公称希望小売価格は$339。標準構成のApple Mac mini:約$799 ~ $800。 | RTX 3060は12GBのVRAMを備え、Q4の80億パラメータモデルを毎秒約40〜50トークンで動かせます。Mac miniでも80億パラメータモデルを動かせますが、速度はやや低く、具体的な数値は示されていません。 |
| 中価格帯 | NVIDIA RTX 3090:カード単体で約$800 ~ $1,000。M4 Pro搭載Mac mini:約$1,800。 | RTX 3090は24GBのVRAM、Mac miniの構成は48GBのユニファイドメモリを備えます。どちらもQ4の270億パラメータモデルを実用的な応答速度で動かせます。 |
| 高価格帯 | AMD Strix Halo搭載ミニPC:約$2,500。M5 Max搭載、メモリ128GBのMac Studio:約$2,499。NVIDIA DGX Spark:約$5,000。M5 Ultra搭載Mac Studio:約$5,499。 | 約1,200億パラメータのモデルを動かすため、高速なメモリを約128GB確保することが目標です。DGX Sparkのテストでは、1,200億パラメータモデルが毎秒約40トークン、350億〜700億パラメータモデルが毎秒60〜90トークンを生成しました。 |
低価格帯は、内容を外部に出さずに行う下書きの作成、要約、文書の確認に適しています。ただし、複雑で複数の段階を要するコーディングエージェントには十分とはされていません。ローカルのコーディングエージェントを含む、負荷の高い開発作業に270億パラメータモデルを使うなら、中価格帯がより現実的な最低ラインです。この価格帯の二つの選択肢には、容量と速度のトレードオフがはっきり表れています。Mac miniはメモリ容量が大きく、専用GPUは帯域幅で有利です。
高価格帯では、128GBを目標にすることで、はるかに大きなモデルを動かせます。ただし、DGX Sparkの数値は、速度を考えるうえでもモデルの大きさが重要なことを示しています。350億〜700億パラメータモデルは、1,200億パラメータモデルよりも毎秒の生成トークン数が多くなりました。M5 Ultra搭載Mac Studioのメモリ帯域幅は標準構成のMacの4倍とされ、ユニファイドメモリで通常生じる速度面の制約を一部解消します。ただし、この仕様はトークン生成速度の実測値ではありません。
トレードオフに見合うか判断する
まずは、手元のマシンのVRAMまたはユニファイドメモリの正確な容量を確認しましょう。次に、余裕を持って収まるモデルを選びます。一般消費者向けハードウェアでメモリ使用量を抑える必要があれば、Q4版を選びます。Ollamaはコマンドラインでのモデル管理、Docker Model Runnerはコンテナ化されたワークロードの実行、LM Studioはグラフィカルな操作画面を提供します。これらのランタイムは、ローカルモデルを他のアプリケーションから利用できるようにすることも可能です。選んだ構成が完全にローカルで動くか確かめるには、Wi-Fiを切断しても動作するか確認してください。
完全にオフラインの構成なら、ローカル実行によってプロンプトをデバイス内にとどめられ、モデル利用のための継続的なサブスクリプション料金もかかりません。ただし、十分な性能のハードウェアには高額な初期費用が必要です。厳格なローカルでのプライバシー確保を必要としない通常の作業なら、月額$20 ~ $60のクラウドサービスのサブスクリプションのほうが、モデルの性能が高く、導入の手間も少ない場合があります。プライバシーのためにローカル推論が必要なら、まず用途を定め、モデルの大きさを選びましょう。そのうえで、モデルを収めるためのメモリ容量と、快適な速度で使うための帯域幅の両方を基準に、ハードウェアを購入してください。