让AI智能体按唱片公司统计总播放量,它可能会信心十足地给出一个比实际高出近2.5倍的数字。原因往往并非幻觉,即模型编造出看似合理却错误的内容,而是查询在连接多张相关表时产生了重复行。BigQuery Graph的measure在数据模型层面解决这一问题:只需定义一次计算,并将其绑定到所描述的实体上,此后无论查询出自人手还是AI智能体,每个项目都只会被统计一次。
不报错却算错的总数
以一家音乐公司的小型曲库为例:五首歌曲、演唱这些歌曲的艺人、两家唱片公司,以及收录这些歌曲的四个外部歌单。其中一家唱片公司,暂称为唱片公司A,拥有四首歌曲。
| 歌曲 | 播放量 | 收录歌单数 |
|---|---|---|
| 歌曲1 | 20亿次 | 4 |
| 歌曲2 | 15亿次 | 2 |
| 歌曲3 | 12亿次 | 1 |
| 歌曲4 | 4亿次 | 1 |
| 合计 | 51亿次 | - |
手工相加,唱片公司A的播放量为51亿次。然而,用Agent Development Kit(ADK,一套用于构建AI智能体的工具包)搭建的分析助手,对同一问题给出的答案却是126亿次。
更危险的是,底层查询不会报任何错误。SQL语法完全正确,引擎照常执行,不发出警告。在包含数百万行的表中,几乎没有人会察觉数字被放大,用户最终会对一个严重错误的数字深信不疑。
一首歌如何被计算四次
数字膨胀源于连接扇出,即一行数据在连接后变成多行。跟踪歌曲1在查询中的变化,原理便一目了然:
- 连接之前,歌曲1在歌曲表中只有一行,播放量为20亿次。
- 将歌曲与歌单收录记录连接后,这一行按歌单数变成四行,每行都保留完整的20亿次。
- 执行SUM(streams)时,20亿次被加了四次,仅歌曲1就被记为80亿次。
- 歌曲2被两个歌单收录,15亿次变成了30亿次。
- 歌曲3和歌曲4各只出现在一个歌单中,12亿次和4亿次保持正确。
合计为126亿次,约为实际51亿次的2.5倍。只要在一对多关系(例如一首歌对应多条歌单收录记录)或多对多关系上连接后再对某列求和,就会出现同样的问题。
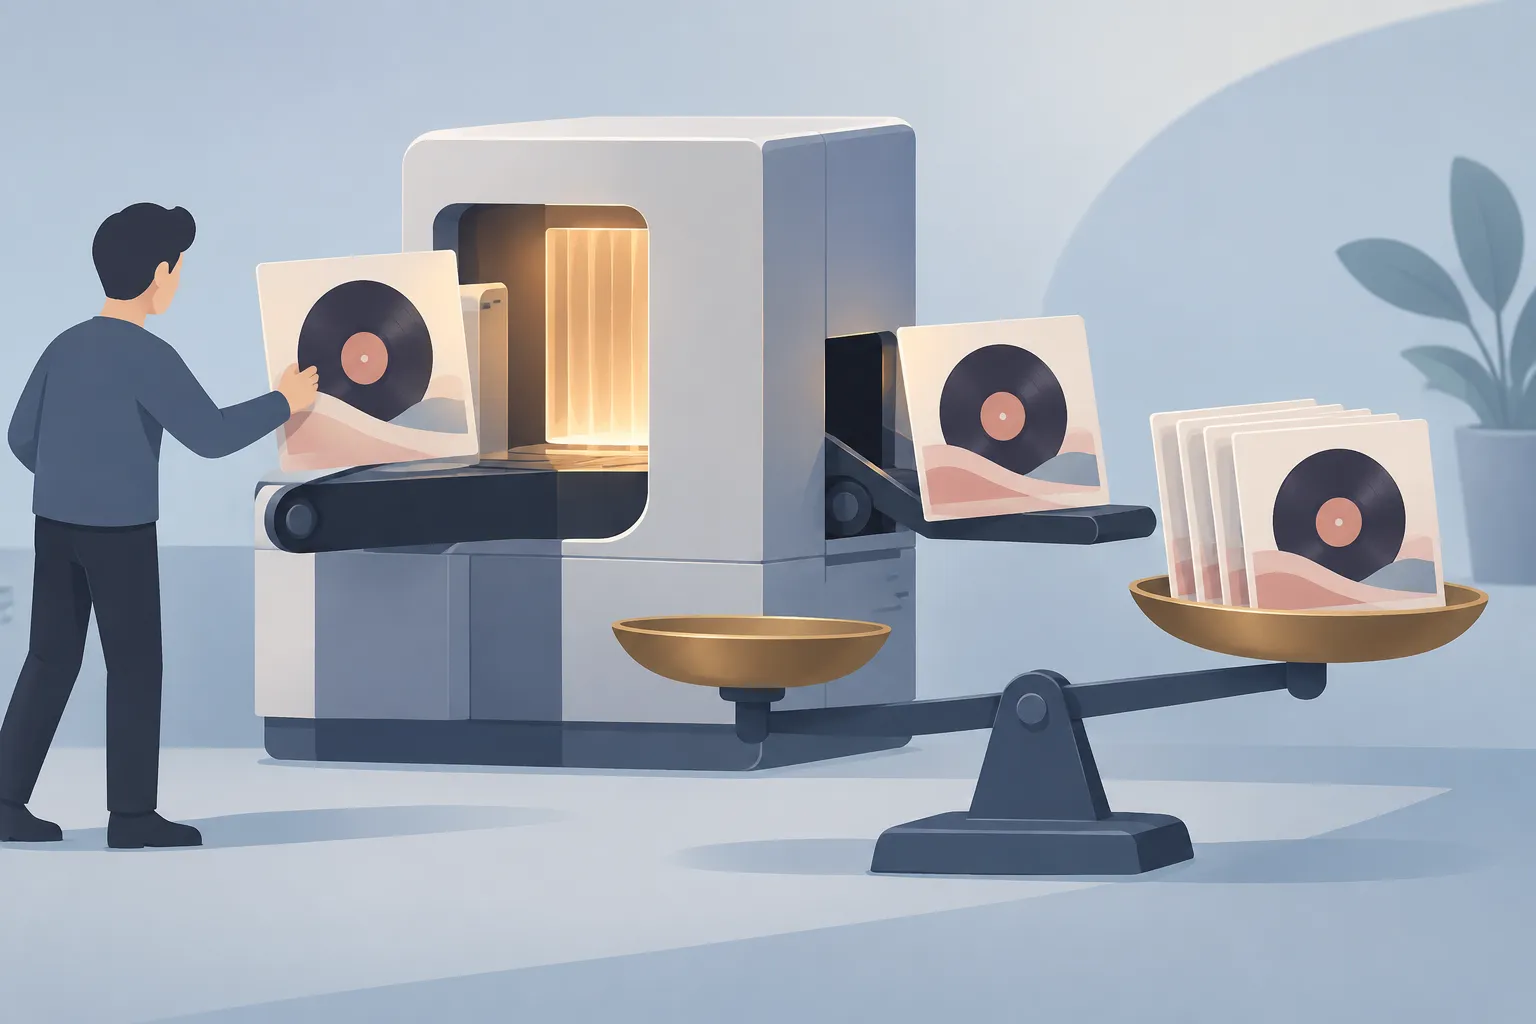
▲ 连接后产生的重复行
把规则放进模型,而非查询
当然可以在每条查询中都加入去重逻辑,但分析师或AI提示词迟早会忘记。BigQuery Graph则把这条规则移入数据模型,让任何人都无需记住它。整套方案由三部分组成:
- 源表:存放在BigQuery或云存储桶中的现有数据,无需复制或进行物理转换。
- 属性图:在这些表之上定义关系的一层。歌曲、艺人、唱片公司和歌单成为节点表,歌单收录记录则成为连接它们的边。
- measure:写入图定义中的可复用聚合规则,例如在歌曲节点上写入MEASURE(SUM(streams)) AS total_streams。其他实体也可以拥有自己的measure,例如在唱片公司节点上设置MEASURE(SUM(marketing_budget)) AS total_budget。
关键在于,measure绑定在实体的键上。当歌曲节点声明KEY (song_id)后,BigQuery会自动去重,无论查询按什么维度分组,都在组内将每首歌只计算一次。
在SQL中,先用GRAPH_EXPAND展开图,再调用AGG(Songs_total_streams)代替SUM(streams)。在同一数据上并排运行,SUM返回126亿次,而AGG准确返回51亿次。
一次定义,跨分组复用
measure无需为每个新问题重写。将GROUP BY和SELECT的维度从唱片公司名称切换为歌单名称,同一个AGG(Songs_total_streams)调用就能正确算出每个歌单的播放量。
AI智能体同样受益。再次提出最初的自然语言问题,助手现在会回答唱片公司A的播放量为51亿次。改变的不是提示词,而是数据模型。
总数无法揭示的信息
由于属性图保留了完整的网络结构(本例中为19个节点和22条边),用户不仅能读取数字,还能沿着数字背后的路径追溯。
询问唱片公司A的51亿次播放中有多少依赖于单个歌单,图会给出答案:47亿次,即92%,都经过同一个歌单,也就是四个歌单中规模最大、拥有3500万关注者的那个。这并不意味着这些播放全部来自该歌单内的播放,而是说明该唱片公司的曲库高度依赖单一分发渠道。
将这个歌单从图中切断,风险就变得具体:
- 唱片公司的8次歌单收录中有3次消失。
- 歌曲3不再被任何歌单收录。
- 图的边从22条减少到16条。
单一的总数会掩盖这种结构性依赖。保留扁平SQL连接所压缩掉的关系,似乎能让分析师和AI智能体都获得判断运营风险所需的背景信息。
▲ 播放量对单一歌单的依赖
构建所用的工具
设置属性图和measure有多种方式:
| 方式 | 作用 |
|---|---|
| BigQuery SQL | 用CREATE OR REPLACE PROPERTY GRAPH语句定义节点、键和measure |
| BigQuery Studio中的可视化建模器 | 以可视化方式构建节点、边和measure,无需手写DDL即可测试measure |
| Agent Development Kit | 将BigQuery Graph接入自行构建的AI智能体 |
| Knowledge Catalog | 自动登记图的元数据和架构,便于发现与治理 |
BigQuery内置的对话式分析智能体可用自然语言回答数据问题,它也能直接查询属性图,因此无需先自行搭建助手。
把数据交给智能体之前要检查什么
AI智能体给出的错误数字未必是模型的问题。连接会重复行并悄然放大总数;measure通过跟踪实体身份阻止这种情况;而一次定义的measure可用于此后的每条查询。可以从以下几点入手:
- 查找在一对多关系上连接后再对某列求和的查询,例如歌曲与歌单收录记录。
- 将常用指标作为measure移入属性图,并声明节点键。
- 让查询和智能体在GRAPH_EXPAND中用AGG调用measure,而不是使用SUM。
- 如果手写DDL有困难,可使用BigQuery Studio中的可视化建模器构建图并测试measure。
- 不要只看总数,还要借助图检查结果是否过度依赖单一渠道。