AlphaFold가 단백질 구조 예측의 판도를 바꾼 지 5년 남짓 지났지만, 단백질 접힘 문제가 끝났다고 보기는 이릅니다. Google DeepMind의 Pushmeet Kohli는 AlphaFold가 푼 것이 실험으로 밝혀 Protein Data Bank(PDB, 단백질 구조 공개 데이터베이스)에 쌓아 둔 정지 구조를 다시 맞히는 일이었고, 단백질이 몸속에서 실제로 어떤 모양들 사이를 오가는지는 아직 모른다고 강조합니다. 생물학을 이해하는 AI로 가려면 계산 자원과 데이터 규모를 키우는 것만으로는 부족하고, 어떤 데이터를 모을지, 사람의 지식을 모델에 얼마나 넣을지, 모델을 어떻게 믿을지를 함께 풀어야 한다는 것이 핵심입니다.
AlphaFold가 실제로 푼 문제
AlphaFold 2가 발표된 뒤 언론은 단백질 구조 예측이 풀렸다는 제목을 자주 달았습니다. 하지만 구조생물학자와 생물물리학자는 단백질의 움직임, 여러 형태 상태(conformation), 기능, 처음부터 새 단백질을 설계하는 de novo 설계를 여전히 대부분 풀리지 않은 문제로 봅니다.
Kohli의 설명은 과학의 돌파구가 보통 복잡한 대상의 한 단면을 떼어 내 측정하고 재현할 수 있는 진전을 만드는 방식으로 이뤄진다는 데서 출발합니다. AlphaFold가 떼어 낸 단면은 결정으로 만들어 PDB에 올린 정지 좌표였습니다. 이 예측은 제약과 생물학 연구 현장에서 실제로 쓸모가 컸지만, 정지 사진을 맞히는 것과 단백질이 계속 움직이는 방식을 이해하는 것은 다른 일입니다.
- 단백질은 단단한 블록이 아니라 유연하고, 세포 환경에 따라 모양을 바꾸는 큰 분자입니다.
- 일정한 모양 없이 흐트러진 영역(intrinsic disorder)을 가진 단백질도 많습니다.
- 환경마다 단백질이 실제로 어떤 구조 분포를 보이는지는 연구자도, 모델도 아직 완전히 알지 못합니다.
그래서 Kohli는 AlphaFold가 다 풀었다는 오해 때문에 구조 예측과 단백질 동역학 연구에 대한 지원이 줄어서는 안 된다고 말합니다. 생물학은 이제 겉을 긁기 시작한 단계라는 판단입니다.
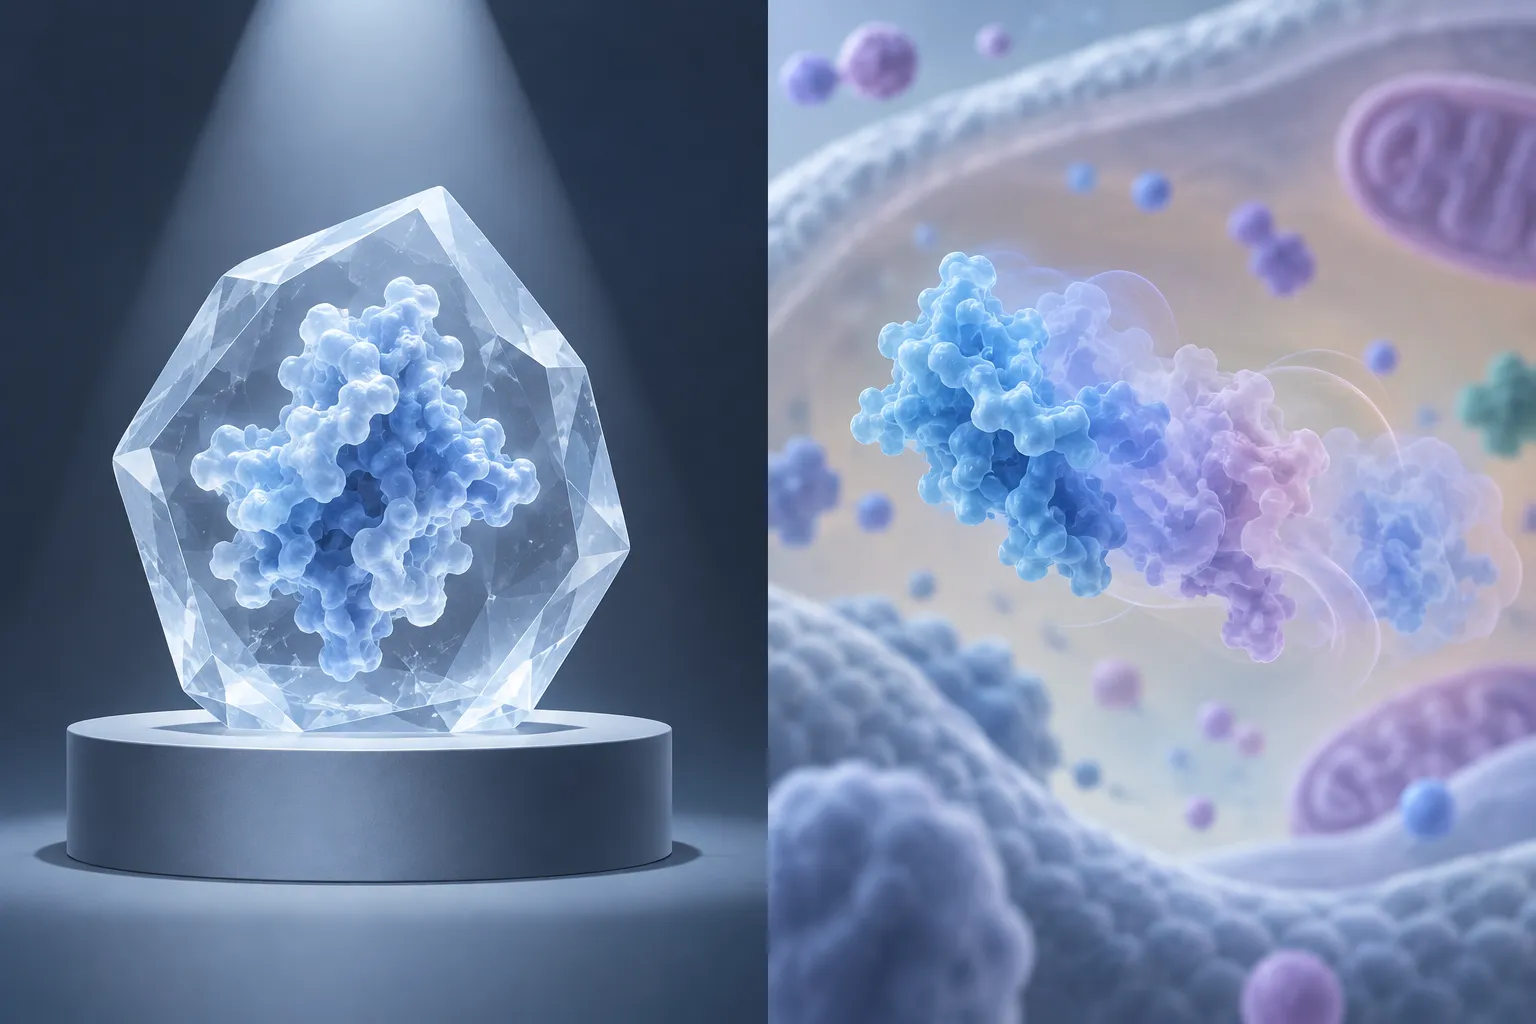
▲ 정지 구조와 실제 단백질의 움직임
규모를 키우면 풀릴까
AI 연구에는 Rich Sutton이 정리한 Bitter Lesson이라는 유명한 주장이 있습니다. 계산 자원과 함께 커지는 일반적인 방법이 결국 사람이 설계한 규칙을 앞선다는 것입니다. 그렇다면 생물학 데이터에도 같은 법칙이 통할까요.
Chan Zuckerberg Biohub(CZ Biohub)의 한 연구자는 scaling law(모델·데이터·계산량을 늘릴수록 성능이 일정하게 좋아지는 경향)가 어느 분야에서나 저절로 나타난다는 생각을 경계합니다. 실제 연구의 상당 부분은 scaling이 작동하는 모델 구조와 데이터 조건을 찾는 일이고, 그 조건을 찾은 뒤에야 성능 개선이 관리 가능한 엔지니어링 작업이 됩니다. 맞는 데이터 분포를 확보하는 것은 모델이 일반화하기 위한 필수 조건입니다.
흥미로운 사례는 단백질 언어 모델입니다. 깨끗하게 다듬은 전체 길이 서열만 쓰지 않고, 조각나고 불완전한 metagenomic(환경 시료에서 얻은 여러 미생물의 유전체) 서열을 대량으로 넣었더니 새 단백질을 설계하는 능력이 오히려 크게 좋아졌습니다. 반대로 쉽게 만들 수 있지만 쓸모가 적은 합성 데이터만 늘리면 막다른 길에 빠질 수 있다는 경고도 함께 나옵니다. 모델링하는 사람들은 이미 공개된 데이터를 그대로 쓰려는 경향이 있어, 정말 필요한 데이터가 무엇인지 따지는 일을 건너뛰기 쉽다는 지적입니다.
Kohli는 DeepMind에서 Sutton이 Bitter Lesson을 주제로 내부 강연을 하던 시기를 떠올리며 이 교훈을 다르게 읽습니다. 데이터에 관한 좁은 기술 주장이 아니라 교조적인 생각을 버리라는 경고라는 것입니다. 스스로를 모델 만드는 사람이나 실험 데이터 만드는 사람 한쪽으로만 규정하면, 과학적 의미와 상관없는 benchmark 점수를 올리는 데 매달리게 됩니다. 방법이 문제를 정하는 것이 아니라 문제가 방법을 정해야 합니다.
| 연구 과제 | 데이터 상황 | 선택 |
|---|---|---|
| AlphaFold 개발 | 실험 구조를 10배로 늘리는 것은 불가능 | 기존 PDB 구조로 학습 |
| 단일 세포 생물학, virtual cell | 공개 저장소의 데이터가 근본적으로 부족 | 새 생물학 데이터 생성에 자원 투입 |
사람의 지식을 모델에 얼마나 넣을까
AlphaFold 같은 초기 돌파구 모델은 구성 요소마다 공들인 설계가 들어갔습니다. 최근 AI의 흐름은 이런 수작업 대신 큰 계산량과 데이터로 밀어붙이는 일반적인 방법 쪽입니다. 두 방식에 대한 두 사람의 시각은 조금 다릅니다.
Kohli는 생물물리학과 생화학의 직관을 모델에 넣은 것이 우연한 선택이 아니었다고 말합니다. 아미노산 잔기가 서로 어떻게 영향을 주는지 알면 그 구조를 inductive bias(모델 구조에 미리 넣어 두는 가정)로 담을 수 있고, 모델은 기초 물리를 처음부터 다시 배울 필요가 없어 데이터 효율이 크게 오릅니다. 그는 좋은 데이터셋을 고르는 일도 그 자체로 하나의 기술이라고 봅니다. 같은 데이터를 더 많이 복제해 늘리면 성능은 거의 좋아지지 않고, 진전은 데이터의 다양성과 범위에서 나온다는 것입니다.
CZ Biohub 쪽은 데이터가 적을 때 inductive bias가 꼭 필요하다는 데 동의하면서도 한계를 짚습니다. 데이터가 커지면 모델이 사람이 예상하지 못한 패턴을 찾아낼 수 있는데, 가정이 틀렸거나 지나치게 딱딱하면 그 발견을 막고 성능의 상한을 만들 수 있습니다. 또한 규모를 키우는 일이 생각 없이 하는 작업이라는 시각에도 반대합니다. 생물학 기반 모델은 일반 transformer를 그대로 쓰지 않고 생물학 구조와 효율적인 추론에 맞게 고쳐야 하며, 안정적으로 키우는 일 자체가 깊은 알고리즘·시스템 기술이라는 설명입니다.
다음 돌파구 후보, cryo-EM 원본 이미지
단백질의 움직임을 풀 열쇠로 Kohli는 cryo-EM(극저온 전자현미경)으로 찍은 가공 전 원본 이미지를 꼽습니다. 컴퓨터 비전 연구 경험이 반영된 선택입니다. 지금 모델은 이미 처리를 거친 PDB 구조 하나를 정답으로 배우지만, 여러 상태가 섞인 원본 이미지로 직접 학습하면 단백질이 오가는 형태의 전체 지형과 그 사이의 전환을 담을 수 있다는 구상입니다.
CZ Biohub의 연구자는 지금의 정지 구조 예측 도구가 구조 기반 설계처럼 쓸모가 크지만 생물학의 아주 좁은 조각만 다룬다고 봅니다. 자전거 바퀴살 하나를 정밀하게 재현하는 수준인데, 생물학자에게 필요한 것은 자전거 전체, 나아가 픽업트럭 같은 복잡한 탈것을 설계하고 평가하는 모델이라는 비유입니다.
Richard Feynman의 말 “만들 수 없는 것은 이해하지 못한 것이다”도 새롭게 읽힙니다. 지금의 AI는 작동 원리를 다 이해하지 못한 상태에서도 기능하는 단백질을 설계해 내기 때문입니다.
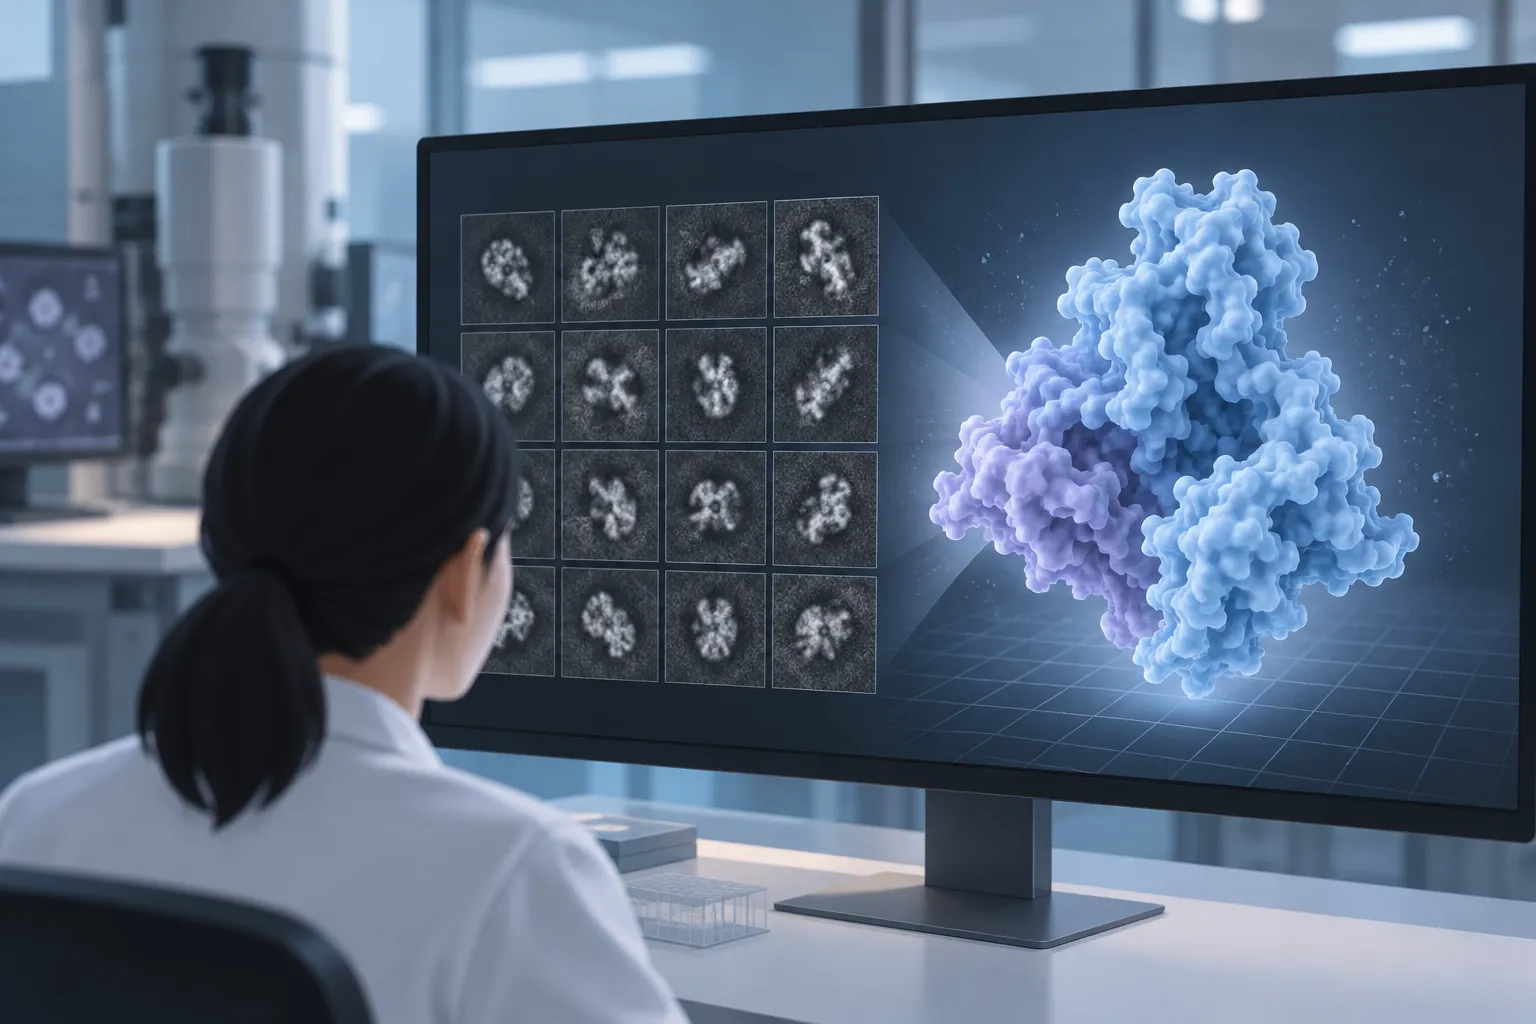
▲ cryo-EM 원본 이미지로 배우는 모델
블랙박스여도 될까
결합력이 매우 강한 단백질을 한 번에 설계해 주는 블랙박스라면 원리를 몰라도 괜찮을까요. CZ Biohub의 연구자는 생명공학이 AI 이전부터 블랙박스 방식의 설계를 써 왔다는 점을 인정하면서도, 모델에서 과학적 이해를 뽑아내는 일은 따로 중요하다고 말합니다. 단백질 언어 모델은 그럴듯한 서열만 만드는 것이 아니라 구조 제약, 움직임, 진화 정보를 안에 담고 있고, 내부 표현을 분석해 보면 기능 부위와 형태 변화가 실제로 들어 있다는 것입니다. 그는 이런 모델을 수십억 년의 진화를 압축한 세계 모델로 보며, 연구자가 아직 다 해독하지 못한 정보가 많다고 봅니다.
Kohli는 해석 가능성을 두 가지로 나눕니다. 모델 안의 작동 원리를 밝히는 것과, 모델이 어디서 잘 맞고 어디서 틀리는지 행동을 파악하는 것입니다. 그가 강조하는 쪽은 후자이며, AlphaFold 2가 좋은 예입니다.
- AlphaFold 2는 처음 공개될 때 구조 예측 benchmark에서 GDT(예측 구조와 실제 구조의 일치도 점수) 약 90점을 기록했습니다.
- 만약 95점짜리 모델이라도 pLDDT(예측마다 붙는 신뢰도 점수)가 실제 정확도와 맞지 않으면 위험하고 쓸 수 없습니다.
- 신뢰도가 틀리면 연구실은 자신 있게 틀린 예측을 검증하느라 몇 달에서 1년을 허비할 수 있습니다.
- AlphaFold 2는 신뢰도가 잘 맞았기 때문에 연구자들이 믿고 쓸 수 있었고, 공개 뒤 흐트러진 단백질 영역을 찾아내는 예상하지 못한 쓰임까지 발견됐습니다.
Kohli는 해석 가능성이 누구를 기준으로 하느냐의 문제이기도 하다고 말합니다. 사람의 작업 기억과 사고에는 한계가 있어, 여러 규모가 얽힌 생물학은 사람에게 직관적으로 설명되지 않을 수 있습니다. 그는 앞으로는 최전선 AI 모델이 특정 분야 모델의 내부 층을 직접 들여다보고 작동 원리에 대한 가설을 세우는 쪽이 될 수 있다고 내다봅니다. 두 사람 모두 모델의 능력과 한계를 충분히 파악하는 일이 생물학 연구에서 잘못된 배치를 막는 데 꼭 필요하다는 데 뜻을 같이합니다.
임상까지의 거리
Kohli는 AI가 언제 임상에 들어오느냐를 따지는 것 자체가 조금 어긋난 물음이라고 봅니다. AI와 머신러닝은 이미 전임상 신약 개발의 모든 단계에서 쓰이고 있기 때문입니다. 그가 구분하는 것은 지금의 점진적인 활용과, 표적 발굴·후보 물질 최적화·독성 평가를 10배에서 100배 빠르게 만드는 변화입니다. 후자는 좁은 기존 실험을 최적화하는 것으로는 오지 않고, 세포 생물학과 질병 기전의 근본 문제를 푸는 포괄적인 기반 모델이 있어야 가능하다는 것이 그의 판단입니다.
CZ Biohub의 연구자는 Google에서 배운 엔지니어링 원칙을 꺼냅니다. 10% 개선보다 10배 개선을 목표로 삼는 편이 오히려 풀기 쉽고 영향도 클 때가 많다는 것입니다. 10배를 목표로 하면 잘못된 가정을 버리고 문제를 첫 원리부터 다시 보게 되기 때문입니다. CZ Biohub는 사람의 질병을 치료하거나 예방하거나 관리하도록 돕는 것을 목표로 삼고 있으며, 이를 위해 당장의 실용적 성과와 장기적인 큰 도약을 함께 추구한다고 밝힙니다.
다만 여기서 말하는 것은 신약 연구 과정의 변화이며, 개인의 진단이나 치료에 바로 쓰이는 기술 이야기는 아닙니다. 건강에 관한 판단은 의료진과 상의해야 합니다.
정리, 생물학 AI 연구에서 먼저 따질 것
AlphaFold는 정지 구조 예측이라는 한 단면을 풀었고, 단백질의 움직임과 기능, 세포 전체를 이해하는 일은 이제 시작입니다. 생물학 AI를 연구하거나 도입하려는 사람이라면 다음을 먼저 따져 볼 만합니다.
- 풀려는 생물학 문제가 왜 중요한지, 어떤 구체적인 목표를 이룰지 먼저 정합니다.
- 진전에 필요한 것이 계산 자원인지, 모델 크기인지, 새 실험 데이터인지 초기에 따져 보고 가망 없는 방향은 빨리 접습니다.
- 데이터는 양보다 다양성과 범위를 보고, 정리되지 않은 대규모 자연 데이터도 시험해 봅니다.
- 데이터가 적으면 생물물리 지식을 모델 구조에 넣고, 데이터가 커지면 지나치게 딱딱한 가정을 다시 검토합니다.
- 정확도 점수보다 신뢰도가 실제와 맞는지를 먼저 확인하고, 실험에 쓰기 전에 모델이 틀리는 경우를 충분히 파악합니다.
- 정지 구조 저장소 밖의 cryo-EM 같은 1차 실험 데이터에도 눈을 돌립니다.