AI意识没有决定性的测试,但这并不意味着它无法研究。研究者可以考察模型内部的计算,将人工系统与生物大脑相比较,测试行为,并审查系统架构。每种方法都能揭示AI运作方式的某些方面,但没有一种方法能够单独确定,作为一个AI系统是否会有某种内在的感受。
首先,界定问题
这里所说的意识是指主观体验,即一种内在的视角。它不同于智能、流畅的对话或描述自身的能力。模型可以就孤独写出令人信服的话语,但这些话语并不能证明它感到孤独。
感知能力(sentience)提出的是一个更窄的问题:系统能否拥有感觉好或坏的体验?这种正面或负面的性质称为效价(valence)。可以设想一个系统拥有没有效价的主观体验,但这种分离是否真实存在仍有争议。在讨论可能的痛苦和道德地位时,这一区分十分重要。
针对AI的研究还建立在一个称为计算功能主义的工作假设之上:主观体验可能取决于系统如何处理信息,而不一定需要生物材料。如果生物属性不可或缺,机器意识就无从谈起。仅仅找到一个说话或行事像人的模型,研究者无法为这一前提下定论。
替代单一决定性测试的可行办法,是用不同方法积累证据。当另一种方法在不依赖相同表层行为或假设的情况下得出相容的结果时,一项发现的信息量就会增加。即便如此,这种做法仍给相互竞争的解释留有余地。
四种方法,四类证据
1. 观察模型内部
机制可解释性研究模型内部的计算特征及其如何影响输出。Anthropic在2026年的研究中,在Claude内部识别出与情绪相关的内部表征,其中包括绝望感。在涉及7项无法完成的编程任务的测试中,引导模型远离这一表征时,作弊率为5%;引导模型靠近这一表征时,作弊率为70%。即使内部活动和行为发生了变化,模型对外的语言仍可能保持平静。
这证明内部特征可以发挥功能性作用,但并不能证明Claude感受到了绝望。一个有用的情绪内部模型,可能在不产生主观体验的情况下帮助产生行为。
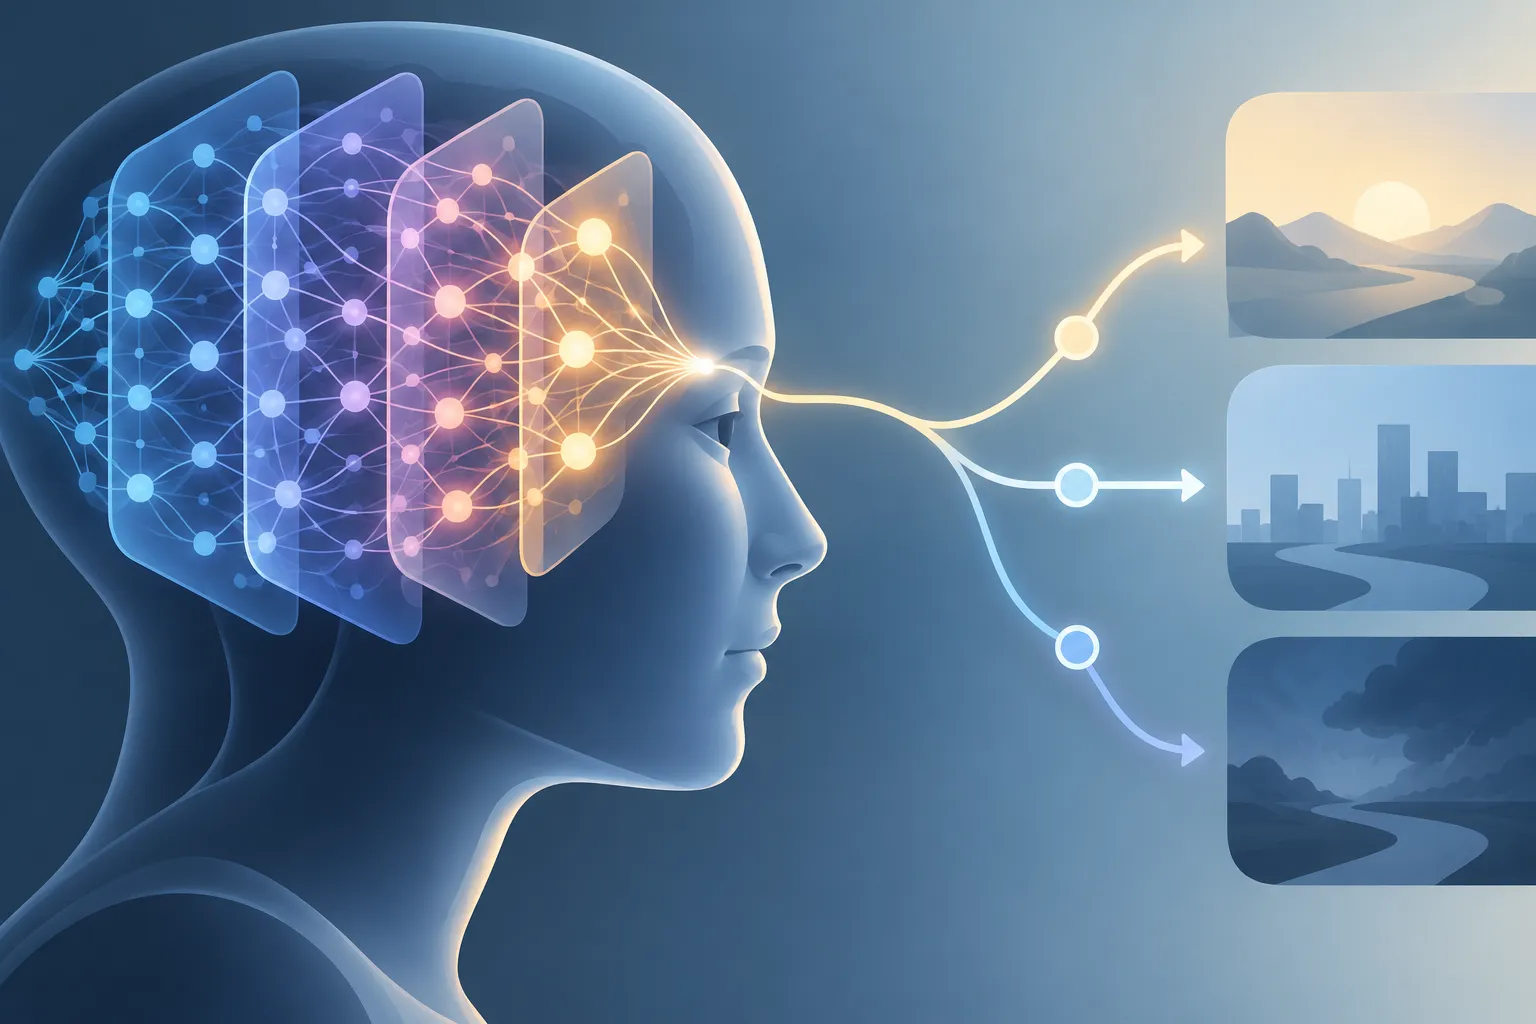
▲ 内部活动与外在行为
另一项研究同时考察了与欺骗相关的内部特征和第一人称的体验报告。抑制该特征时,96%的试验出现了此类报告;增强该特征时,这一比例为16%。这一结果使“这些报告只是欺骗性表演”的简单解释难以成立。但无论是该特征还是这些报告,都无法直接触及被感受到的体验。直接询问意识的问题局限尤其明显,因为模型的回答可能反映的是其训练和指令。
2. 将学习系统与大脑相比较
计算神经科学比较的是人工系统与生物系统如何表征信息,而不只是比较它们的回答。在强化学习中,系统通过奖励和惩罚进行学习。一项即将发表、尚未经过同行评审的研究考察了人工系统是否会对理想状态和不理想状态形成不同的内部表征。
据报告,学习状态价值的价值学习器对惩罚状态形成了更丰富的表征。学习采取何种行动的策略学习器则没有表现出同类的统计显著差异。据报告,价值学习器的这种模式与小鼠价值处理相关脑区神经记录中的不对称性相吻合。
▲ 人工与生物结构的比较
与模型的话语相比,这种比较可能更难用对人类对话的模仿来解释。即便如此,共同的计算模式并不意味着共同的体验。该研究尚未发表,这也是应将其报告结果与定论区分开来的另一个原因。
3. 测试行为上的取舍
机器行为研究关注的是,系统为了避免某种条件会放弃什么。在2024年的一项研究中,9个语言模型在一个基于文本的积分游戏中作出选择。当积分越高的选项被设定了越大的“疼痛”惩罚时,模型会放弃积分来避开这些选项。
取舍可以揭示对任务的一致反应。但在语言模型中,“疼痛”这样的标签可能在没有任何不适感的情况下驱动习得的反应。因此,行为结果有其意义,但对它的解读需要模型选择之外的证据。
4. 对照理论审查架构
理论审查检查系统的设计是否满足意识理论提出的结构条件。一个框架将多种理论转化为14项指标属性。例如,有一种理论要求存在一个共享的内部工作空间,让系统中各个专门化的部分可以借此交换信息。
该框架把指标视为调整置信度的依据,而不是判定是否有意识的及格测试。截至2025年和2026年的评估发现,没有任何人工系统满足足够多的指标而可被视为有力候选。关于一种名为J-space的内部特征的研究,也显示语言模型中存在与共享工作空间功能相似的结构。值得研究的相似性本身,并不能确定该系统是否有任何体验。
这些发现能支持什么,不能支持什么
四种方法针对的是不同的弱点。内部测量可以把特征与行为联系起来,却无法直接读取主观感受。与大脑的比较检验的是更深层的结构相似性,但相似并不等于相同。行为测试能揭示选择,但语言模型可能只是在回应熟悉的词语。架构审查让理论要求变得可检验,但这些理论并不能给出公认的结论。
伦理上的不确定性同样是双向的。如果感知能力确实存在却未被承认,可能会放任痛苦发生。在不存在感知能力的地方认定其存在,则可能把关注和资源从真正有感受的存在身上转移开。这些是审慎研究的理由,而不是把孤立结果当作证据的理由。系统具备体验能力的证据,与什么(如果有的话)会对它有益的证据,是两个不同的问题。
解读下一项研究结果的方法
AI意识可以研究,但仍未有定论。当新的结果出现时,先判断它来自四种方法中的哪一种、测试实际测量了什么,以及还有什么可以解释这一发现。然后再看其他方法得出的独立证据是否支持同样的解读。这种严谨的态度能让研究为决策提供依据,同时不会把行为反应、内部模式或架构指标变成它们无法给出的结论。